「このAIにはガードレールが設けられている」「ガードレールを強化した」。
AIの安全性について、ガードレールという言葉を見かけます。
道路のガードレールが車の逸脱を防ぐように、AIのガードレールは、AIが危険な方向に出力するのを防ぐ安全装置を指します。
AIが越えてはいけない一線を引き、そこから外れないようにする仕組みのことです。
本記事では、ガードレールが何を防ぐのか、どんな仕組みで働くのか、そして業務でAIを使うときに自分で設けるべきガードレールまでを解説します。
ガードレールとは何か
まず、この安全装置が何を守っているのかを押さえます。似た言葉である「アライメント」との関係も、ここで整理します。
越えさせない仕組み
AIは、指示次第で幅広い出力ができます。その自由度は長所ですが、放置すれば危険な出力にもつながります。
ガードレールは、この出力にしてはいけないことの枠を設けます。
道路のガードレールが通ってよい範囲を物理的に区切るように、AIのガードレールは出力してよい範囲を区切ります。
車が自由に走りつつ崖から落ちないのと同じで、AIが幅広く応答しつつ危険な一線は越えない。これがガードレールの役割です。
何を防ぐのか
具体的には、次のような出力を防ぎます。
- 犯罪や危害の手助けになる情報
- 差別的、攻撃的な表現
- 個人情報やプライバシーの侵害
- 誤った医療や法律の断定的な助言
アライメントとの関係
ガードレールは、AIを人間の意図に沿わせる取り組みであるアライメントの中でも、越えてはいけない一線を守らせる具体的な部分を担います。アライメントという大きな目標の、実装の一つがガードレールだと考えてください。
アライメントについては以下の記事で詳しく解説しています。
→ アライメントとは|AIを「人間の意図に沿わせる」という課題
どんな仕組みで働くのか
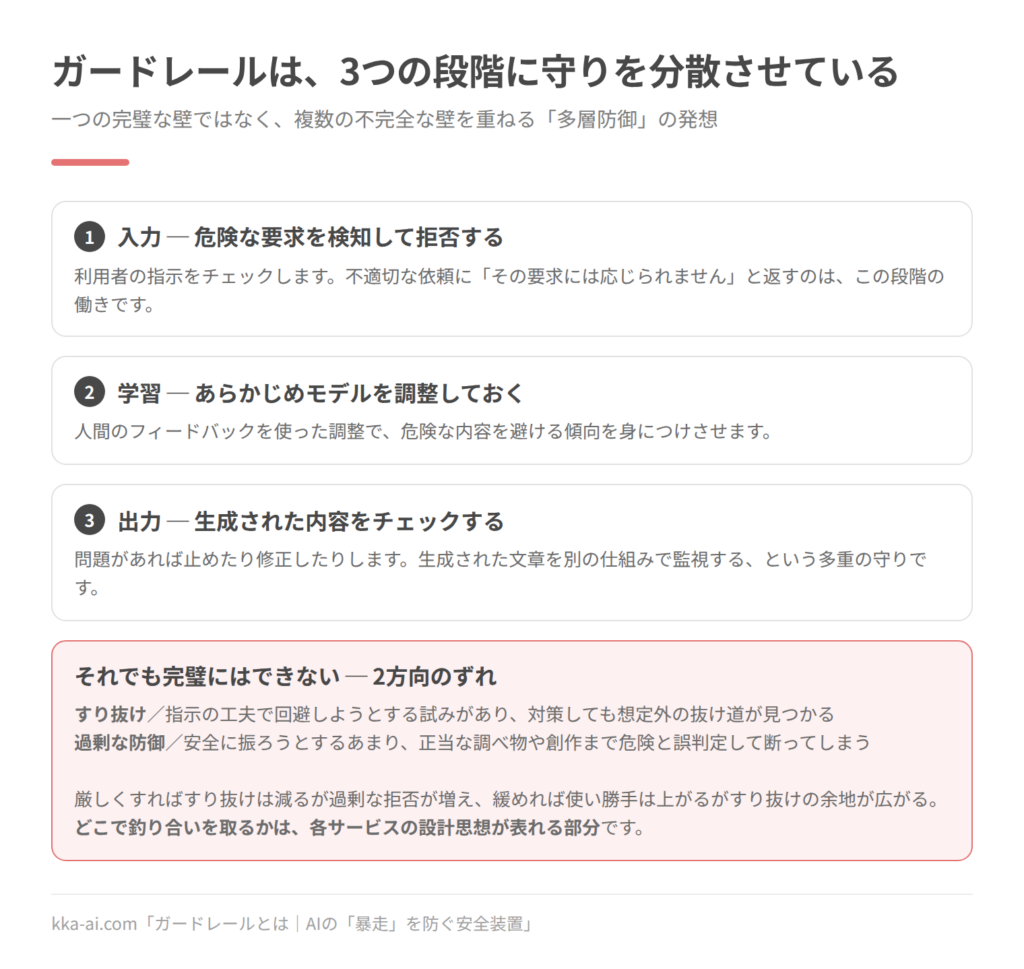
ガードレールは、一つの技術ではなく、複数の仕組みを組み合わせて実現されます。
入力、学習、出力の3段階
入力の段階では、利用者の指示をチェックし、危険な要求を検知して拒否します。不適切な依頼に対して「その要求には応じられません」と返すのは、この段階の働きです。
学習の段階では、望ましくない出力をしないよう、あらかじめモデルを調整しておきます。人間のフィードバックを使った調整で、危険な内容を避ける傾向を身につけさせます。
出力の段階では、AIが生成した内容をチェックし、問題があれば止めたり修正したりします。生成された文章を別の仕組みで監視する、という多重の守りです。
多層防御という発想
これらを組み合わせることで、一つの防御をすり抜けても別の防御で止める、という構えを作っています。
この多層防御の発想は、AIに限らずセキュリティ全般に共通します。一つの完璧な壁を目指すのではなく、複数の不完全な壁を重ねることで、全体として破られにくくする。一枚が破られても、次の壁が残っているという安心感が、多層にする狙いです。
AIのガードレールも、入力、学習、出力という異なる段階に守りを分散させることで、この考え方を実践しています。
なぜ完璧にできないのか
ガードレールは重要ですが、完璧ではありません。「ガードレールがあるから安全」という過信も、「AIは危険だ」という極端な不安も防げます。
すり抜けと過剰防御のトレードオフ
ガードレールには、2つの方向のずれが常につきまといます。
一つは、すり抜けです。
指示の工夫でガードレールを回避しようとする試みがあり、どれだけ対策しても、想定外の抜け道が見つかることがあります。
もう一つは、過剰な防御です。
安全に振ろうとするあまり、無害な要求まで拒否してしまうことがあります。正当な調べ物や創作が、危険と誤判定されて断られる、という不便です。
この2つは、トレードオフの関係にあります。
ガードレールを厳しくすればすり抜けは減りますが、過剰な拒否が増えます。緩めれば使い勝手は上がりますが、すり抜けの余地が広がります。どこで釣り合いを取るかは、各サービスの設計思想が表れる部分です。
脱獄とのいたちごっこ
すり抜けをめぐって、開発側と一部の利用者の間で続いているのが、脱獄と呼ばれる攻防です。
脱獄とは、指示を工夫してガードレールを回避し、本来は拒否されるはずの出力を引き出そうとする試みを指します。
役割を演じさせる、遠回しに尋ねる、架空の設定を持ち込むなど、様々な手口が試みられてきました。
開発側は、こうした手口が見つかるたびに対策を施します。
すると、また新しい抜け道が探される。
この繰り返しが、ガードレールが完璧になり得ないことを示しています。
誰が基準を決めるのか
ガードレールには、「何を許し、何を禁じるか」という基準が必要です。
この基準を誰がどう決めるかは、それ自体が一つの論点です。
基準は、開発する企業の判断で設定されることが多くなっています。
しかし、何が有害か、何を制限すべきかの線引きには、価値観が関わります。
ある人には過剰な制限が、別の人には妥当に見える、ということが起こります。
この基準の設定は、技術の問題であると同時に、社会的な合意の問題でもあります。
サービスによって制限の厳しさが違うのは、この判断の違いの表れです。
業務では「自前のガードレール」も要る
サービス側の防御は万能ではありません。
業務でAIを使うなら、利用者側でもガードレールを設けるのが安全です。
自前のガードレールの例
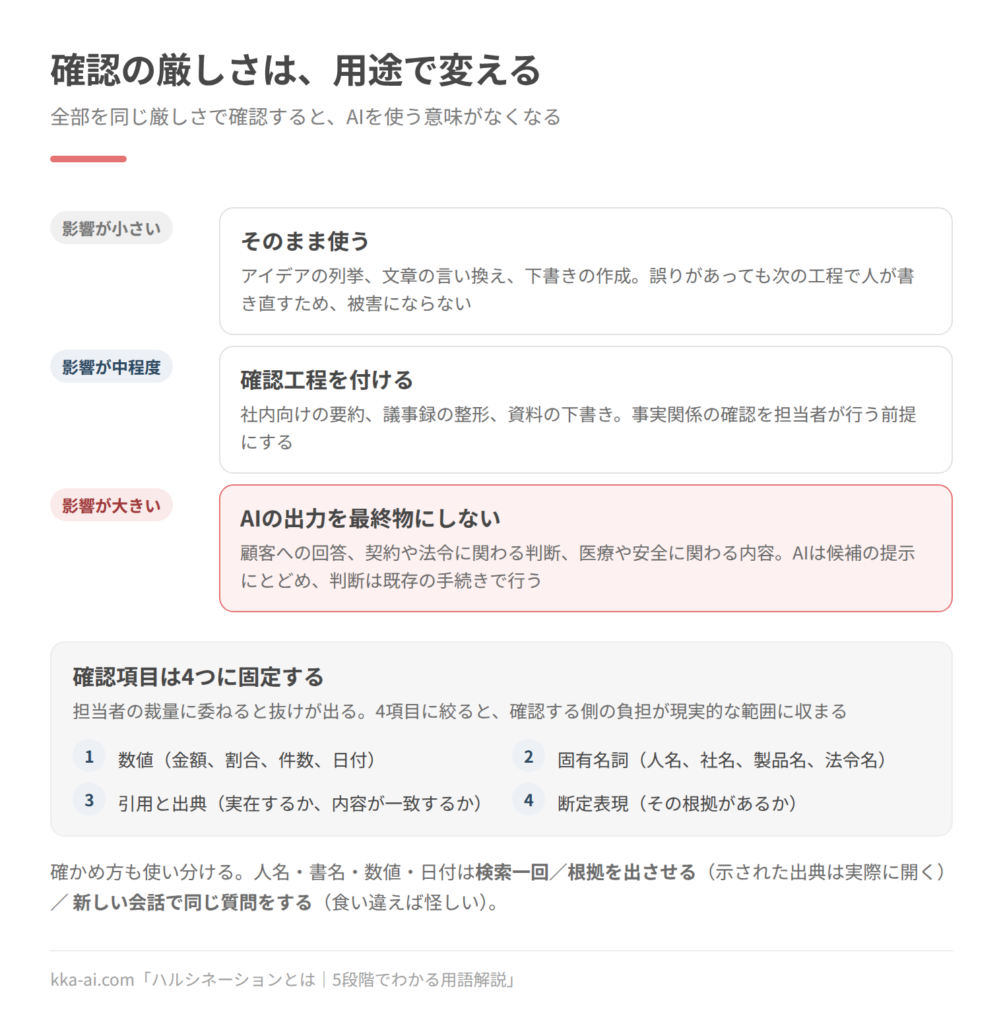
- AIの出力を、人間の確認を経ずに外部へ出さない
- 機密情報や個人情報を入力しない運用ルールを決める
- 数値や固有名詞は、必ず一次情報で裏取りする
- 医療、法律、税務など、誤りが実害に直結する分野では専門家の確認を挟む
これらは、ハルシネーションや情報漏洩といったリスクを、組織や個人の運用で防ぐ仕組みです。
→ ハルシネーションとは|5段階でわかる用語解説
コツは「AIを新入社員のように扱う」
自前のガードレールを考えるときのコツは、AIを新入社員のように扱うことです。
有能だが経験の浅い新人に大事な仕事を任せるとき、いきなり成果物を外に出させず、確認の関門を設けるはずです。
AIも同じで、能力は高くても、その出力を無条件に信頼するのではなく、確認の工程を挟む。
この発想があれば、どんな場面でどんなガードレールが必要かを、自分で判断できるようになります。
AIを安全に使えるかは、サービス側の性能だけでなく、使う側がどんなガードレールを敷くかにもかかっています。
よくある質問
Q. ガードレールとアライメントはどう違うのですか?
A. アライメントは「AIを人間の意図全体にそろえる」広い取り組み、ガードレールはその中の「越えてはいけない一線を守らせる」具体的な仕組みを指すことが多い言葉です。
→ アライメントとは|AIを「人間の意図に沿わせる」という課題
Q. ガードレールがあれば安全に使えますか?
A. 安全性は高まりますが、完璧ではありません。
すり抜けの可能性も、過剰な拒否の可能性も残ります。
サービス側のガードレールを過信せず、利用者側でも確認の仕組みを持つことが大切です。
Q. AIが正当な質問を断るのはなぜですか?
A. ガードレールの過剰防御が原因のことがあります。
安全に振ろうとするあまり、無害な要求を危険と誤判定して断る場合があります。
質問の仕方を変えたり、意図を明確に伝えたりすると、応じてもらえることもあります。
Q. ガードレールはすべてのAIに付いていますか?
A. 主要なAIサービスの多くには、何らかのガードレールが設けられています。
ただし、その厳しさや基準はサービスによって異なります。
また、安全対策を外した改変版が出回ることもあり、「すべてのAIが等しく安全」とは限りません。
Q. 業務利用でガードレールをどう考えればいいですか?
A. サービス側のガードレールを前提にしつつ、それを過信しないことが大切です。
出力を人が確認してから使う、機密を入力しない、といった自前のガードレールを併せて敷くことで、サービス側の防御の隙を補えます。
まとめ
ガードレールとは、AIが危険な方向に出力するのを防ぐ安全装置で、入力、学習、出力の各段階に設けられた複数の仕組みの組み合わせです。
すり抜けと過剰防御という2方向のずれが避けられず、完璧にはできません。
業務で使うなら、サービス側のガードレールに加え、「出力を確認してから外に出す」といった自前のガードレールを敷くことが欠かせません。
安全は、作る側と使う側の両方で守るものです。
背景にある考え方であるアライメントは、こちらで解説しています。
→ アライメントとは|AIを「人間の意図に沿わせる」という課題
用語の全体像はこちらで確認できます。
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
参考
- NIST「AI Risk Management Framework (AI RMF 1.0)」(2023年1月26日・英語。日本語訳あり)
- OWASP「Top 10 for LLM Applications 2025」(英語)