「AIとは何ですか?」という質問に、正解は一つではありません。小学生に説明するときの正解と、社内で導入を検討する会議での正解は、まったく別のものになるからです。
本記事では、AIの説明を5つのレベルに分けて並べました。下から順に読んでもよいですし、自分に必要なレベルだけを読んでも構いません。
どこから読むか
本記事では、同じ用語を5つのレベルに分けて解説しています。当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(8分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(10分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(10分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で通り過ぎます。
1分で腕試し
理解度から決めたい場合は、次の4問を試してください。
Q1〜Q4は、Level 1〜4の内容に1問ずつ対応しています。
最初にまちがえた問題のLevelが、あなたのスタート地点です。
4問とも正解なら、Level 5から読んでください。
各レベルの終わりにも、4択の理解度チェックがあります。
ITパスポート試験の過去問題も入れています。
Q1.【オリジナル】AIが答えを出すしくみの説明として、最も適切なものはどれか。
- ア 人間と同じように、悩んで考えてから答える
- イ これまで見てきた大量の例から、いちばんそれっぽい答えを選んで出す
- ウ インターネットで正しい答えを必ず確かめてから答える
- エ 自信がないときは、必ず「分かりません」と答える
正解:イ
解説:
AIは、人間のように悩んでいるわけではありません。
それっぽい答えを選ぶしくみなので、ときどき堂々と間違えます。
アは誤りです。考えているのではありません。
ウは誤りです。答えを必ず確かめるしくみは入っていません。
エは誤りです。自信がなさそうにするしくみが入っていないので、間違った答えも同じ顔で出てきます。
→ まちがえたら Level 1から
Q2.【オリジナル】「AI」という言葉の説明として、最も適切なものはどれか。
- ア 特定の会社が作った、1つの製品の名前
- イ 世界共通の定義がはっきり決まっている、1つの技術の名前
- ウ 中身の違う多くの技術をまとめて呼ぶ、総称
- エ 文章を作るAIだけを指す言葉
正解:ウ
解説:
AIは、犬や猫のような具体的な名前ではなく、「動物」のような総称です。
何をもって知能と呼ぶかに、世界共通の定義はありません。
アは誤りです。製品の名前ではありません。
イは誤りです。研究者の間でも定義は割れています。
エは誤りです。文章を作るAI(生成AI)は、AIの中の一部です。
→ まちがえたら Level 2から
Q3.【オリジナル】過去2回のAIブームが止まった理由として、本文の説明に最も近いものはどれか。
- ア 人間がルールや知識を書き切れないところで行き詰まった
- イ コンピュータの電気代が高すぎた
- ウ AIを使う法律が禁止された
- エ インターネットのデータが多すぎて、整理できなかった
正解:ア
解説:
第1次は現実の問題の条件の多さに、第2次は知識を人間が書き続けるコストに耐えられませんでした。
今回は、データから学ばせる方式に変わったことが最大の違いです。
イとウは、本文で挙げた理由ではありません。
エは逆です。データが桁違いに増えたことは、今回のブームを支える条件の一つです。
→ まちがえたら Level 3から
Q4.【オリジナル】自社の業務のうち、AIを入れると効果が出やすい工程の組み合わせとして、本文の説明に合うものはどれか。
- ア 判断が難しく、件数が少ない工程と、最終決裁の工程
- イ 法律で人が行うと決まっている工程と、顧客と直接話す工程
- ウ すでに自動化されている工程と、ほとんど発生しない工程
- エ 判断は単純だが量が多い工程と、毎回ゼロから書いている工程
正解:エ
解説:
「AIで何ができるか」から入るのではなく、業務を工程に分けて、この2種類を探します。
問い合わせ対応なら過去の類似案件を探す工程、資料作成ならたたき台を出す工程が当てはまります。
ア、イ、ウは、どれも本文で挙げた2種類に当てはまりません。
→ まちがえたら Level 4から
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:AIを「たくさん見て、まねがうまくなった機械」だと自分の言葉で言える
たくさん見せると、当てられるようになる
犬の写真と猫の写真を並べて、どっちが猫か聞かれたら、まず間違えないと思います。でも、なぜ猫だとわかるのかを説明してくださいと言われると、急に困るはずです。耳の形、ひげ、目つき。
どれも猫っぽさの一部ですが、それだけでは説明しきれません。
コンピュータも同じで、最初は犬と猫の区別がまったくつきません。
そこで人間は、猫の写真を何万枚も見せます。すると、コンピュータは「これが猫っぽさか」というものを自分でつかんで、はじめて見る写真でも当てられるようになります。
このように、たくさんの例を見て賢くなっていくコンピュータのしくみを、AIと呼んでいます。
AIは考えているのではなく、それっぽい答えを出している
ここが大事なところです。
AIは、人間のように「うーん」と悩んでいるわけではありません。これまで見てきた大量の例の中から、いちばんそれっぽい答えを選んで出しています。
だからAIは、ときどき堂々と間違えます。自信がなさそうにするしくみが入っていないので、間違った答えも正しい答えと同じ顔で出てきます。AIの答えを見たら、大人でも必ず確かめる。これはAIを使う人全員のルールです。
身の回りのAIを探してみる
AIは特別な場所にあるわけではなく、もう毎日のように使われています。
- スマホが顔を見てロックを解除する
- 写真アプリが、家族ごとに写真をまとめてくれる
- 動画アプリが、次に見たくなりそうな動画を並べてくる
- 話しかけると、外国語に訳してくれる
どれも、たくさんの例を見て覚えたAIが動いています。
つまずきポイント
「AIには心があるの?」
ありません。
悲しいと言われて悲しそうな返事をするのは、そういう返事の例をたくさん見て覚えているからです。
本当に悲しくなっているわけではない、というのがLevel 1でいちばん大事な区別です。
理解度チェック
Q1.【オリジナル】AIが、猫の写真を当てられるようになる方法として、最も適切なものはどれか。
- ア 猫の写真をたくさん見せてもらい、「猫っぽさ」を自分でつかむ
- イ 人間が、猫の見分け方のルールをすべて書いて教える
- ウ 猫の写真を1枚だけ見て、ずっと覚えておく
- エ 猫に直接会って、においを覚える
正解:ア
解説:
猫の写真を何万枚も見せると、はじめて見る写真でも当てられるようになります。
イは誤りです。耳の形やひげだけでは、猫っぽさを説明しきれません。
ウは誤りです。1枚では足りません。
エは、本文の説明とは関係がありません。
→ Level 1「たくさん見せると、当てられるようになる」に戻る
Q2.【オリジナル】AIの答えについて、正しいものはどれか。
- ア AIの答えは、いつも正しい
- イ 間違えるときは、自信がなさそうに答えるので見分けられる
- ウ 堂々と間違えることがあるので、大人でも必ず確かめる
- エ 子どもが使うときだけ、確かめればよい
正解:ウ
解説:
AIの答えを確かめるのは、AIを使う人全員のルールです。
アは誤りです。いちばんそれっぽい答えを選んでいるだけなので、間違えることがあります。
イは誤りです。間違った答えも、正しい答えと同じ顔で出てきます。
エは誤りです。大人でも確かめます。
→ Level 1「AIは考えているのではなく、それっぽい答えを出している」に戻る
Q3.【オリジナル】「悲しい」と話しかけると、AIが悲しそうな返事をした。この説明として、最も適切なものはどれか。
- ア AIも本当に悲しくなっている
- イ そういう返事の例をたくさん見て覚えているので、悲しそうな返事を出している
- ウ AIの中に、人間と同じ心が入っている
- エ 話しかけた人の気持ちを、カメラで読み取っている
正解:イ
解説:
本当に悲しくなっているわけではない、というのがLevel 1でいちばん大事な区別です。
アとウは誤りです。AIに心はありません。
エは、本文の説明とは関係がありません。
→ Level 1「つまずきポイント」に戻る
Q4.【オリジナル】本文で、身の回りのAIの例として挙げていないものはどれか。
- ア スマホが顔を見てロックを解除する
- イ 写真アプリが、家族ごとに写真をまとめる
- ウ 動画アプリが、次に見たくなりそうな動画を並べる
- エ 時計が、決まった時刻にアラームを鳴らす
正解:エ
解説:
決まった時刻に鳴らすのは、設定どおりに動いているだけで、たくさんの例から覚えたものではありません。
ア、イ、ウは、本文で挙げた例です(ほかに、話しかけると外国語に訳す)。
→ Level 1「身の回りのAIを探してみる」に戻る
Q5.【オリジナル】Level 1でのAIの説明として、最も適切なものはどれか。
- ア 人間よりも何でもよく知っている、物知りの機械
- イ 人間と同じように考えて、心を持つ機械
- ウ 一度も間違えない、計算の速い機械
- エ たくさんの例を見て、まねがうまくなった機械
正解:エ
解説:
たくさんの例を見て賢くなっていくしくみを、AIと呼んでいます。
アは誤りです。見てきた例の範囲で、それっぽい答えを出しているだけです。
イは誤りです。考えているわけでも、心があるわけでもありません。
ウは誤りです。ときどき堂々と間違えます。
→ Level 1「たくさん見せると、当てられるようになる」に戻る
ここまで読めば言えるようになること
- AIは、たくさんの例を見て賢くなる機械だと説明できる
- AIは考えているのではなく、それっぽい答えを出していると説明できる
- 身の回りのAIを3つ挙げられる
3つとも言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(AIはたくさんの例を見て賢くなる)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:AIが「総称」だと知り、ニュースがどの種類のAIの話かを一度立ち止まって考えられる
AIという言葉には、中身が入っていない
AIは、Artificial Intelligence(人工知能)の略です。日本語にすると人工の知能ですが、そもそも何をもって知能と呼ぶかについて、世界共通の定義はありません。研究者の間でも定義は割れていて、「人間の知的なふるまいをコンピュータで再現しようとする技術の総称」という、かなり緩いくくりで使われています。
つまりAIは、犬や猫のような具体的な名前ではなく、動物のような総称です。動物を飼っていますと言われても、金魚か大型犬かはわかりません。AIも同じで、それだけでは何の話かわかりません。
「AI搭載」の幅は、想像よりずっと広い
この総称としての緩さは、実害を生みます。温度を自動で変える炊飯器も、ChatGPTも、どちらも「AI搭載」と言えてしまうからです。
仕組みも賢さもまったく違うのに、同じ看板で売られ、同じ言葉で報じられます。
だからAIという言葉を見たら、「これはどの種類のAIの話だろう」と一度立ち止まる。
これが、AIのニュースが読めるようになる最初の一歩です。
中身は4つに分けられる
AIと呼ばれるものは、大きく4つに分けると理解しやすくなります。4つは別々のものではなく、外側が内側を含む入れ子の関係です。
- ルールベース:人間が「もしAならBせよ」と書いたとおりに動くもの。学習はしません
- 機械学習:ルールを書く代わりに、データから規則性をコンピュータに見つけさせるもの
- ディープラーニング:機械学習の一種で、人間の脳の神経回路をヒントにした多層のしくみを使うもの
- 生成AI:文章や画像を新しく作り出すもの。ディープラーニングで作られています
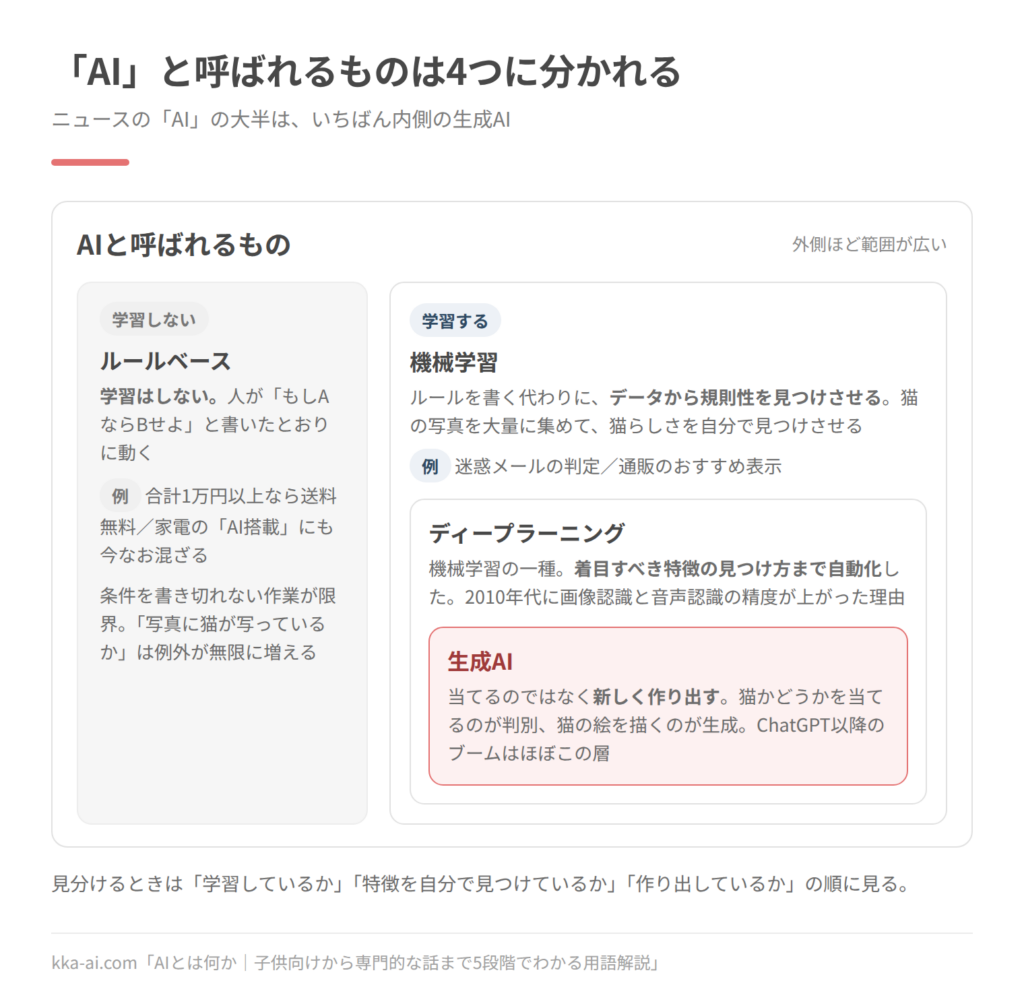
ニュースで見る「AI」の大半はいちばん内側の話。家電の「AI搭載」には、今も外側のルールベースが混ざる。
ニュースで話題になる「AI」の大半は、いちばん内側の生成AIです。
一方、家電の「AI搭載」には、いちばん外側のルールベースが今も混ざっています。
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
→ ディープラーニング(深層学習)とは|5段階でわかる用語解説
→ 生成AIとは?5段階でわかる用語解説
つまずきポイント
「AIと機械学習と生成AIは、どれがどれ?」
並んでいるものではなく、入れ子になっていると考えてください。
AIという大きな箱の中に機械学習があり、その中にディープラーニングがあり、その中に生成AIがあります。この順番が出てこないうちは、Level 1の「たくさん見て賢くなる」に戻って、その「たくさん見て賢くなる」部分が機械学習だと確かめると整理しやすくなります。
理解度チェック
Q1.【IPA過去問】ある会社のECサイトでは,利用者からのチャットでの多様な問合せについて,オペレータが対応する仕組みから,ソフトウェアによる自動対応に変更した。このとき,利用者の過去のチャットの内容などを学習し,会話の流れから適切な回答を推測できる仕組みに変更するために使われた技術として,最も適切なものはどれか。
- ア AI
- イ AR
- ウ CRM
- エ ERP
出典:令和2年度 ITパスポート試験 公開問題 問32
正解:ア
解説:
「過去のチャットの内容などを学習し」「回答を推測できる」が、データから学ぶAI(機械学習)の特徴です。
イのARは、現実の風景に情報を重ねて表示する技術(拡張現実)です。
ウのCRMは、顧客との関係を管理する仕組みや考え方です。
エのERPは、会社全体の経営資源をまとめて管理する仕組みです。
どれもアルファベット3文字以内の略語なので、略語が何の頭文字かを覚えておくと迷いません。
→ Level 2「AIという言葉には、中身が入っていない」に戻る
Q2.【オリジナル】温度を自動で変える炊飯器の「AI搭載」と、会話して文章を作るAIの関係として、最も適切なものはどれか。
- ア どちらも同じ仕組みで、賢さも同じである
- イ どちらも「AI」と呼ばれるが、仕組みも賢さもまったく違うことがある
- ウ 炊飯器のほうが新しい技術である
- エ 「AI搭載」と書けるのは、文章を作るAIだけである
正解:イ
解説:
AIは総称なので、まったく違う中身が同じ看板で呼ばれます。
炊飯器の「AI搭載」には、人間が書いたルールで動くものが今も多く混ざっています。
アは誤りです。中身が違います。
ウは、本文で比べていない話です。
エは誤りです。「AI搭載」の幅は、想像よりずっと広く使われています。
→ Level 2「「AI搭載」の幅は、想像よりずっと広い」に戻る
Q3.【オリジナル】AIと呼ばれるものを4つに分けたとき、外側から内側への順番として、最も適切なものはどれか。
- ア 生成AI → ディープラーニング → 機械学習 → ルールベース
- イ 機械学習 → ルールベース → 生成AI → ディープラーニング
- ウ ルールベース → 機械学習 → ディープラーニング → 生成AI
- エ ディープラーニング → 生成AI → ルールベース → 機械学習
正解:ウ
解説:
4つは別々のものではなく、外側が内側を含む入れ子の関係です。
ニュースで話題になる「AI」の大半は、いちばん内側の生成AIです。
アは、順番が逆です。
イとエは、順番がばらばらです。
→ Level 2「中身は4つに分けられる」に戻る
Q4.【オリジナル】ルールベースのAIの説明として、最も適切なものはどれか。
- ア 人間が「もしAならBせよ」と書いたとおりに動き、学習はしない
- イ データから規則性をコンピュータに見つけさせる
- ウ 人間の脳の神経回路をヒントにした、多層のしくみを使う
- エ 文章や画像を、新しく作り出す
正解:ア
解説:
4つの層のうち、いちばん外側にあたります。
イは機械学習、ウはディープラーニング、エは生成AIの説明です。
→ Level 2「中身は4つに分けられる」に戻る
Q5.【オリジナル】ニュースで「AI」という言葉を見たときに、最初にするとよいこととして、本文で勧めているものはどれか。
- ア 「AI」と書いてあれば、生成AIの話だと決めて読む
- イ 「これはどの種類のAIの話だろう」と一度立ち止まる
- ウ 「AI」と書いてある記事は、読まないようにする
- エ 「AI」と書いてあれば、すべて同じ技術だと考える
正解:イ
解説:
AIは総称なので、それだけでは何の話か分かりません。
一度立ち止まることが、AIのニュースが読めるようになる最初の一歩です。
アとエは、総称であることを見落としています。
ウは、本文の勧めではありません。
→ Level 2「「AI搭載」の幅は、想像よりずっと広い」に戻る
ここまで読めば言えるようになること
- AIは総称であって、具体的な技術名ではないと説明できる
- AIの中身を4つに分けて名前を挙げられる
- 4つが入れ子の関係だと説明できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(AIは総称であること、4つの層)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:4つの層をそれぞれ説明でき、なぜ今回のAIブームが続いているのかを語れる
4つの層を、それぞれの得意分野で見分ける
Level 2で挙げた4つを、もう少し具体的に見ていきます。
ルールベースのAIは、人間が条件を書き切れる作業に向いています。
「合計が1万円以上なら送料無料」のような処理は、今もこの方式で十分です。限界は、条件を書き切れない作業に出ます。
「この写真に猫が写っているか」を条件で書こうとすると、後ろ姿の猫、暗がりの猫、着ぐるみと、例外が無限に増えていきます。
機械学習は、その限界を逆から解きます。条件を書く代わりに、猫の写真を大量に集めて、猫らしさをコンピュータ自身に見つけさせます。迷惑メールの判定や、通販サイトのおすすめ表示は、この層で動いています。
詳しくは別記事にまとめました。
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
ディープラーニングは、機械学習の中でも、着目すべき特徴の見つけ方まで自動化した手法です。それ以前の機械学習では、「ひげの本数に注目せよ」といった特徴の選定を人間が担当していました。
その部分まで任せられるようになったことが、2010年代に画像認識や音声認識の精度が一気に上がった理由です。
→ ディープラーニング(深層学習)とは|5段階でわかる用語解説
生成AIは、判別するのではなく新しく作り出す点が違います。猫かどうかを当てるのが判別で、猫の絵を描くのが生成です。
ChatGPT以降のブームは、ほぼこの層の話をしています。
→ 生成AIとは?5段階でわかる用語解説
AIブームは3回目で、過去2回は冬で終わった
現在のAIブームは3回目です。
過去2回は、いずれも冬の時代と呼ばれる停滞期で終わりました。
第1次ブームは1950年代から60年代で、コンピュータに推論と探索をさせる研究が中心でした。
迷路やパズルは解けたものの、現実の問題は条件が多すぎて歯が立たず、期待はしぼみます。
第2次ブームは1980年代で、専門家の知識をルールとして書き込むエキスパートシステムが主役でした。
4つの層でいえばルールベースの発展形です。
医療診断などで成果は出ましたが、知識を人間が書き続けるコストに耐えられませんでした。
第3次ブームが、2010年代以降の機械学習とディープラーニングによるものです。
なぜ今回は冬が来ていないのか
過去2回の失敗が、人間がルールを書き切れないところで止まったのに対し、今回はデータから学ばせる方式に変わりました。
これが最大の違いです。
そのうえで、以下の3つの条件がそろいました。
一つ目は、インターネットの普及で学習に使えるデータが桁違いに増えたことです。
二つ目は、GPUという計算装置が安く手に入るようになり、大量の計算が現実的になったことです。
三つ目は、2017年に発表されたトランスフォーマーという構造によって、大量の文章を並列で処理できるようになったことです。
この3つがそろって初めて、大規模な学習が成立しました。どれか一つでも欠けていれば、現在の生成AIは成立していません。
特化型AIと汎用人工知能を混ぜない
もう一つ、Level 3で押さえておきたい区別があります。現在実用化されているAIは、すべて特化型AIです。翻訳が得意なAI、画像を判別するAI、文章を書くAIと、それぞれ用途に合わせて作られています。
これに対して、人間のように幅広い知的作業を何でもこなすAIを、**AGI(汎用人工知能)**と呼びます。AGIはまだ実現していない概念であり、実現時期については専門家の間でも見解が大きく割れています。「AIが人類を超える」という見出しは、ほぼこのAGIの話をしていますが、記事が特化型AIの成果を根拠にAGIを語っていることも多く、そこは分けて読む必要があります。
つまずきポイント
「ディープラーニングと生成AIの違いがわからない」
層の違いではなく、目的の違いで見てください。ディープラーニングは学習の手法の名前で、生成AIは作り出すという目的の名前です。
生成AIはディープラーニングで作られているので、対立するものではありません。この区別があやふやなら、Level 2の入れ子の図に戻ってください。
理解度チェック
Q1.【IPA過去問】コンビニエンスストアを全国にチェーン展開するA社では,過去10年間にわたる各店舗の詳細な販売データが本部に蓄積されている。これらの販売データと,過去10年間の気象データ,及び各店舗近隣のイベント情報との関係を分析して,気象条件,イベント情報と商品の販売量との関連性を把握し,1週間先までの天気予報とイベント情報から店舗ごとの販売予想をより高い精度で行うシステムを構築したい。このとき活用する技術として,最も適切なものはどれか。
- ア IoTを用いたセンサなどからの自動データ収集技術
- イ 仮想空間で現実のような体験を感じることができる仮想現実技術
- ウ ディープラーニングなどのAI技術
- エ 表計算ソフトを用いて統計分析などを行う技術
出典:令和2年度 ITパスポート試験 公開問題 問4
正解:ウ
解説:
大量の過去データから、条件と結果の関係(規則性)を見つけ、未来を予測しています。
人間がルールを書き切れない関係をデータから見つけるのが、機械学習やディープラーニングの得意な仕事です。
アは、データを集める技術で、関係を見つけて予測する技術ではありません。
イは、仮想現実(VR)の説明です。
エは、表計算の統計分析でも傾向はつかめますが、多くの要素が絡む関係を「より高い精度で」予測する目的には、AI技術のほうが適しています。
→ Level 3「4つの層を、それぞれの得意分野で見分ける」に戻る
Q2.【オリジナル】ルールベースのAIが向いていない作業として、最も適切なものはどれか。
- ア 合計が1万円以上なら送料を無料にする
- イ 入力された日付が、土日かどうかを判定する
- ウ 決まった税率で、税込みの金額を計算する
- エ 写真に猫が写っているかを判定する
正解:エ
解説:
「猫が写っているか」を条件で書こうとすると、後ろ姿の猫、暗がりの猫、着ぐるみと、例外が無限に増えます。
ア、イ、ウは、人間が条件を書き切れる作業なので、今もルールベースで十分です。
→ Level 3「4つの層を、それぞれの得意分野で見分ける」に戻る
Q3.【オリジナル】ディープラーニングが、それ以前の機械学習と決定的に違う点はどれか。
- ア データを使わずに学習できるようになった
- イ どの特徴に注目するかの選定まで自動化した
- ウ 人間が書いたルールで動くようになった
- エ 文章を作ることしかできなくなった
正解:イ
解説:
それ以前は、「ひげの本数に注目せよ」といった特徴の選定を人間が担当していました。
その部分まで任せられるようになったことが、2010年代に画像認識や音声認識の精度が一気に上がった理由です。
アは誤りです。大量のデータが必要です。
ウは、ルールベースの説明です。
エは誤りです。画像や音声の認識にも使われています。
→ Level 3「4つの層を、それぞれの得意分野で見分ける」に戻る
Q4.【オリジナル】今回のAIブームを支える3つの条件として、本文で挙げていないものはどれか。
- ア インターネットの普及で、学習に使えるデータが桁違いに増えた
- イ GPUという計算装置が安く手に入るようになった
- ウ 大量の文章を並列で処理できる、トランスフォーマーという構造が発表された
- エ 専門家の知識をルールとして書き込む方法が完成した
正解:エ
解説:
専門家の知識をルールとして書き込むのは、第2次ブームのエキスパートシステムの方法です。
そのコストに耐えられなかったことが、第2次ブームが止まった理由でした。
ア、イ、ウが、本文で挙げた3つの条件です。
→ Level 3「なぜ今回は冬が来ていないのか」に戻る
Q5.【オリジナル】特化型AIとAGI(汎用人工知能)について、最も適切なものはどれか。
- ア 現在実用化されているAIはすべて特化型AIで、AGIはまだ実現していない概念である
- イ 現在実用化されているAIは、すべてAGIである
- ウ 文章を書くAIは、AGIにあたる
- エ AGIの実現時期は、専門家の間で意見が一致している
正解:ア
解説:
翻訳、画像の判別、文章作成と、それぞれ用途に合わせて作られているのが特化型AIです。
「AIが人類を超える」という見出しは、ほぼAGIの話です。特化型AIの成果を根拠にAGIを語る記事もあるので、分けて読みます。
イとウは誤りです。文章を書くAIも、特化型AIです。
エは誤りです。見解は大きく割れています。
→ Level 3「特化型AIと汎用人工知能を混ぜない」に戻る
ここまで読めば言えるようになること
- 4つの層をそれぞれ具体例つきで説明できる
- AIブームが3回目であり、過去2回が何で止まったかを説明できる
- 今回のブームが続いている理由を3つ挙げられる
- 特化型AIとAGIを区別できる
ここまでで、AIのニュースはほぼ読めるようになります。
仕事で使う立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(4つの層、AIブームの歴史)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:自社でAIを使うかどうかを、何を基準に判断すればよいか説明できる
導入していない側が、すでに少数派に近づいている
総務省の「令和8年版 情報通信白書」によると、生成AIの活用方針を定めている日本企業は、2025年度の調査で68.9%でした。 前年度の49.7%から19.2ポイント増えています。ここでいう「方針を定めている」は、「積極的に活用する」と「活用する領域を限定して利用する」を合わせた割合です。 1つ以上の業務で実際に使っている企業は86.4%で、米国の90.9%、ドイツの91.6%と大きくは離れていません。 差が出ているのは方針のほうで、米国は87.8%、中国は94.1%です。
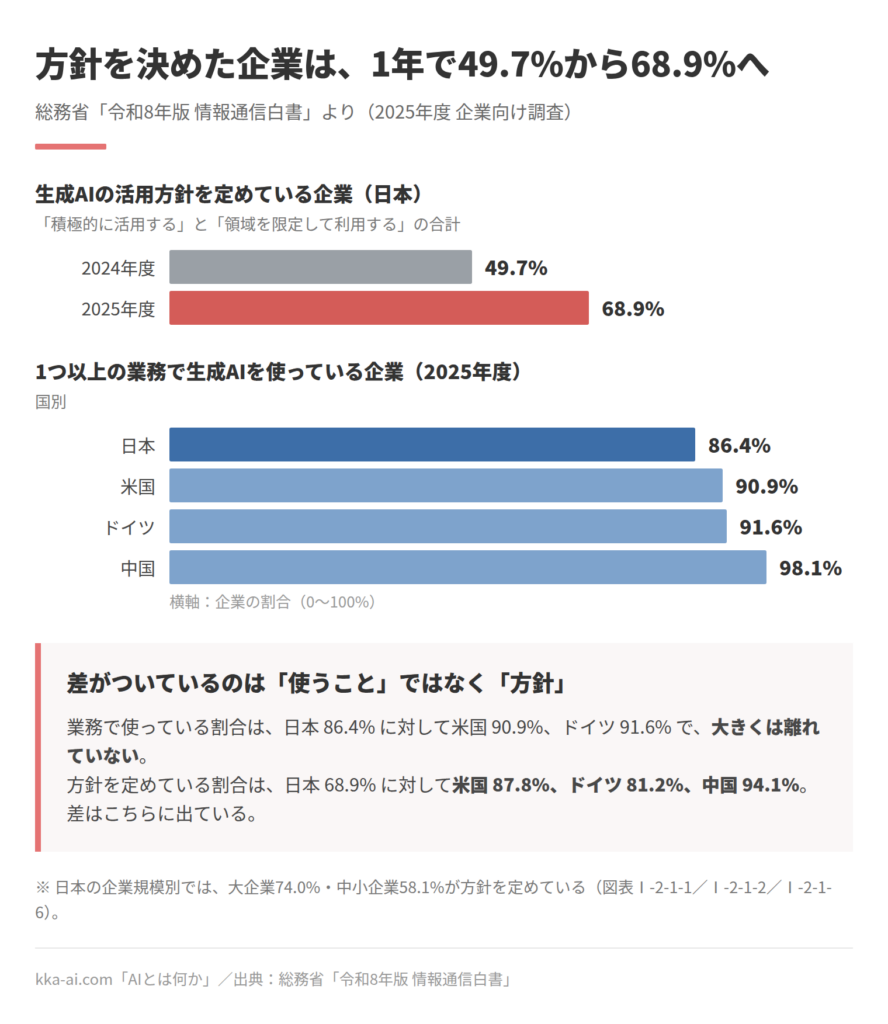
前年度(令和7年版)の調査では、活用しない理由の上位に「適切な活用方法が分からない」が挙がっていました。 セキュリティへの懸念やコストより前に、使いどころが見つからないという段階で止まっている企業が多いという意味です。
「AIで何ができるか」から入ると失敗する
使いどころが見つからない原因は、たいてい問いの立て方にあります。
「AIで何ができるか」から入ると、できることの一覧を眺めるだけで終わります。
順序を逆にしてください。
自社の業務を工程に分解し、そのうち「判断は単純だが量が多い工程」と「毎回ゼロから書いている工程」を探します。
AIが有効なのはこの2種類で、それ以外の工程に入れても効果は出にくいままです。
たとえば問い合わせ対応なら、回答を作る工程ではなく、過去の類似案件を探す工程のほうが効果があります。
資料作成なら、完成させる工程ではなく、たたき台を出す工程です。
導入の4パターンと、かかるコストの桁
AIの導入方法は、大きく4つに分かれます。
下にいくほど費用と難度が上がり、そのぶん自社の事情に合わせられます。
- 既製のSaaSに乗る:議事録ツールや文字起こしツールなど、目的別の製品を契約する。月額数千円から。開発は不要
- 汎用のチャットサービスを業務で使う:ChatGPTやClaudeの法人プランを契約する。一人あたり月額数千円。ルール整備が主な作業
- RAGで自社文書を参照させる:社内規程やマニュアルを検索させて、それに基づいて答えさせる。数十万円から数百万円規模
- 自社データで追加学習する:特定業務に合わせてモデルを調整する。数百万円以上と、データ整備の体制が必要
多くの企業は上の2つで足りるにもかかわらず、下の2つを検討して止まります。
まず上の2つで効果を測り、足りない部分だけを下に降ろすのが、費用対効果の面で無難です。
稟議で必ず聞かれる3つのこと
導入を提案すると、ほぼ確実に次の3点を聞かれます。
先に答えを用意しておくと話が早くなります。
入力してよい情報の範囲はどこまでか。
顧客の個人情報、未公開の財務情報、他社との秘密保持契約がかかった資料。
どれを入れてよいかを一覧にし、判断に迷ったら入れないという原則を添えます。
サービス側が入力内容を学習に使うかどうかも、契約プランごとに確認が必要です。
出力を誰が確認するのか。
AIの出力をそのまま外に出す運用は、業務では成立しません。
誰が、どの段階で、何を確認するのかを、既存の承認フローに組み込みます。
何%当たれば業務が回るのか。
ここを決めずに始めると、精度の議論が永遠に終わりません。
現在の人手の精度を基準にし、それを下回らなければ採用するという形にすると、判断が付きます。
PoCで止まる会社と、進む会社の違い
実証実験(PoC)まではやったが本番導入に至らない、という話はよく耳にします。
分かれ目になるのは、PoCの開始時点で合格ラインを決めていたかどうかです。
「試してみて、よさそうなら本番へ」という設計だと、よさそうかどうかの判断が主観になり、決裁が下りません。
「この工程の処理時間が30%減れば本番へ」のように、数字と対象工程を先に決めておけば、結果がどちらでも次に進めます。
社内ルールの拠り所
社内規程を作るときは、ゼロから書く必要はありません。
総務省と経済産業省が公表しているAI事業者ガイドライン(2026年8月時点の最新は令和7年3月の第1.1版)が、事業者向けの整理として使えます。
生成AIの出力の確認体制、入力情報の管理、著作権への配慮といった論点が並んでいるので、自社に関係する項目を抜き出して社内規程の骨子にする進め方が現実的です。
つまずきポイント
「精度99%と言われたが、信じてよいのか」
何のデータで測った99%かを確認してください。
学習に使ったデータで測れば数字は高く出ます。
判断材料になるのは、学習に使っていないデータで測った数字と、自社の実データで測った数字です。
この違いがぴんとこない場合は、機械学習の記事の過学習の項を先に読んでください。
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
理解度チェック
Q1.【オリジナル】本文の説明で、日本企業の差が最も出ている点はどれか。
- ア AIを1つ以上の業務で使っているかどうか
- イ 生成AIの活用方針を定めているかどうか
- ウ AIの研究者が社内にいるかどうか
- エ 自社でAIのモデルを開発しているかどうか
正解:イ
解説:
実際に使っている企業の割合は他国と大きく離れていない一方、方針を定めている割合で差がついています。
アは、他国と大きくは離れていない、と本文で説明しているほうです。
ウとエは、本文で比べていない点です。
→ Level 4「導入していない側が、すでに少数派に近づいている」に戻る
Q2.【オリジナル】AIの導入方法を、費用の低い順に並べたものとして、最も適切なものはどれか。
- ア 既製のSaaS → 汎用のチャットサービスの法人契約 → RAGで自社文書を参照 → 自社データで追加学習
- イ 自社データで追加学習 → RAGで自社文書を参照 → 汎用のチャットサービスの法人契約 → 既製のSaaS
- ウ RAGで自社文書を参照 → 既製のSaaS → 自社データで追加学習 → 汎用のチャットサービスの法人契約
- エ 汎用のチャットサービスの法人契約 → 自社データで追加学習 → 既製のSaaS → RAGで自社文書を参照
正解:ア
解説:
下にいくほど費用と難度が上がり、そのぶん自社の事情に合わせられます。
多くの企業は上の2つで足りるので、まず上の2つで効果を測り、足りない部分だけを下に降ろします。
イは、順番が逆です。
ウとエは、順番がばらばらです。
→ Level 4「導入の4パターンと、かかるコストの桁」に戻る
Q3.【オリジナル】導入の稟議で、ほぼ確実に聞かれるとして本文で挙げた3点に含まれないものはどれか。
- ア 入力してよい情報の範囲はどこまでか
- イ 出力を誰が確認するのか
- ウ 何%当たれば業務が回るのか
- エ AIを開発した会社の創業者は誰か
正解:エ
解説:
ア、イ、ウが、本文で挙げた3点です。
先に答えを用意しておくと話が早くなります。
エは、導入の判断とは関係のない質問です。
→ Level 4「稟議で必ず聞かれる3つのこと」に戻る
Q4.【オリジナル】実証実験(PoC)の後に本番導入へ進めない会社の、典型的な原因はどれか。
- ア PoCの期間が長すぎた
- イ PoCに参加した人数が多すぎた
- ウ PoCの開始時点で、合格ラインを数字と対象工程で決めていなかった
- エ PoCの結果が良すぎた
正解:ウ
解説:
「試してみて、よさそうなら本番へ」では、よさそうかどうかの判断が主観になり、決裁が下りません。
「この工程の処理時間が30%減れば本番へ」のように先に決めておけば、結果がどちらでも次に進めます。
ア、イ、エは、本文で挙げた原因ではありません。
→ Level 4「PoCで止まる会社と、進む会社の違い」に戻る
Q5.【オリジナル】「精度99%」と説明されたAIについて、最初に確かめるべきこととして、最も適切なものはどれか。
- ア 何のデータで測った99%か
- イ 99%という数字が、四捨五入されているかどうか
- ウ 製品のパンフレットに99%と書いてあるかどうか
- エ 他社も同じ製品を使っているかどうか
正解:ア
解説:
学習に使ったデータで測れば、数字は高く出ます。
判断材料になるのは、学習に使っていないデータで測った数字と、自社の実データで測った数字です。
イ、ウ、エは、数字の中身を確かめることにはなりません。
→ Level 4「つまずきポイント」に戻る
ここまで読めば言えるようになること
- AIの効果がある業務工程の条件を2つ挙げられる
- 導入の4パターンと、それぞれの費用感を説明できる
- 稟議で聞かれる3点に、自社の答えを用意できる
- PoCの合格ラインを数字で書ける
技術そのものに踏み込む必要が出てきたら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:AI分野の技術的な見取り図を持ち、専門記事の前提を補える
記号主義とコネクショニズムという二つの系譜
AIの研究は、大きく二つの立場の間を行き来してきました。
一つは記号主義で、知識を記号と規則で表し、その操作によって推論を実現しようとする立場です。
第2次ブームのエキスパートシステムは、この立場の到達点にあたります。
もう一つがコネクショニズムで、単純な計算素子を大量につないだネットワークの結合の強さに知識を宿らせる立場です。
現在のニューラルネットワークとディープラーニングは、こちらの系譜にあります。
記号主義が行き詰まった理由として、しばしば二つの問題が挙げられます。
フレーム問題は、現実の問題を解くとき、考慮すべき事柄の範囲を有限に切り出せないという問題です。
記号接地問題は、記号がそれ自体では現実の対象と結びつかず、意味を持ちえないという問題です。
どちらも、現在の深層学習によって解決されたとは考えられておらず、形を変えて残っています。
現在の中心にある技術
コネクショニズムの側で、現在動いている要素を整理します。
学習は、損失関数が小さくなる方向にパラメータを更新する最適化として定式化されます。
更新の方向は勾配で決め、多層のネットワークでその勾配を効率的に求める手法が誤差逆伝播法です。
実際には、確率的勾配降下法やその改良版が使われます。
→ AIモデルのパラメータとは|「〇億パラメータ」の意味と読み方
2017年に発表されたトランスフォーマーは、自己注意機構によって系列内の任意の位置どうしの関係を直接扱えるようにした構造です。
それ以前の再帰型ネットワークが逐次処理を前提としていたのに対し、並列化できる点が決定的でした。
これによって、計算資源を投じれば投じるほどモデルを大きくできるようになりました。
規模と性能の関係はスケーリング則として整理されています。
パラメータ数、データ量、計算量を増やすと損失が冪乗則に従って下がるという経験則で、大規模化を正当化する根拠として使われてきました。
一方、近年は同じ計算量をどう配分するかや、データの質のほうが重要であるという議論も増えています。
学習の工程は、大量のテキストで汎用的な能力を獲得する事前学習と、用途に合わせて調整する事後学習に分かれます。
事後学習には、指示と応答の組で学ばせる教師ありファインチューニングと、人間の選好を反映させる強化学習系の手法があります。
→ LLM(大規模言語モデル)とは|5段階でわかる用語解説
→ ファインチューニングとは|5段階でわかる用語解説
評価の難しさ
技術記事を読むうえで、評価の扱いには注意が要ります。
ベンチマークのスコアは、学習データにそのベンチマークの問題が混入していれば簡単に上がります。
このデータ汚染の問題は完全には検出できず、公開スコアだけでモデルの実力を比較するのは危うい状態が続いています。
自社で評価するなら、自社の業務データから評価セットを作り、公開されていない問題で測るのが確実です。
残っている限界
現在の深層学習には、まだ扱えていない論点があります。
学習時の分布から外れた入力に対して性能が落ちる分布外汎化の問題は、実務では最も頻繁に表れます。
相関を捉えることはできても因果を扱えない点も、意思決定に使う際の制約になります。
記号接地の問題も、マルチモーダル化によって緩和されたという主張はあるものの、解決したとは言えません。
これらは、規模を大きくすれば自然に解決するのか、別の枠組みが要るのかで、研究者の見解が分かれています。
この先の進み方
体系的に学ぶなら、日本ではG検定とE資格が入口として整備されています。
G検定は事業活用に必要な知識の範囲、E資格は実装まで含む範囲を扱います。
原典に当たるなら、arXivのcs.AIおよびcs.LG、cs.CLのカテゴリが主な発表先です。
査読前の原稿が大半なので、引用数や追試の有無を確認しながら読むことになります。
理解度チェック
Q1.【オリジナル】記号主義とコネクショニズムの説明の組み合わせとして、最も適切なものはどれか。
- ア 記号主義:計算素子をつないだネットワークの結合の強さに知識を宿らせる/コネクショニズム:知識を記号と規則で表す
- イ 記号主義:知識を記号と規則で表し、その操作で推論する/コネクショニズム:計算素子をつないだネットワークの結合の強さに知識を宿らせる
- ウ どちらも、知識を記号と規則で表す立場である
- エ どちらも、現在のディープラーニングと同じ立場である
正解:イ
解説:
第2次ブームのエキスパートシステムは、記号主義の到達点にあたります。
現在のニューラルネットワークとディープラーニングは、コネクショニズムの系譜です。
アは、組み合わせが逆です。
ウとエは、2つの立場の違いを無視しています。
→ Level 5「記号主義とコネクショニズムという二つの系譜」に戻る
Q2.【オリジナル】フレーム問題の説明として、最も適切なものはどれか。
- ア 記号が、それ自体では現実の対象と結びつかず、意味を持ちえない問題
- イ 学習時の分布から外れた入力で、性能が落ちる問題
- ウ 現実の問題を解くとき、考慮すべき事柄の範囲を有限に切り出せない問題
- エ ベンチマークの問題が学習データに混入し、スコアが上がってしまう問題
正解:ウ
解説:
記号主義が行き詰まった理由として、よく挙げられる問題の一つです。
現在の深層学習によって解決されたとは考えられておらず、形を変えて残っています。
アは、記号接地問題の説明です。
イは、分布外汎化の問題の説明です。
エは、データ汚染の問題の説明です。
→ Level 5「記号主義とコネクショニズムという二つの系譜」に戻る
Q3.【オリジナル】トランスフォーマーが大規模化を可能にした理由として、最も適切なものはどれか。
- ア 自己注意機構によって、系列内の位置どうしの関係を直接扱い、並列に処理できるようにしたから
- イ 逐次処理を徹底して、1つずつ順番に正確に計算するようにしたから
- ウ 学習データを使わずに、規則だけで動くようにしたから
- エ パラメータの数を減らして、小さなモデルでも賢くなるようにしたから
正解:ア
解説:
それ以前の再帰型ネットワークは、逐次処理を前提としていました。
並列化できたことで、計算資源を投じるほどモデルを大きくできるようになりました。
イは、再帰型ネットワークの側の性質で、大規模化を妨げていたほうです。
ウは、記号主義の側の説明です。
エは、本文の説明とは逆の方向です。
→ Level 5「現在の中心にある技術」に戻る
Q4.【オリジナル】公開ベンチマークのスコアだけでモデルを比べることが危うい理由として、最も適切なものはどれか。
- ア ベンチマークの問題は毎回変わるので、比べられないから
- イ スコアは、計算の速さしか表していないから
- ウ ベンチマークは、日本語のモデルにしか使えないから
- エ 学習データにベンチマークの問題が混入していればスコアは上がり、その汚染を完全には検出できないから
正解:エ
解説:
自社で評価するなら、自社の業務データから評価セットを作り、公開されていない問題で測るのが確実です。
アは誤りです。問題が公開されて固定されているからこそ、混入が起きます。
イとウは、本文の説明とは関係がありません。
→ Level 5「評価の難しさ」に戻る
Q5.【オリジナル】現在の深層学習に残る限界として、本文で「実務で最も頻繁に表れる」とした問題はどれか。
- ア 計算が速すぎて、結果を確認できない問題
- イ 学習時の分布から外れた入力に対して、性能が落ちる問題(分布外汎化)
- ウ 学習データが多すぎると、必ず性能が落ちる問題
- エ 文章を作るときに、必ず同じ文になる問題
正解:イ
解説:
本文ではこのほかに、相関は捉えても因果を扱えない点と、記号接地の問題を挙げています。
規模を大きくすれば自然に解決するのか、別の枠組みが要るのかで、研究者の見解が分かれています。
ア、ウ、エは、本文で挙げた限界ではありません。
→ Level 5「残っている限界」に戻る
ここまで読めば言えるようになること
- AI研究の二つの系譜と、それぞれの行き詰まりを説明できる
- 誤差逆伝播法、トランスフォーマー、スケーリング則の役割を位置づけられる
- ベンチマークのスコアを鵜呑みにせず、評価の前提を確認できる
- 現在の深層学習に残る限界を3つ挙げられる
まとめ
AIという言葉は総称であり、どのレベルで説明するかによって正解が変わります。
Level 1では、たくさんの例を見て賢くなる機械。
Level 2では、4つの層を含む総称。
Level 3では、3回目のブームを支える技術の集まり。
Level 4では、業務工程に当てて費用対効果を測る対象。
Level 5では、二つの系譜と未解決の問題を抱えた研究分野。
どれも間違いではなく、相手と場面によって使い分けるものです。
自分がどのレベルで話しているかを意識できるようになれば、AIの話はかなり通じやすくなります。
次に読む記事
このシリーズの他の2本も、同じ5段階の構成です。
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
→ LLM(大規模言語モデル)とは|5段階でわかる用語解説
用語をまとめて確認したい場合は、こちらが索引になります。
→ 今さら聞けないAI用語30選
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
よくある質問(FAQ)
Q. AIとは何ですか?
A. 人間の知的な作業をコンピュータに行わせる技術の総称です。共通の定義はなく、ルールベースのプログラムから生成AIまで、幅の広いものが同じ言葉で呼ばれています。
Q. AIと機械学習と生成AIの関係は?
A. 入れ子の関係です。AIという総称の中に機械学習があり、その中にディープラーニングがあり、その技術で作られたものが生成AIです。
Q. AIは自分で考えているのですか?
A. 人間のような理解や思考をしているわけではありません。大量の学習をもとに、もっともらしい答えを確率的に組み立てています。そのため、事実でないことを自信ありげに答えることがあります。
→ ハルシネーションとは|5段階でわかる用語解説
Q. AIブームはまた終わりますか?
A. 過去2回のブームは、人間がルールを書き切れない壁で止まりました。今回はデータから学ばせる方式に変わり、計算資源とデータ量もそろっているため、条件が異なります。ただし今後を断定できる材料はありません。
Q. 会社でAIを使うには、まず何から始めればよいですか?
A. 業務を工程に分解し、判断が単純で量の多い工程と、毎回ゼロから書いている工程を探すところからです。既製のツールや汎用チャットサービスの法人プランで効果を測り、足りない部分だけ作り込むのが費用対効果の面で無難です。
参考
以下の資料を参考に本文を作成しました。
総務省「令和8年版 情報通信白書」企業におけるAI利用の現状
https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r08/html/nd121110.html
総務省・経済産業省「AI事業者ガイドライン」(第1.2版 令和8年3月31日)
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html