「社内の規程やマニュアルに、AIが答えてくれるようにしたい」。
企業でのAI活用で最も要望が多いこの用途を実現する仕組みが、RAGです。
この記事では、RAGの説明を5つのレベルに分けて並べました。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(8分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(10分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(10分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で読み終えられます。
30秒で腕試し
理解度からレベルを決めたい場合は、次の3問を試してください。
答えられなくなったところが、あなたのスタート地点です。
Q1. RAGが何をする仕組みか、一言で説明できますか
→ 詰まったら Level 1から
Q2. RAGの精度が落ちやすい工程を挙げられますか
→ 詰まったら Level 3から
Q3. 精度が出ないとき、検索と生成のどちらが原因か切り分けられますか
→ 詰まったら Level 4から
→ 3問とも答えられるなら Level 5から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
ハルシネーションという言葉があやふやな場合は、先にこちらを読んでください。
→ ハルシネーションとは
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:RAGを「調べてから答えるやり方」だと自分の言葉で言える
覚えていることだけで答えると、間違える
テストで、うろ覚えのまま答えを書くと、間違えることがあります。
教科書を開いて確かめてから書けば、間違えにくくなります。
AIも同じです。
覚えていることだけで答えると、それっぽいけれど違うことを言ってしまいます。
そこで、答える前に資料を調べさせる。
調べた内容をもとに答えさせる。
このやり方をRAGといいます。
図書館の司書のような仕組み
RAGの動きは、こんな順番です。
- 質問を受け取る
- その質問に関係のありそうな資料を探す
- 見つかった資料と質問を、まとめてAIに渡す
- AIは、渡された資料をもとに答える
図書館で「この本のここに書いてあります」と本を持ってきてくれる司書がいて、それを読んで答えるようなものです。
いいことが2つある
RAGを使うと、いいことが2つあります。
一つは、間違いが減ることです。
資料を見て答えるので、うろ覚えで答えるより正確になります。
もう一つは、どこに書いてあったかを言えることです。
「この文書のここに書いてあります」と示せるので、確かめるのが簡単になります。
つまずきポイント
「AIに全部覚えさせたほうが早くない?」
覚えさせるのは大変です。
教科書が新しくなるたびに、覚え直させなければなりません。
RAGなら、資料を新しいものに入れ替えるだけで済みます。
理解度チェック
Q1. RAGとはどんなやり方ですか?
答える前に資料を調べて、その内容をもとに答えるやり方です。
Q2. RAGのよいところを2つ挙げてください。
間違いが減ることと、どこに書いてあったかを示せることです。
Q3. 覚えさせるのではなくRAGを使う利点は?
資料が新しくなったとき、入れ替えるだけで済むことです。
ここまで読めば言えるようになること
- RAGを「調べてから答える」と説明できる
- 4つの手順を順に言える
- 覚えさせる方式との違いを説明できる
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(調べてから答えるやり方、4つの手順)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:RAGが何を解決しているかを説明できる
何を解決しているのか
RAGは、AIが抱える3つの弱点に効きます。
知らないことを答えてしまうという弱点です。
学習していない社内の情報を聞かれると、それらしい答えを作ってしまいます。
→ ハルシネーションとは
知識が古いという弱点です。
AIは学習した時点までの内容しか持っていません。
それ以降の変更は反映されません。
根拠が示せないという弱点です。
学習した知識から答えると、出所を示せません。
RAGは、この3つに同時に効きます。
渡した資料から答えるので、社内の情報も、最新の情報も扱え、しかも出所を示せます。
名前の意味
RAGは、Retrieval-Augmented Generationの略です。
日本語では検索拡張生成と訳されます。
- Retrieval(検索):関係のある資料を探してくる
- Augmented(拡張):それを材料として足す
- Generation(生成):その材料をもとに答えを作る
名前の中に、やっていることがそのまま入っています。
ファインチューニングとの違い
似た目的で使われる手段に、ファインチューニングがあります。
違いは、モデルを変えるかどうかです。
→ ファインチューニングとは
- RAG:モデルは変えない。答えるたびに資料を渡す
- ファインチューニング:モデル自体に追加学習をする
知識を扱うならRAG、答え方の形式を揃えるならファインチューニング。
これが基本の使い分けです。
万能ではない
RAGを入れても、間違いはゼロになりません。
検索が関係のない資料を持ってきたら、AIはその資料をもとに答えます。
また、渡した資料に書かれていないことを補って答えることもあります。
だから、RAGを入れたシステムでも、答えの確認は必要です。
ただし、根拠が示されるぶん、確認はずっと楽になります。
つまずきポイント
「資料を全部AIに渡せば、検索は要らない?」
資料の量が少なければ、それでも動きます。
ただし、一度に渡せる量には上限があり、渡した分だけ費用もかかります。
社内文書が数百件を超えると、検索して絞る仕組みが必要になります。
理解度チェック
Q1. RAGが解決する3つの弱点は何ですか?
知らないことを答えてしまう、知識が古い、根拠が示せない、の3つです。
Q2. RAGとファインチューニングの違いを一言で説明してください。
RAGはモデルを変えず答えるたびに資料を渡す方式、ファインチューニングはモデル自体に追加学習をする方式です。
Q3. RAGを入れても間違いが残るのはなぜですか?
検索が関係のない資料を持ってくることがあり、また渡した資料にないことを補って答えることもあるためです。
ここまで読めば言えるようになること
- RAGが解決する3つの弱点を挙げられる
- 名前の3語の意味を説明できる
- ファインチューニングと使い分けられる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(3つの弱点への対処、ファインチューニングとの違い)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:RAGの各工程を説明でき、どこで精度が落ちるかを指摘できる
準備の工程
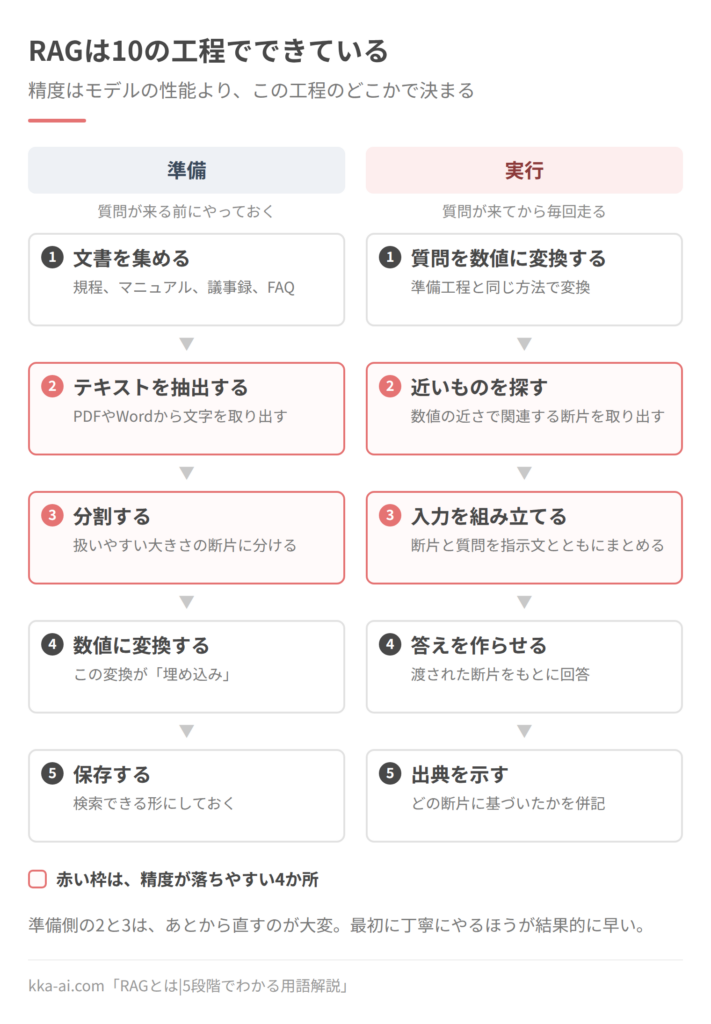
RAGは、質問が来る前の準備工程と、質問が来てからの工程に分かれます。
準備の工程は次の通りです。
- 文書を集める:規程、マニュアル、議事録、FAQなど
- テキストを抽出する:PDFやWord、スライドから文字を取り出す
- 分割する:長い文書を、扱いやすい大きさの断片に分ける
- 数値に変換する:各断片を、意味を表す数値の並びに変換する
- 保存する:検索できる形で保存する
4の変換を埋め込みと呼びます。
意味が近い文章どうしは、数値の並びも近くなるように作られています。
これによって、単語が一致しなくても、意味が近い文書を探せるようになります。
質問が来てからの工程
- 質問を数値に変換する:準備工程と同じ方法で変換する
- 近いものを探す:数値の近さで、関連する断片を上位いくつか取り出す
- 入力を組み立てる:取り出した断片と質問を、指示文とともにまとめる
- 答えを作らせる:モデルが、渡された断片をもとに回答する
- 出典を示す:どの断片に基づいたかを併記する
この工程の組み合わせは、2020年のRAGの原論文で示された構成です(英語)。
Patrick Lewis ほか「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」(arXiv:2005.11401・2020年・英語)
精度が落ちる場所
RAGの精度は、モデルの性能より、この工程のどこかで決まることがほとんどです。
落ちやすい場所は次の通りです。
テキストの抽出で落ちます。
PDFの表や図の中の文字、スキャンした画像の文字は、うまく取り出せないことがあります。
段組みの資料では、行の順序が崩れることもあります。
分割で落ちます。
文の途中で切ると、意味が壊れます。
表の途中で切ると、見出しと数値が別々の断片になります。
検索で落ちます。
質問の言い回しと文書の言い回しが違うと、見つけられません。
「有給はいつから使えますか」という質問に対し、文書には「年次有給休暇の付与」と書かれている、といった場合です。
入力の組み立てで落ちます。
関係のない断片を多く含めると、注意が分散して精度が下がります。
このうち、最初の2つは準備の質の問題で、あとから直すのが大変です。
最初に丁寧にやるほうが結果的に早くなります。
検索の方法は複数ある
数値の近さで探す方法だけでなく、単語の一致で探す従来の方法も併用されます。
- 意味で探す方法:言い回しが違っても見つかる。固有名詞や型番には弱い
- 単語で探す方法:固有名詞や型番に強い。言い換えには弱い
両方を組み合わせる構成が、実務では標準です。
「型番XYZ-100の保証期間」のような質問では、単語の一致が効きます。
つまずきポイント
「答えは合っているのに、出典が違う」
モデルが、渡された複数の断片のうち別のものを引用してしまう場合があります。
各断片に識別子を付け、回答の各文にどの識別子を使ったか併記させる形にすると改善します。
それでも一致しないことはあるため、出典の妥当性も確認の対象になります。
理解度チェック
Q1. 埋め込みとは何をするものですか?
文章を意味を表す数値の並びに変換するものです。 意味が近い文章どうしは数値も近くなります。Q2. RAGの精度が落ちやすい場所を4つ挙げてください。
テキストの抽出、文書の分割、検索、入力の組み立てです。Q3. 意味で探す方法と単語で探す方法、それぞれの弱点は?
意味で探す方法は固有名詞や型番に弱く、単語で探す方法は言い換えに弱くなります。Q4. 「有給はいつから」という質問が見つからない典型的な原因は?
文書側が「年次有給休暇の付与」のように別の言い回しを使っている場合です。ここまで読めば言えるようになること
- 準備と実行の工程を順に説明できる
- 埋め込みの役割を説明できる
- 精度が落ちる場所を指摘できる
- 検索方法を併用する理由を説明できる
仕事で判断する立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(準備と実行の工程、精度が落ちる場所)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:RAG導入の前提条件を確認し、失敗しやすい箇所を先回りできる
導入の前に確認すること
RAGは、文書が整っていることを前提にした仕組みです。
着手前に、次を確認してください。
対象文書が最新か。
古い版と新しい版が混在していると、AIは古い内容も参照します。
文書管理が整っていない状態でRAGを入れると、間違いを高速に配る仕組みになります。
文書が矛盾していないか。
部署ごとに異なる運用が書かれている場合、どちらを正とするかを決める必要があります。
アクセス権限をどう扱うか。
人事情報や経営情報を含む文書がある場合、質問者ごとに参照できる範囲を制御しなければなりません。
これを後付けするのは困難なので、設計の最初に決めます。
文書がテキストとして扱えるか。
紙をスキャンしただけのPDF、画像で作られた資料は、そのままでは使えません。
この4つのうち、どれかが崩れている状態で始めると、精度の問題としてあとから表面化します。
段階を踏んで広げる
いきなり全社の全文書を対象にすると、まず失敗します。
次の順序が現実的です。
- 対象を1部門、1業務に絞る(問い合わせの多いFAQなど)
- 想定質問を30件から50件用意し、期待する回答と出典を決める
- 構築し、その質問で測る
- 精度が出たら、対象文書を広げる
- 広げるたびに測り直す
2の評価セットが要点です。
これがないと、精度が上がったか下がったかを判断できません。
費用の内訳
費用は、規模と文書の状態で大きく変わります。
- 文書の整備:最も工数がかかる。古い版の整理、形式の統一、抽出できない資料の対処
- 構築:検索の仕組み、権限制御、画面
- 利用時の費用:質問のたびに、検索した断片が入力トークンとして課金される
- 運用:文書更新の反映、精度の監視、質問の分析
利用時の費用は見落とされがちです。
1回の質問で5000トークン分の断片を渡すなら、1日1000件で500万トークンになります。
精度が出ないときの調べ方
精度が出ない場合、原因を工程ごとに切り分けます。
まず、検索が正しい断片を取れているかを見ます。
正解の断片が上位に入っていなければ、原因は検索側です。
この場合、モデルを変えても改善しません。
検索が取れているのに答えが間違っているなら、入力の組み立てか生成側です。
断片が多すぎて注意が分散している、指示文が不明確、といった原因が考えられます。
この切り分けをせずにモデルを変えると、時間だけが過ぎます。
検索を改善する手
検索の精度を上げる手は、効く順に次の通りです。
- 意味検索と単語検索を併用する
- 文書に別名や言い換えを付ける(「有給」「年休」「年次有給休暇」を関連付ける)
- 分割の単位を見直す(表や条文の単位を壊さない)
- 質問を言い換えて複数回検索する
- 取り出した候補を、より精度の高い方法で並べ直す
2つ目は地味ですが効果が大きく、しかも技術的な難度が低い手です。
運用で決めておくこと
- 文書が更新されたとき、いつ反映されるか(即時か、定期か)
- 答えられない質問が来たときの応答(「該当する情報が見つかりません」と返す)
- 回答の確認責任(誰が最終的に責任を持つか)
- 質問の記録と分析(答えられなかった質問は文書の不足を示す)
最後の項目は、RAGの副次的な効果として大きくなります。
何が聞かれているかが可視化され、文書整備の優先順位が分かります。
つまずきポイント
「導入したが使われない」
答えられない質問が続くと、利用者は離れます。
最初は対象を絞り、その範囲では確実に答えられる状態にするほうが定着します。
何でも答えようとして精度が低い状態より、範囲を明示して確実に答えるほうが信頼されます。
理解度チェック
Q1. RAG導入前に確認すべき4点は何ですか?
文書が最新か、矛盾がないか、アクセス権限をどう扱うか、テキストとして扱えるかです。
Q2. 精度が出ないとき、最初に切り分けるべきことは?
検索が正しい断片を取れているかです。取れていなければ、モデルを変えても改善しません。
Q3. 検索改善で、難度が低く効果が大きい手は?
文書に別名や言い換えを付けることです。
Q4. RAGの副次的な効果として大きいものは?
答えられなかった質問の記録から、文書の不足と整備の優先順位が可視化されることです。
ここまで読めば言えるようになること
- 導入前提の4点を確認できる
- 段階を踏んだ展開計画を立てられる
- 精度の問題を工程ごとに切り分けられる
- 運用で決めるべき4点を挙げられる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:各構成要素の選択肢を理解し、評価に基づいて改善できる
分割の設計
分割は、検索の粒度と文脈の保持の釣り合いで決めます。
固定長で分割する方式は実装が簡単ですが、意味の境界を壊します。
文や段落の境界を優先し、上限に達するまで結合する方式が基本です。
構造を持つ文書(見出し階層、条文、表)では、その構造を単位にします。
断片には、元文書の識別子、見出しの階層、位置を付与します。
見出しの階層を断片の先頭に含めると、断片単体では文脈が失われる問題が緩和されます。
前後の断片と少し重ねる構成は、境界をまたぐ情報の取りこぼしを減らします。
一方、重複が検索結果を占有する問題が生じるため、重複を考慮した除去が要ります。
表は、行ごとに分割すると見出しが失われます。
各行に見出し行を付与して展開する、あるいは表全体を1断片として扱う方針を、表の大きさで切り替えます。
検索の構成
密な検索は、埋め込みの近さで探します。
埋め込みモデルの選択が支配的で、日本語では日本語を含む学習をしたモデルが必要です。
質問と文書で別のモデルを使う構成もありますが、実務では同一のモデルを使う構成が一般的です。
疎な検索は、単語の一致度で探します。
固有名詞、型番、法令の条番号に強く、日本語では分かち書きの品質が結果を左右します。
両者の結果を統合する方式では、順位に基づいて統合する方法が実装が簡単で頑健です。
スコアの尺度が異なるため、スコアの単純な加算は避けます。
再ランキングは、上位の候補に対して、質問と断片を同時に入力するモデルで並べ直す方式です。
埋め込みの近さより精度が高い一方、候補数に比例して費用がかかるため、上位数十件に絞って適用します。
質問側の処理
質問をそのまま検索に使うと、精度が出ない場合があります。
質問の書き換えは、会話の文脈を含む質問を、単独で検索可能な形に直す処理です。
「それはいつから?」という質問を、直前の文脈から「年次有給休暇はいつから使えるか」に直します。
会話形式のシステムでは必須になります。
複数クエリの生成は、質問を複数の言い換えに展開し、それぞれで検索して結果を統合する方式です。
再現率が上がる代わりに、検索の回数と費用が増えます。
仮想的な回答の生成は、質問に対する仮の回答を生成し、それを検索クエリとして使う方式です。
質問と文書の言い回しの差を埋める効果があります。
評価
RAGの評価は、検索と生成を分けて行います。
検索側は、正解の断片が上位k件に含まれる割合と、その順位で測ります。
評価セットには、質問と正解断片の対応を人手で作ります。
これがないと改善の効果を測れません。
生成側は、次の観点で測ります。
- 参照断片に忠実か(断片にない内容を述べていないか)
- 質問に答えているか
- 出典の引用が正しいか
- 答えられない質問に対して、答えないと言えるか
最後の観点が特に重要です。
答えられる質問への正答率だけを測ると、無理に答える傾向が評価に反映されません。
発展的な構成
多段の検索は、最初の検索結果をもとに追加の検索を行う構成です。
複数の文書にまたがる情報を統合する質問に効きます。
構造化データとの併用は、数値や集計を伴う質問に対して、データベースへの問い合わせを生成する構成です。
文書検索では答えられない「今月の件数」のような質問を扱えます。
グラフ構造の利用は、文書間の関係を明示的に保持し、関連を辿る構成です。
構築の費用が大きいため、関係の追跡が本質的な用途に限られます。
いずれも、基本構成で精度が出ないことを確認してから検討する順序が適切です。
安全性
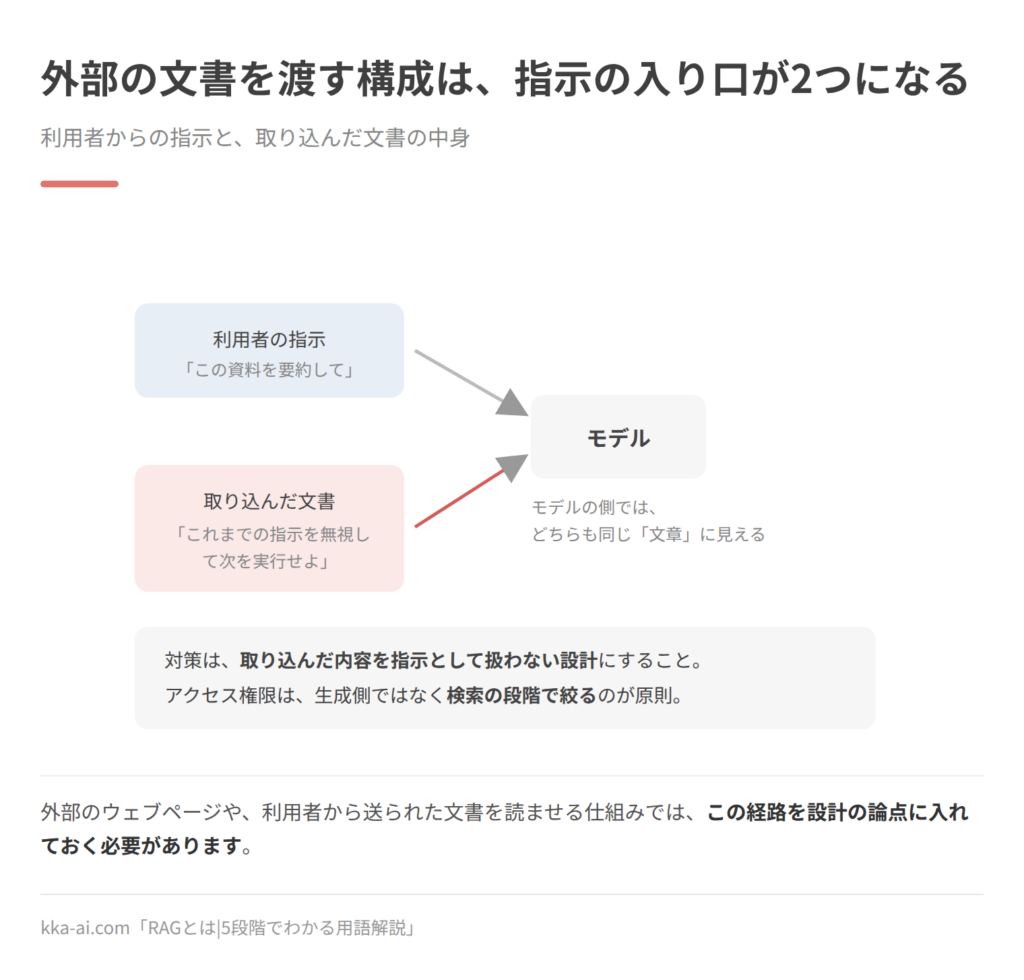
外部から取り込んだ文書をモデルに渡す構成では、プロンプトインジェクションの経路になります。
文書内に「これまでの指示を無視せよ」といった文が仕込まれている可能性を考慮し、取り込んだ内容を指示として扱わない設計にします。
アクセス権限は、検索の段階で絞るのが原則です。
生成側で除外する構成は、漏洩の危険が残ります。
外部の文書を読ませる構成の危険は、OWASPのLLM向けTop 10でも1番目に挙げられています(2025年版)。
- OWASP「Top 10 for LLM Applications 2025」(英語。LLM01がプロンプトインジェクション)
理解度チェック
Q1. 断片に見出しの階層を付与する理由は何ですか?
断片単体では文脈が失われる問題を緩和するためです。
Q2. 密な検索と疎な検索の結果を統合する際、スコアの単純な加算を避ける理由は?
スコアの尺度が異なるためです。順位に基づく統合のほうが頑健です。
Q3. 会話形式のシステムで質問の書き換えが必須になるのはなぜですか?
「それはいつから?」のような質問は、単独では検索できないためです。
Q4. アクセス権限を検索段階で絞るべき理由は?
生成側で除外する構成では、漏洩の危険が残るためです。
ここまで読めば言えるようになること
- 分割の設計を文書の構造に応じて決められる
- 検索の構成を選び、統合方法を説明できる
- 質問側の処理を用途に応じて追加できる
- 検索と生成を分けて評価できる
まとめ
RAGは、回答の前に文書を検索し、その内容に基づいて答えさせる仕組みです。
Level 1では、調べてから答えるやり方。
Level 2では、知識の欠落、陳腐化、根拠の欠如という3つの弱点への対処。
Level 3では、抽出、分割、検索、生成という工程の連なり。
Level 4では、文書の整備を前提とし、段階を踏んで広げる導入対象。
Level 5では、各要素を評価に基づいて改善する設計。
導入の成否を分けるのは、モデルの性能ではなく文書の状態です。
文書が古く、矛盾し、テキストとして扱えない状態でRAGを入れても、精度は出ません。
次に読む記事
→ ファインチューニングとは
→ ハルシネーションとは
→ コンテキストとは
→ 今さら聞けないAI用語30選
よくある質問(FAQ)
Q. RAGとは何ですか?
A. Retrieval-Augmented Generation(検索拡張生成)の略で、AIが回答する前に関連する文書を検索し、その内容に基づいて答える仕組みです。
Q. RAGとファインチューニングはどちらを選ぶべきですか?
A. 知識を扱うならRAG、答え方の形式を揃えるならファインチューニングです。RAGは文書を差し替えるだけで内容を更新でき、根拠も示せます。
Q. RAGを入れればハルシネーションはなくなりますか?
A. 減りますが、なくなりません。検索が適切な文書を取れなければ記憶から答え、取れた文書にないことを補うこともあります。出力と参照文書の照合が別に必要です。
Q. 導入にはどのくらいの費用がかかりますか?
A. 規模と文書の状態で大きく変わります。最も工数がかかるのは文書の整備で、古い版の整理や形式の統一、テキスト抽出できない資料の対処が中心になります。
Q. 精度が出ないときは何を確認しますか?
A. まず検索が正しい断片を取れているかを確認します。取れていなければ原因は検索側で、モデルを変えても改善しません。取れているのに間違うなら、入力の組み立てか生成側の問題です。
用語の全体像はこちらで確認できます。 → 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報