「推論コスト」「推論の高速化」「推論用チップ」。
AIのニュースで推論という言葉が出てきたら、それはAIを使うたびにかかる費用と速度の話をしています。
日常語の推論(推し量って結論を出すこと)とは、指しているものが少し違います。
この記事では、その中身を5つのレベルに分けて並べました。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(7分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(9分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(9分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で読み終えられます。
30秒で腕試し
理解度から自分のレベルを判断したい場合は、次の3問に答えてください。
答えられなくなったところが、あなたのスタート地点です。
Q1. 私たちがAIに質問しているとき、動いているのは学習と推論のどちらですか
→ 詰まったら Level 1から
Q2. 会話が長くなるほど遅く、高くなる理由を説明できますか
→ 詰まったら Level 3から
Q3. APIの費用を、会話履歴の累積まで含めて見積もれますか
→ 詰まったら Level 4から
→ 3問とも答えられるなら Level 5から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
学習という言葉のほうがあやふやな場合は、先にこちらを読んでください。
→ AIの「学習」とは|5段階でわかる用語解説
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:推論を「勉強したことを使って、実際に答えを出すこと」だと言える
勉強するときと、使うとき
自転車の練習を思い出してください。
何度も転びながら乗れるようになるまでが練習です。
そして、乗れるようになったあと、買い物に行くために自転車をこぐのが本番です。
AIにも、この2つがあります。
練習にあたるのが学習です。
たくさんの例を見て、まちがえながら賢くなる作業でした。
本番にあたるのが推論です。
勉強したことを使って、実際に答えを出すことをいいます。
私たちがAIに質問して答えが返ってくるとき、動いているのは推論のほうです。
こぐたびに、力が要る
自転車は、こぐたびに足の力が要ります。
一度乗れるようになったからといって、あとは勝手に進むわけではありません。
AIも同じです。
質問に答えるたびに、計算機が動いて電気を使います。
質問が1回なら大したことはありませんが、世界中の人が毎日何億回も質問すると、ものすごい量になります。
だから「推論コスト」、つまり答えを出すたびにかかる費用が、大きな問題として話題になります。
長い答えほど、時間がかかる
AIが文章を作るとき、一気に全部できあがるわけではありません。
少しずつ、前から順に作っていきます。
だから、長い答えほど時間がかかります。
画面に文字が少しずつ出てくるのは、まさに今作っているところだからです。
つまずきポイント
「学習と推論、どっちが大変?」
1回ずつを比べると、学習のほうがはるかに大変です。
でも、推論は何億回も繰り返されます。
全部を合わせると、推論のほうが多くの電気を使うこともあります。
理解度チェック
Q1. 推論とは何ですか?
学習したことを使って、実際に答えを出すことです。
Q2. 私たちがAIに質問しているとき、動いているのはどちらですか?
推論です。
Q3. 文字が少しずつ画面に出てくるのはなぜですか?
答えを前から順に少しずつ作っているからです。
ここまで読めば言えるようになること
- 学習と推論を練習と本番のたとえで説明できる
- 推論のたびに費用がかかると説明できる
- 長い答えほど時間がかかる理由を言える
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(練習と本番の違い、推論のたびに費用がかかること)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:推論の速度と費用が何で決まるかを説明できる
推論は、トークンを1つずつ作る
文章を作るAIは、トークンという単位で出力します。
トークンは、単語や単語のかけらにあたる細かい単位です。
→ トークンとは|AIの料金と文字数制限を決める単位
推論では、これまでの内容から次のトークンを1つ選び、それを含めた内容から次のトークンを選ぶ。
これを繰り返して文章ができあがります。
つまり、出力の長さがそのまま処理の回数になります。
「もっと詳しく」と頼めば、時間も費用も比例して増えます。
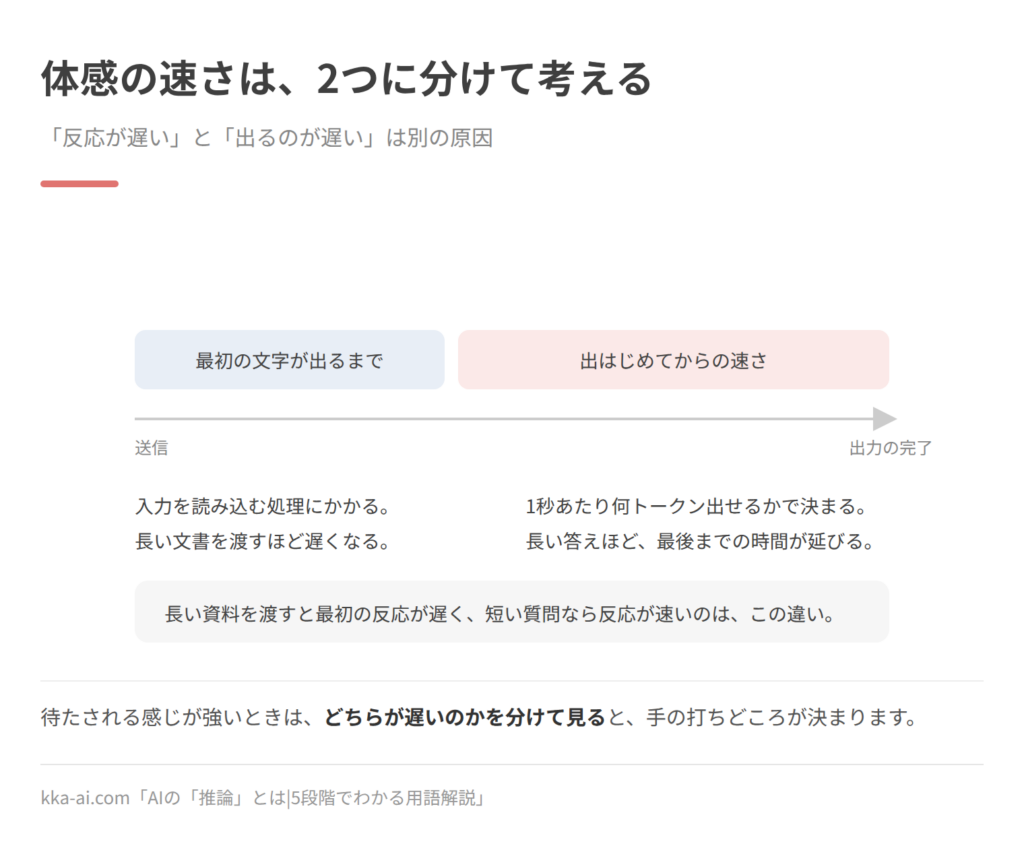
速度は2つに分けて考える
体感の速さは、2つの要素でできています。
一つは、最初の文字が出てくるまでの時間です。
入力を読み込む処理にかかり、長い文書を渡すほど遅くなります。
もう一つは、出はじめてからの速さです。
1秒あたり何トークン出せるかで決まります。
長い資料を渡すと最初の反応が遅く、短い質問なら反応が速いのは、この違いです。
費用も入力と出力に分かれる
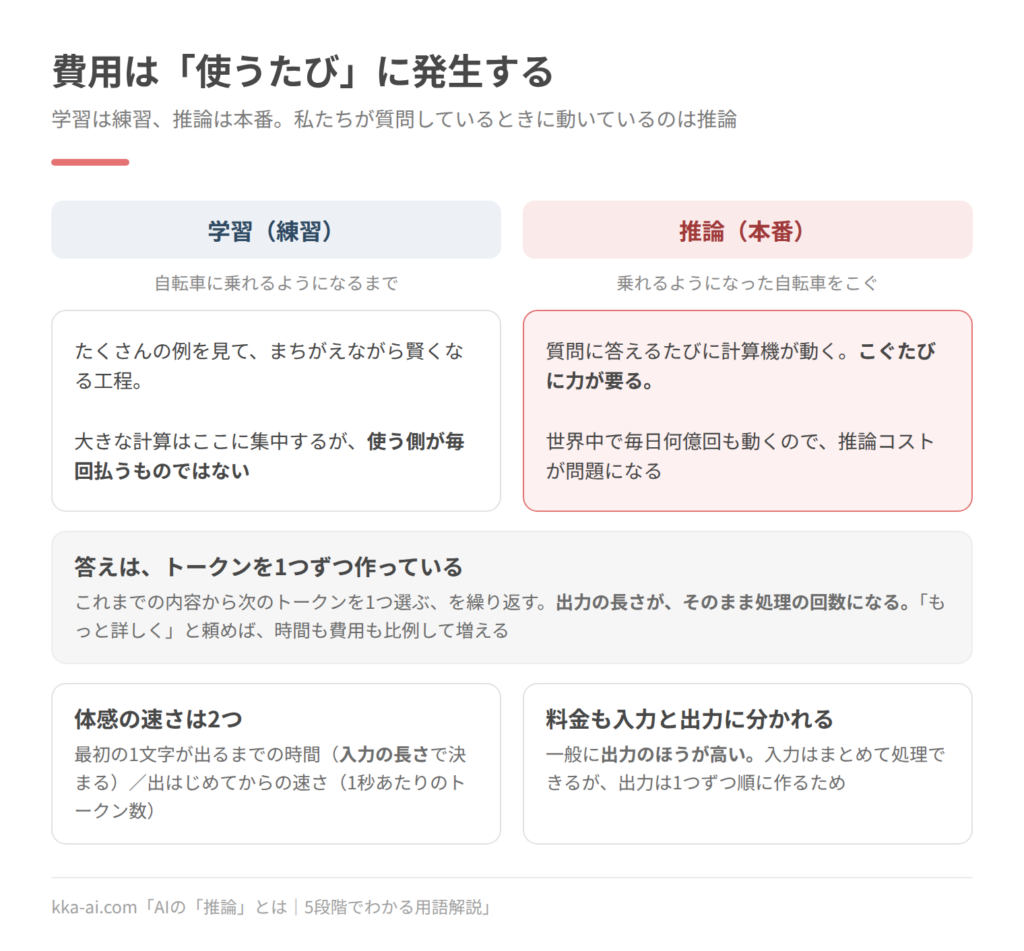
APIを使う場合、料金は処理したトークン数で決まります。
入力と出力で単価が異なり、一般に出力のほうが高く設定されます。
これは、入力がまとめて処理できるのに対し、出力は1つずつ順に作る必要があるためです。
仕組みの違いが、そのまま値段に表れています。
推論を重視したモデルは、遅くて高い
最近は、答える前に段階を踏んで考えるモデルがあります。
複雑な問題での正確さは上がりますが、その「考えている」部分もトークンとして生成されているため、時間と費用は増えます。
簡単な質問にこの種のモデルを使うのは、費用の面で無駄になります。
質問の性質に応じて使い分けるのが基本です。
つまずきポイント
「同じ質問なのに、日によって速さが違う」
サービス側の混雑によって、割り当てられる計算資源が変わることがあります。
また、混雑時に軽いモデルへ切り替わる運用もあります。
自分の使い方が変わっていないのに速さが変わる場合、多くはサービス側の事情です。
理解度チェック
Q1. 推論の処理回数は何で決まりますか?
出力するトークンの数です。長い出力ほど処理回数が増えます。
Q2. 最初の反応が遅くなるのはどんなときですか?
長い文書を入力したときです。入力を読み込む処理に時間がかかります。
Q3. 出力の単価が入力より高いのはなぜですか?
入力はまとめて処理できるのに対し、出力は1トークンずつ順に作る必要があるためです。
ここまで読めば言えるようになること
- 出力の長さが費用と時間に直結すると説明できる
- 速度を2つの要素に分けて説明できる
- 推論重視のモデルの使いどころを判断できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(トークン単位の生成、速度と費用の決まり方)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:推論がなぜ計算資源を要するのかを、仕組みから説明できる
2つの段階に分かれている
文章生成の推論は、性質の異なる2つの段階からなります。
入力を読み込む段階では、渡された文章全体をまとめて処理できます。
並列に計算できるため、計算装置の性能を使い切れます。
出力を作る段階では、1トークンずつ順に生成します。
1つ前の結果が決まらないと次に進めないため、並列化できません。
この段階では、計算そのものより、モデルの重みをメモリから読み出す速度が制約になります。
同じ計算装置でも、この2つの段階では効率がまったく違います。
推論基盤の設計が難しいのは、この非対称性が理由です。
繰り返しの計算を避ける仕組み
1トークン生成するたびに、それまでの文章をすべて計算し直すのは無駄です。
そこで、過去の部分の中間結果を保存しておき、再利用します。
この保存されたものがKVキャッシュです。
これによって生成の計算量は大幅に減りますが、代わりにメモリを消費します。
消費量は、文章の長さと、同時に処理している要求の数に比例します。
長い文脈を扱うことと、多数の利用者を同時にさばくことが、メモリの上で衝突する。
これが推論基盤の中心的な制約です。
コンテキストが長いほど高くつく理由
長い文脈が高くつく理由は2つあります。
一つは、入力トークン数がそのまま課金対象になることです。
もう一つは、KVキャッシュのメモリ消費が増え、同時に処理できる要求の数が減ることです。
会話を続けるほど遅く、高くなるのはこのためです。
話題が変わったら新しい会話を始めるのは、体感の速度と費用の両方に効果的です。
→ コンテキスト(文脈)とは|5段階でわかる用語解説
費用を下げる方向
推論の費用を下げる手段は、大きく3つです。
軽いモデルを使うのが最も直接的です。
分類や抽出のような単純な処理には、小さなモデルで十分なことが多くなります。
出力を短くするのも効果的です。
必要な形式を指定し、余計な前置きを出さないよう指示するだけで、出力トークン数は減ります。
同じ処理を繰り返さない設計も有効です。
同じ質問が繰り返される用途では、結果を保存して再利用します。
手元で動かすという選択肢
小さなモデルであれば、手元のパソコンやスマートフォンでも推論できます。
外部に情報を送らずに済み、通信の待ち時間もありません。
一方、性能は規模に制約され、機器の性能に依存します。
機密性が高く、かつ処理が単純な用途では、有力な選択肢になります。
つまずきポイント
「推論用のチップ、という話は何?」
学習と推論では、求められる性能が違います。
学習は大量の並列計算が中心ですが、推論の生成段階ではメモリからの読み出し速度が重要です。
このため、推論に特化した設計の計算装置が開発されています。
ニュースで推論用チップの話が出るのは、この性質の違いが背景にあります。
理解度チェック
Q1. 推論の2つの段階の違いを説明してください。
入力を読み込む段階は並列に処理できますが、出力を作る段階は1トークンずつ順に生成するため並列化できません。
Q2. KVキャッシュは何のためのものですか?
過去の部分の中間結果を保存して再利用し、生成のたびに全体を計算し直す無駄を避けるためです。
Q3. 長い文脈が高くつく理由を2つ挙げてください。
入力トークン数がそのまま課金されることと、KVキャッシュのメモリ消費が増えて同時処理数が減ることです。
Q4. 推論の費用を下げる手段を3つ挙げてください。
軽いモデルを使う、出力を短くする、同じ処理の結果を保存して再利用する、です。
ここまで読めば言えるようになること
- 推論の2段階の非対称性を説明できる
- KVキャッシュとメモリの関係を説明できる
- 費用を下げる手段を3つ挙げられる
仕事で判断する立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(2段階の処理、KVキャッシュ、長い文脈の代償)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:推論の費用と速度を見積もり、要件に合わせて設計できる
費用の見積もり方
APIを使う場合の見積もりは、次の順で立てます。
- 1件あたりの入力文字数と出力文字数を見積もる
- 日本語ではおおむね1文字から2文字で1トークンとして換算する
- 想定件数を掛ける
- 会話の履歴を毎回送る設計なら、その累積分を上乗せする
- 再試行や失敗分を見込む
4を忘れると、実際の請求が想定を大きく超えます。
10往復する会話では、最後の要求で最初の9往復分がすべて入力トークンとして課金されます。
5も見落とされがちです。
出力形式が崩れて再生成する、タイムアウトで再送する、といった分が積み上がります。
応答時間の要件から設計する
用途によって、許容される応答時間は大きく異なります。
- 対話型の画面:最初の文字が1秒以内に出はじめないと待たされた感じになる
- 画面の裏で走る処理:数秒から数十秒でも問題にならない
- 夜間の一括処理:分単位でも構わない
対話型では、生成の途中経過を逐次表示する方式が効果的です。
全部できあがってから出すより、体感の待ち時間が大幅に短くなります。
実際の完了時間は変わらなくても、利用者の評価は変わります。
裏で走る処理や一括処理では、まとめて送る方式のほうが効率が上がります。
単価が下がる仕組みを用意している事業者もあるため、要件が許すなら検討する価値があります。
処理ごとにモデルを使い分ける
費用対効果で最も大きいのが、処理ごとの使い分けです。
- 分類、抽出、判定:軽量なモデル
- 文章の作成、要約:標準的なモデル
- 複雑な判断、計算、多段の推論:推論重視のモデル
全件を高性能なモデルで処理すると、費用は簡単に数倍になります。
まず軽量なモデルで処理し、自信のない判定だけ上位のモデルに回す設計も有効です。
自社環境で動かす場合の判断
処理件数が大きい場合、自社環境で動かすほうが安くなる分岐点があります。
GPUの調達費用または借用費用に対して、APIの従量課金がどこで上回るかを計算します。
ただし、次の費用も含める必要があります。
- 運用の人件費(監視、更新、障害対応)
- モデルの更新に追随する作業
- 冗長化のための余剰
件数が安定的に大きく、かつ処理内容が固定されている場合に有利になります。
件数が変動する用途では、従量課金のほうが適しています。
監視すべき指標
推論を組み込んだシステムでは、次を監視します。
- 最初の応答までの時間と、完了までの時間(平均ではなく上位の遅い側を見る)
- 1件あたりのトークン数(入力と出力を分けて)
- 失敗率と再試行率
- 日次の費用
平均だけを見ると、一部の利用者が体験している遅さを見逃します。
遅い側の分布を見るのが要点です。
つまずきポイント
「試算より請求が多い」
確認する順序は次の通りです。
まず、会話履歴の累積が計算に入っているか。
次に、システムプロンプト(毎回先頭に付ける指示)の長さが入っているか。
そして、再試行の分が入っているか。
この3つで、想定の数倍になることがよくあります。
理解度チェック
Q1. 費用の見積もりで最も見落とされやすい要素は?
会話履歴の累積です。
往復が増えるほど、過去のやり取りすべてが入力トークンとして課金されます。
Q2. 対話型の画面で体感の待ち時間を下げる方法は?
生成の途中経過を逐次表示することです。
完了時間は変わりませんが、体感は大きく変わります。
Q3. 自社環境での運用が有利になる条件は?
処理件数が安定的に大きく、処理内容が固定されている場合です。
件数が変動する用途では従量課金が適します。
Q4. 応答時間の監視で、平均だけを見てはいけない理由は?
一部の利用者が体験している遅さを見逃すためです。
遅い側の分布を見る必要があります。
ここまで読めば言えるようになること
- 履歴と再試行を含めた費用を見積もれる
- 用途ごとの応答時間要件を設定できる
- 処理ごとのモデル使い分けを設計できる
- 監視すべき指標を挙げられる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:推論のスループットと遅延を、資源制約から説明し最適化できる
律速要因の切り分け
推論の性能は、段階ごとに異なる資源で律速されます。
入力を処理する段階は、行列積が主体で計算能力に律速されます。
バッチを大きくすると計算装置の利用率が上がります。
出力を生成する段階は、1トークンごとに全パラメータを読み出す必要があるため、メモリ帯域に律速されます。
バッチサイズが小さいと、読み出した重みを1件分にしか使えず、利用率が著しく下がります。
複数の要求をまとめることで、同じ読み出しを複数件に使い回せます。
つまり、生成段階の効率はバッチサイズにほぼ比例して改善します。
これが、推論基盤でバッチングが決定的に重要な理由です。
バッチングとメモリ管理
固定的なバッチでは、要求の到着時刻と長さがそろわないため効率が落ちます。
到着した要求を随時バッチに加え、完了したものから抜ける連続バッチングが標準です。
バッチサイズを上げる制約になるのがKVキャッシュです。
消費量は、層数、注意ヘッド数、ヘッド次元、系列長、バッチサイズの積に比例します。
連続した領域を確保する素朴な実装では断片化が起き、実効的なバッチサイズが上がりません。
固定サイズのブロック単位で管理し、論理的な連続性と物理的な配置を分離する方式によって、断片化を抑えられます。
KVキャッシュ自体を削る手法もあります。
複数の注意ヘッドで鍵と値を共有する構成は、キャッシュ量を大きく削減します。
キャッシュの量子化も併用されます。
KVキャッシュをブロック単位で管理する方式は、2023年のPagedAttentionの論文で示されたものです。
Woosuk Kwon ほか「Efficient Memory Management for Large Language Model Serving with PagedAttention」(arXiv:2309.06180・2023年・英語)
投機的な生成
生成が逐次的である制約を緩める手法として、投機的復号があります。
小さなモデルで複数トークンを先読みし、大きなモデルでまとめて検証して、一致した分をまとめて確定します。
検証はまとめて並列に実行できるため、出力分布を変えずに実効的な生成速度を上げられます。
効果は、先読みの一致率に依存します。
一致率が低いと破棄が増え、利得が失われます。
小さいモデルで先に候補を作る方式は、2022年の論文が出発点です。
Yaniv Leviathan ほか「Fast Inference from Transformers via Speculative Decoding」(arXiv:2211.17192・2022年・英語)
前置きの再利用
多数の要求が共通の長い先頭部分(システムプロンプト、共通の文脈)を持つ場合、その部分のKVキャッシュを再利用できます。
先頭が一致する範囲でキャッシュを共有する方式により、入力処理の計算を大幅に削減できます。
この設計を活かすには、変動する部分を先頭ではなく後方に置くプロンプト設計が要ります。
利用者ごとの情報を先頭に置くと、共有できる範囲がなくなります。
量子化の推論への影響
推論時の量子化は、メモリ消費と帯域の両方を削るため、生成段階に直接効果的です。
重みのみを量子化する方式は、生成段階のメモリ帯域制約を緩和します。
活性も量子化する方式は計算能力を向上させますが、精度への影響が大きくなります。
量子化の影響は用途によって異なるため、自社の評価セットでの確認が前提です。
長文の生成や、桁の多い数値を扱う処理で劣化が出やすい傾向があります。
遅延の設計
サービスの遅延目標は、次の分解で設計します。
- 最初のトークンまでの時間:入力長とバッチの待ち時間に依存
- トークン間の時間:バッチサイズとメモリ帯域に依存
- 完了までの時間:出力長との積
スループットと遅延は相反します。
バッチを大きくすればスループットは上がりますが、個々の要求の待ち時間は伸びます。
対話用途と一括処理用途を同じ推論基盤で混在させると、この相反が表面化します。
用途ごとに基盤を分けるか、優先度制御を入れる設計が要ります。
理解度チェック
Q1. 生成段階がメモリ帯域に律速されるのはなぜですか?
1トークンごとに全パラメータを読み出す必要があり、バッチサイズが小さいと読み出した重みを少数の件にしか使えないためです。
Q2. KVキャッシュをブロック単位で管理する利点は?
断片化を抑え、実効的なバッチサイズを上げられることです。
Q3. 投機的復号が出力分布を変えずに高速化できるのはなぜですか?
小さなモデルの先読みを大きなモデルでまとめて検証し、一致した分だけを確定するためです。
Q4. 前置きのキャッシュ再利用を活かすプロンプト設計の要点は?
共通する部分を先頭に、要求ごとに変動する部分を後方に置くことです。
ここまで読めば言えるようになること
- 段階ごとの律速要因を切り分けられる
- バッチングとKVキャッシュ管理の関係を説明できる
- 投機的復号とキャッシュ再利用の適用条件を判断できる
- スループットと遅延の相反を設計に織り込める
まとめ
推論は、学習済みのモデルを使って実際に答えを出す工程です。
Level 1では、練習に対する本番。
Level 2では、トークン数で時間と費用が決まる工程。
Level 3では、入力処理と生成で性質が異なり、KVキャッシュがメモリを食う仕組み。
Level 4では、履歴と再試行まで含めて見積もる対象。
Level 5では、メモリ帯域とバッチサイズの制約の中で最適化する設計。
学習は一度きりですが、推論は使うたびに走ります。
AIを業務に組み込むときに費用として現れるのは、ほぼ推論のほうです。
次に読む記事
→ AIの「学習」とは|5段階でわかる用語解説
→ トークンとは|AIの料金と文字数制限を決める単位
→ コンテキスト(文脈)とは|5段階でわかる用語解説
→ データセンターとは|AIで電力消費が倍増する仕組みと、2026年4月からの日本の新ルール【2026年版】
→ 今さら聞けないAI用語30選
よくある質問(FAQ)
Q. AIの推論とは何ですか?
A. 学習済みのモデルを使って、実際に入力から答えを出す工程です。私たちがAIを利用しているとき動いているのは推論です。
Q. 学習と推論はどちらが費用がかかりますか?
A. 1回あたりでは学習が圧倒的に大きくなります。ただし推論は使うたびに繰り返されるため、累計では推論のほうが大きくなることもあります。
Q. 推論コストとは何のことですか?
A. AIが答えを出すたびに発生する計算費用です。処理したトークン数で決まり、出力の長さと入力の長さの両方に効果的です。
Q. 会話が長くなると遅くなるのはなぜですか?
A. 過去のやり取りを毎回入力として送るため、入力の処理量が増えるためです。加えて、中間結果を保持するメモリの消費も増えます。
Q. 費用を下げるには何をすればよいですか?
A. 処理の性質に応じて軽量なモデルを使う、出力形式を指定して不要な出力を減らす、繰り返し同じ処理をしないよう結果を再利用する、の3つが基本です。
用語の全体像はこちらで確認できます。
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
参考
内容は2026年10月3日に、以下の資料で確認しました。
- Woosuk Kwon ほか「Efficient Memory Management for Large Language Model Serving with PagedAttention」(arXiv:2309.06180・2023年・英語)
- Yaniv Leviathan ほか「Fast Inference from Transformers via Speculative Decoding」(arXiv:2211.17192・2022年・英語)