「自社のデータでAIを育てたい」という要望が出たとき、最初に検討するのがファインチューニングです。
そして、多くの場合、実際には別の手段のほうが適しています。
本記事では、ファインチューニングの説明と、いつ使うべきかの線引きを5つのレベルに分けて並べました。
どこから読むか
本記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(7分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(9分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(9分)
迷ったらLevel 1から読んでください。知っている内容なら、数十秒で読めます。
30秒で腕試し
理解度からレベルを決めたい場合は、次の3問を試してください。
答えられなくなったところが、あなたのスタート地点です。
Q1. ファインチューニングが得意なのは、知識と答え方のどちらですか
→ 詰まったら Level 1から
Q2. 学習データで最も重要な性質は何か答えられますか
→ 詰まったら Level 3から
Q3. 自社でファインチューニングが本当に必要かどうか、判断できますか
→ 詰まったら Level 4から
→ 3問とも答えられるなら Level 5から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
AIにおける学習という言葉があやふやな場合は、先にこちらを読んでください。
→ 学習とは
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:ファインチューニングを「一通りできる人に、追加で教え込むこと」だと言える
転校生に、この学校のやり方を教える
転校してきた人を思い浮かべてください。勉強は一通りできます。でも、この学校の掃除の順番や、日直のやり方は知りません。
そこで、この学校のやり方だけを教えます。一から勉強を教え直すのではなく、足りない部分だけを教えるわけです。
AIにも、これと同じことができます。すでに一通りのことができるAIに、追加で教え込む。
これをファインチューニングといいます。
何が変わるのか
ファインチューニングをすると、AIの中身のつまみが少し動きます。つまり、AI本体が変わります。
そのため、教えたやり方が身につきます。毎回「こうしてね」と言わなくても、そのやり方で答えるようになります。
教えるのは、やり方であって知識ではない
ここが大事なところです。ファインチューニングが得意なのは、答え方の形を覚えさせることです。たとえば、決まった書式で答える、丁寧な言葉づかいで答える、といったことです。
反対に、新しい知識を覚えさせるのは苦手です。教えたはずのことを、うまく思い出せないことがあります。しかも、知識が変わるたびに教え直さなければなりません。知識を扱いたいときは、別の方法があります。そのつど資料を渡して「この中から答えて」と頼む方法です。
つまずきポイント
「ファインチューニングをすれば、AIが自分専用になる?」
答え方は自分好みにできます。でも、自分の持っている情報を全部覚えさせるのは向いていません。情報は、そのつど渡すほうが確実です。
理解度チェック
Q1. ファインチューニングとは何ですか?
すでに一通りできるAIに、追加で教え込むことです。
Q2. ファインチューニングが得意なのは何を覚えさせることですか?
答え方の形です。決まった書式や言葉づかいで答えさせることです。
Q3. 新しい知識を扱いたいとき、どうするのがよいですか?
そのつど資料を渡して、その中から答えてもらう方法です。
ここまで読めば言えるようになること
- ファインチューニングを追加の教え込みとして説明できる
- 得意なのは形式で、苦手なのが知識だと説明できる
- 知識には別の方法があると知っている
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(追加の教え込み、形式は得意で知識は苦手)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:ファインチューニングと他の手段を区別できる
AIを自分好みにする方法は3つある
AIに自分の望む答えをさせる方法は、手間の少ない順に3つあります。
プロンプトで指示する方法が最も手軽です。
「箇条書きで、300字以内で、専門用語を使わずに」と毎回書きます。
モデルは何も変わりませんが、多くの用途はこれで足ります。
→ プロンプトとは
資料を渡して答えさせる方法もあります。
質問のたびに関連する文書を検索して渡し、その中から答えさせます。
これをRAGといいます。
→ RAGとは
ファインチューニングは、モデル自体に追加学習をする方法です。
手間と費用は最も大きくなりますが、答え方の形が安定します。
使い分けの原則
3つの使い分けは、次のように考えます。
- 形式や口調を整えたい → まずプロンプト、それで安定しないならファインチューニング
- 知識を扱いたい → RAG
- 両方 → RAGを土台に、必要ならファインチューニングを重ねる
「知識ならRAG、形式ならファインチューニング」が使い分けの原則です。
なぜ知識に向かないのか
ファインチューニングで知識を教えても、うまくいかない理由が3つあります。
一つは、確実に出てくる保証がないことです。
学習させた内容が、質問の仕方によっては出てこないことがあります。
二つ目は、更新が大変なことです。
情報が変わるたびに学習をやり直すことになります。
三つ目は、根拠を示せないことです。
RAGなら「この文書に書いてあります」と示せますが、学習させた知識は出所が示せません。
業務では、三つ目の「根拠を示せない」という点が重要です。根拠を示せない回答は、確認の工数が大きくなります。
つまずきポイント
「ファインチューニングは高い?」
規模によります。
モデル全体を学習し直す方法は高くつきますが、一部だけを学習する効率的な手法を使えば、費用は大きく下がります。
実際には、学習そのものより、学習データを作る人手のほうが費用の中心になります。
理解度チェック
Q1. AIを自分好みにする3つの方法を、手間の少ない順に挙げてください。
プロンプトで指示する、資料を渡して答えさせる(RAG)、ファインチューニングの順です。
Q2. 知識を扱いたいときの基本の選択は?
RAGです。
Q3. ファインチューニングが知識に向かない理由を3つ挙げてください。
確実に出てくる保証がない、更新のたびに学習をやり直す必要がある、根拠を示せない、の3つです。
ここまで読めば言えるようになること
- 3つの手段を手間の順に並べられる
- 知識と形式で使い分けられる
- 知識に向かない理由を説明できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(プロンプト、RAG、ファインチューニングの使い分け)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:ファインチューニングの種類と、必要なデータの性質を説明できる
学習の段階の中での位置づけ
大規模なモデルの学習は、事前学習と事後学習に分かれます。
ファインチューニングは事後学習の一種、あるいはその後にさらに行う追加学習にあたります。
→ AIの「学習」とは|5段階でわかる用語解説
利用者が行うファインチューニングは、すでに事後学習まで済んだモデルに対して、さらに用途向けの調整を重ねる形になります。
全体を学習するか、一部だけか
方法は大きく2つに分かれます。
全パラメータの更新は、モデル全体を学習し直す方法です。
効果は大きい一方、計算資源が大きく必要で、元の汎用性能が落ちる危険もあります。
一部だけの更新は、元の重みを固定したまま、小さな追加部分だけを学習する方法です。
学習するパラメータが元の1%未満で済み、成果物も小さくなります。
現在では、こちらが主流です。
一部だけの更新なら、用途ごとに追加部分を作り分け、切り替えて使うこともできます。
学習データに求められるもの
ファインチューニングの成否は、データの質でほぼ決まります。求められるのは、量より一貫性です。
一貫性が最も重要です。
同じような入力に対して、担当者ごとに違う形式の出力が混ざっていると、モデルはその揺れごと学習します。
結果として、出力が安定しません。
多様性も必要です。
似たような入力ばかりだと、少し違う入力に対応できません。
件数は、用途によりますが、形式を整える目的なら数百件から数千件が一つの目安です。
ただし多ければ多いというわけではなく、一貫性がなければ効果は出ません。
データを作る前に、期待する出力の基準を文書にしましょう。複数人で作る場合は、同じ入力に対して各自が作った出力を比べ、揺れがあれば基準を直します。
効果と副作用
ファインチューニングにはメリットとデメリットがあります。
メリットとして挙げられる点は、出力形式の安定、指示文の短縮(毎回の指示が不要になる)、特定分野の言い回しへの適応です。
デメリットとしては、汎用的な能力が挙げられます。特定の形式に強く適合させると、それ以外の指示への応答が劣化します。
この現象を破滅的忘却と呼びます。
このため、学習の前後で、対象の用途だけでなく汎用の能力についても測る必要があります。
つまずきポイント
「ファインチューニングしたのに、期待した形式で出てこない」
確認する順序は3つです。
学習データの一貫性、件数、そして推論時のプロンプトが学習時と揃っているかです。
3つ目の推論時と学習時のプロンプトが揃っているかについては見落とされがちで、学習時と違う形式で質問すると、学習の効果が出ないことがあります。
理解度チェック
Q1. 全パラメータの更新と一部だけの更新、実務で主流なのはどちらですか?
一部だけの更新です。学習するパラメータが元の1%未満で済み、成果物も小さくなります。
Q2. 学習データで最も重要な性質は何ですか?
一貫性です。同じような入力に対する出力の形式が揃っていないと、その揺れごと学習します。
Q3. 破滅的忘却とは何ですか?
特定の形式に強く適合させることで、それ以外の指示への応答が劣化する現象です。
Q4. 期待した形式で出ないとき、見落とされやすい原因は?
推論時のプロンプトが学習時と揃っていないことです。
ここまで読めば言えるようになること
- 学習の段階の中で位置づけられる
- 全体更新と一部更新を区別できる
- 学習データに求められる性質を挙げられる
- 破滅的忘却を説明できる
仕事で判断する立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(全体更新と一部更新、データの一貫性、破滅的忘却)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:ファインチューニングが必要かを判断し、費用と維持負担を見積もれる
まず、不要である可能性を検討する
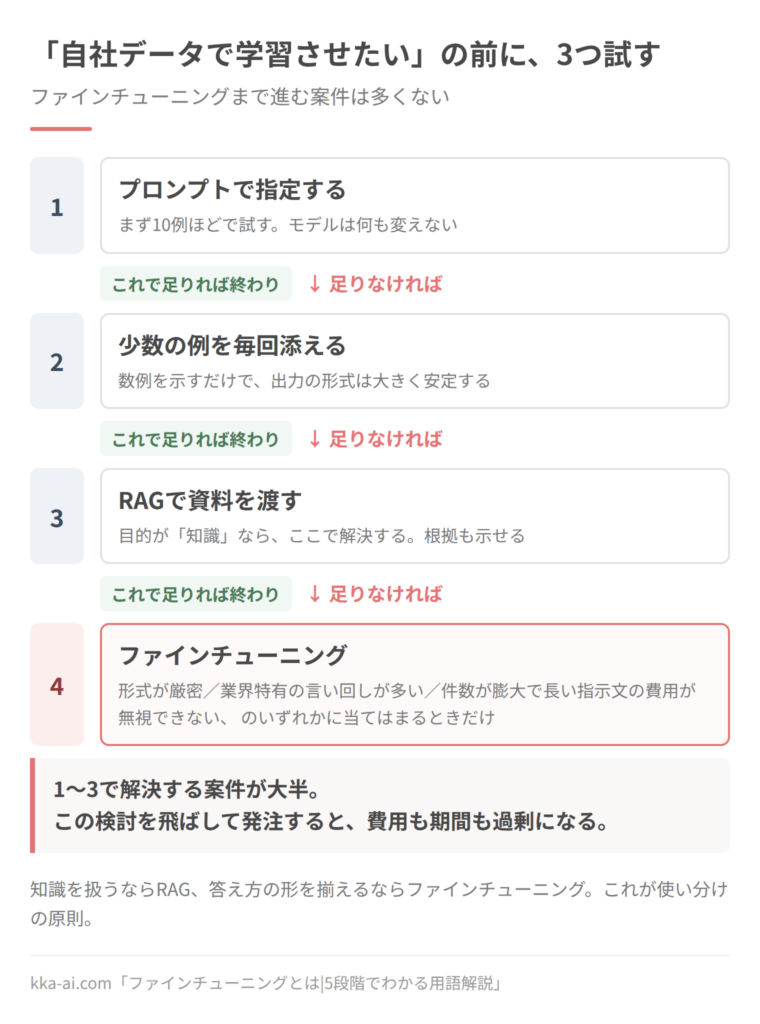
「自社データで学習させたい」という要望の多くは、ファインチューニング以外で解決します。
判定の順序は次の通りです。
- プロンプトの指定で足りないか。まず10例ほどで試す
- 少数の例を毎回添える方式で足りないか(数例を示すだけで形式は大きく安定します)
- 知識が目的なら、RAGで足りないか
- それでも足りないなら、ファインチューニングを検討する
1から3で解決する案件が大半です。
この検討を飛ばして発注すると、費用も期間も過剰になる恐れがあります。
必要になる条件
ファインチューニングが実際に必要になるのは、次の場合です。
- 出力の形式や語彙が、プロンプトでは安定しない水準まで厳密に決まっている
- 業界特有の言い回しが多く、汎用モデルの解釈が安定しない
- 処理件数が膨大で、長い指示文を毎回送る費用が無視できない
- 応答速度が要件で、長い指示文を読む時間が許容できない
毎回2000トークンの指示を送るより、その内容を学習させて短い指示で済ませるほうが、件数によっては安くなります。
費用の内訳
費用は、計算資源だけではありません。
- 学習データの作成:最も工数がかかる。期待する出力を人が作る作業
- 基準の文書化と一致率の確認:複数人で作る場合に必要
- 計算資源:一部だけを更新する手法なら大幅に下がる
- 評価:学習前後の比較。汎用能力の劣化確認を含む
- 再学習:データ追加時、基盤モデル更新時に繰り返す
見積もりでは、最初の2項目が現実的に積まれているかを確認してください。
維持の負担を先に見込む
ファインチューニングしたモデルには、維持の負担があります。
土台にした基盤モデルが更新されても、その恩恵を受けるには学習をやり直すことになります。
つまり、学習した時点の性能で固定される代わりに、以後の性能向上から取り残される可能性があります。
この観点では、RAGのほうが維持は容易です。
基盤モデルを差し替えても、検索対象の文書はそのまま使えます。
長期の運用を前提にするなら、「基盤モデルが更新されたとき誰が再学習するのか」を先に決めておいてください。
学習データの権利を確認する
自社データを学習に使う場合、次を法務と確認します。
- 顧客から預かったデータが、契約と利用目的の範囲内か
- 個人情報を含む場合、利用目的の変更にあたらないか
- 社内文書に含まれる他社の著作物の扱い
- 従業員に関するデータの扱い
外部の事業者に学習を委託する場合、学習データがその事業者の側でどう扱われるかも確認事項になります。
つまずきポイント
「効果があったのか分からない」
学習前の状態で測っていない可能性があります。
評価セットを先に作り、学習前のモデルで測ってから学習に入ってください。
比較対象がないと、効果の有無も、汎用能力の劣化も判定できません。
理解度チェック
Q1. ファインチューニングを検討する前に試すべき3段階は?
プロンプトの指定、少数の例を毎回添える方式、RAGの3つです。
Q2. ファインチューニングが費用面で有利になるのはどんな場合ですか?
処理件数が膨大で、長い指示文を毎回送る費用が無視できない場合です。
Q3. 維持の負担として、先に決めておくべきことは?
基盤モデルが更新されたとき、誰が再学習を実行するかです。
Q4. 効果を判定するために、学習前にすべきことは?
評価セットを作り、学習前のモデルで測っておくことです。
ここまで読めば言えるようになること
- 不要である可能性を先に判定できる
- 必要になる条件を4つ挙げられる
- 費用の内訳をデータ作成込みで見積もれる
- 維持の負担と権利の確認事項を挙げられる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:手法の選択と、劣化の管理を設計できる
手法の分類
教師ありファインチューニングは、指示と応答の組で学習させます。
応答部分にのみ損失を計算し、指示部分は損失から除外する構成が一般的です。
選好に基づく最適化は、応答の優劣に関する判断を反映させます。
報酬モデルを学習して強化学習で最適化する方式と、選好データから直接方策を最適化する方式があります。
後者は実装が簡素で、報酬モデルの誤差に起因する不安定さを避けられます。
用途に応じた形式の学習には前者、応答の質や安全性の調整には後者が使われます。
パラメータ効率的な手法
低ランク適応は、重み行列の更新を低ランクの積として表現し、その因子だけを学習します。
元の重みは固定するため、学習対象は元の1%未満で済みます。
設定の勘所は次の通りです。
適用対象は注意機構の投影行列が一般的で、フィードフォワード層にも広げる構成があります。
ランクは大きくすれば単調に良くなるわけではなく、8から64程度で十分なことが多くなります。
スケーリング係数とランクの比が実効的な学習率に効くため、両者を独立に動かすと結果が読みにくくなります。
量子化した基盤モデルの上で低ランク適応を行う構成により、限られたGPUメモリでも学習が可能になります。
学習後の追加部分は元の重みに統合でき、推論時の追加コストをなくせます。
少ないパラメータだけを学習させる代表的な手法がLoRAです
- Alec Radford ほか「Learning Transferable Visual Models From Natural Language Supervision (CLIP)」(arXiv:2103.00020・2021年・英語)
劣化の管理
追加学習は、元の能力を損なう危険を伴います。
管理の手段は次の通りです。
- 学習率を下げる(過度な適合を避ける)
- 汎用の指示データを一定割合混ぜる
- 元のモデルの出力分布から離れすぎないよう正則化する
- エポック数を抑える(小規模データでは1から3程度)
評価では、対象タスクの性能と汎用能力の両方を、学習前後で測ります。
汎用能力の評価を省くと、対象タスクの数値だけが上がって全体が劣化した状態を見逃します。
データの構築
学習データの構築で効くのは、次の点です。
形式の統一を、機械的に検査できる形にします。
JSON形式で出力させるなら、全件がスキーマに適合することを検証します。
重複と近似重複の除去を行います。
同じ内容が繰り返されると、その内容に過剰に適合します。
評価セットとの分離を厳密にします。
学習データと評価データに同じ事例が含まれていると、評価が実力を上回ります。
難易度の分布にも配慮します。
易しい例ばかりだと、難しい入力に対応できません。
大規模なモデルにデータを生成させる方式も広く使われますが、生成元の偏りと誤りを引き継ぐ点、および実データとの混合比率が論点になります。
運用
学習を繰り返す場合、次を版管理の対象にします。
- 学習データの版と生成手順
- ハイパーパラメータ
- 基盤モデルの識別子と版
- 評価セットと評価結果
推論時には、学習時と同じプロンプト形式を用いる必要があります。
形式が食い違うと、学習の効果が出ません。
学習データの構築と推論時の入力構築を、同じコードから生成する構成にすると事故が減ります。
理解度チェック
Q1. 教師ありファインチューニングで、損失をどこに計算しますか?
応答部分にのみ計算し、指示部分は損失から除外する構成が一般的です。
Q2. 低ランク適応でランクを上げても単調に良くならないのはなぜですか?
必要な表現力を超えると過剰適合の側に働くためで、8から64程度で十分なことが多くなります。
Q3. 汎用能力の評価を省くと何を見逃しますか?
対象タスクの数値だけが上がり、全体としては劣化している状態です。
Q4. 推論時に注意すべきプロンプトの条件は?
学習時と同じ形式を用いることです。食い違うと学習の効果が出ません。
ここまで読めば言えるようになること
- 手法を目的に応じて選べる
- 低ランク適応の設定の勘所を説明できる
- 劣化の管理手段を4つ挙げられる
- データ構築と運用の要点を設計できる
まとめ
ファインチューニングは、既存のモデルに追加学習を施して用途に合わせる手法です。
Level 1では、一通りできる人への追加の教え込み。
Level 2では、プロンプトとRAGに続く3番目の手段。
Level 3では、データの一貫性が成否を決める作業。
Level 4では、不要である可能性を先に潰してから検討する対象。
Level 5では、劣化の管理と版管理を伴う設計。
最も効果的なのは、Level 4の判定順序です。
プロンプト、少数例、RAGの3段階で解決する案件が大半で、ファインチューニングまで進むものは多くありません。
次に読む記事
→ RAGとは
→ 学習とは
→ AIのモデルとは
→ 今さら聞けないAI用語30選
よくある質問(FAQ)
Q. ファインチューニングとは何ですか?
A. すでに学習済みのモデルに追加の学習を施し、特定の用途に合わせて調整することです。モデル自体のパラメータが変わります。
Q. ファインチューニングとRAGの違いは何ですか?
A. ファインチューニングはモデル自体を変える手法で、答え方の形式を揃えるのに向きます。RAGは回答時に文書を検索して渡す手法で、知識を扱うのに向きます。
Q. 自社の知識を覚えさせたい場合、どちらを使いますか?
A. RAGです。ファインチューニングは更新のたびに学習し直す必要があり、学ばせた内容が確実に出てくる保証もなく、根拠も示せません。
Q. どのくらいのデータが必要ですか?
A. 用途によりますが、形式を整える目的なら数百件から数千件が一つの目安です。件数より、出力形式の一貫性のほうが成否を左右します。
Q. 費用はどのくらいかかりますか?
A. 計算資源は、一部のパラメータだけを更新する手法を使えば大きく下がります。費用の中心は、学習データを作る人手のほうになります。
用語の全体像はこちらで確認できます。理解度に合わせて5段階で読める用語解説も用意しています。
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報