AIを使ううえで、知っておくべき用語を1つだけ選ぶなら、本記事で説明する「ハルシネーション」です。
AIが事実でないことを、自信ありげに答える現象のことで、これを知らずに使うと、いつか必ず事故が起きます。
この記事では、ハルシネーションの説明を5つのレベルに分けて解説します。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(7分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(9分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(9分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で読み終えられます。
30秒で腕試し
理解度から自分のレベルを決めたい場合は、次の3問を試してください。
答えられなくなったところが、あなたのスタート地点です。
Q1. AIが知らないことを聞かれたとき、どう答えると思いますか
→ 詰まったら Level 1から
Q2. ハルシネーションが完全になくならない理由を、仕組みから説明できますか
→ 詰まったら Level 3から
Q3. 業務でAIの出力を確認するとき、何を確認項目にすべきか挙げられますか
→ 詰まったら Level 4から
→ 3問とも答えられるなら Level 5から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
AIの仕組みそのものがあやふやな場合は、先にこちらを読むと入りやすくなります。
→ LLM(大規模言語モデル)とは
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:AIが平気で間違えることを知り、確かめる習慣を持てる
知らないのに、答えてしまう
友だちに「この本、知ってる?」と聞いたとき、知らなければ「知らない」と言うはずです。
AIは、それを言いません。
知らないことを聞かれても、それっぽい答えを作って、堂々と返してきます。
これをハルシネーションといいます。
もともとは幻覚という意味の言葉です。
なぜ、そんなことが起きるのか
AIは、正しいことを探しているのではありません。
「この続きに来そうな言葉」を選んでいるだけです。
だから、実際にはない本の名前でも、それらしく聞こえる言葉が並べば、答えとして出てきます。
本人(AI)は、嘘をついているつもりもありません。
そもそも、正しいかどうかを確かめる仕組みを持っていないのです。
見分けるのが難しい
やっかいなのは、間違った答えも、正しい答えと同じ顔で出てくることです。
人なら、自信がないときは「たぶん」「よく知らないけど」と付けます。
AIは、知らないことも同じ調子で答えます。
だから、答えを見ただけでは見分けられません。
大事なことは、必ず自分で確かめる
ではどうすればよいかというと、確かめるしかありません。
特に、次の4つは要注意です。
- 人の名前
- 数字
- 日にち
- 本や記事の名前
この4つが出てきたら、必ず自分で調べる。
これが、AIを使う人みんなのルールです。
つまずきポイント
「AIは嘘をついているの?」
嘘をつこうとしているわけではありません。
嘘というのは、本当のことを知っていて違うことを言うことです。
AIは、そもそも本当のことを知らないまま、それっぽい答えを作っています。
理解度チェック
Q1. ハルシネーションとは何ですか?
AIが事実でないことを、もっともらしく自信ありげに答えてしまう現象です。
Q2. なぜそんなことが起きるのですか?
AIは正しいことを探しているのではなく、続きに来そうな言葉を選んでいるだけだからです。
Q3. 特に確かめるべき4つは何ですか?
人の名前、数字、日にち、本や記事の名前です。
ここまで読めば言えるようになること
- ハルシネーションが何かを説明できる
- 起きる理由を自分の言葉で言える
- 確かめるべき4項目を挙げられる
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(知らないことも答えてしまう性質、確かめるべき4項目)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:起きやすい場面を予測でき、確かめ方を使い分けられる
起きやすい場面がある
ハルシネーションは、どんな質問でも同じ確率で起きるわけではありません。
次の場面で起きやすくなります。
学習した時点より後の出来事を聞いたとき。
AIは学習した時点までの内容しか持っていません。
それ以降を聞かれると、それらしい答えを組み立てます。
細かい事実を聞いたとき。
統計の数値、条文の番号、論文の著者、製品の型番。
細部ほど、それらしい形の別のものが出てきやすくなります。
存在しないものを前提に聞いたとき。
「〇〇という本の第3章について教えて」と、存在しない本の名前で聞くと、内容を作って答えてしまうことがあります。
マイナーな話題を聞いたとき。
学習データに情報が少ないほど、埋め合わせが起きます。
確かめ方を使い分ける
確認の手間は、内容によって変えられます。
すぐ検索で確かめられるものは、そうします。
人名、書名、数値、日付は、検索一回で済みます。
根拠を出させる方法も有効です。
「その根拠はどこにありますか」と聞くと、出典が示されます。
ただし、出典そのものが作られたものである可能性があるため、示された出典を実際に確認する必要があります。
同じことを二度聞く方法もあります。
新しい会話で同じ質問をして、答えが食い違えば怪しいと判断できます。
一致しても正しいとは限りませんが、食い違いは有力な手がかりです。
減らす頼み方
質問の仕方でも、ある程度は減らせます。
- 資料を渡して「この中から答えて」と指定する
- 「分からない場合は分からないと答えてください」と付ける
- 検索機能が使えるサービスでは、それを有効にする
一つ目が最も効きます。
AIが記憶から答えるのではなく、渡された資料から答える形になるためです。
つまずきポイント
「有料の高性能なモデルなら起きない?」
起きます。
性能の高いモデルほど頻度は下がる傾向がありますが、ゼロにはなりません。
むしろ、答えがもっともらしくなるぶん、間違いに気付きにくくなる面もあります。
理解度チェック
Q1. ハルシネーションが起きやすい場面を4つ挙げてください。
学習時点より後の出来事、細かい事実、存在しないものを前提とした質問、情報の少ないマイナーな話題です。
Q2. 「根拠を出させる」方法の注意点は何ですか?
出典そのものが作られたものである可能性があるため、示された出典を実際に確認する必要があります。
Q3. ハルシネーションを減らす最も効果的な頼み方は何ですか?
資料を渡して、その中から答えるよう指定することです。
記憶ではなく渡された資料から答える形になります。
ここまで読めば言えるようになること
- 起きやすい場面を予測できる
- 確認方法を3つ使い分けられる
- 減らす頼み方を実践できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(起きやすい場面、確認の方法と減らす頼み方)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:方式上の帰結であることを説明でき、なくせない理由を語れる
仕組みから来ている
LLMは、これまでの文脈から次のトークンを確率的に予測して出力します。
選ばれるのは「確率が高いトークン」であって、「正しいトークン」ではありません。
→ LLM(大規模言語モデル)とは
この方式には、「知らない」を検出して停止する機構が含まれていません。
学習データに存在しない事柄を聞かれても、形式として自然な文字列が生成されます。
つまり、ハルシネーションは不具合ではなく、この方式の帰結です。
バグとして修正できる種類のものではなく、減らす工夫を重ねる対象になります。
種類を分けると対処が変わる
ひとくちにハルシネーションと言っても、性質の異なるものが混ざっています。
知識の欠落によるものは、学習データにない事柄を埋め合わせるものです。
外部の情報を参照させることで対処できます。
知識の陳腐化によるものは、学習時点以降の変化を反映できないものです。
検索との組み合わせで対処します。
与えた資料と矛盾するものは、渡した文書に書かれていないことを答えるものです。
これは資料を渡していても起きるため、出力と資料の照合が必要になります。
推論の誤りによるものは、複数の事実は正しいのに、それらの組み合わせ方を誤るものです。
段階を踏んで考えさせる、あるいは計算を外部ツールに任せることで減らせます。
対処が異なるので、自社で起きているのがどれかを分けるところから始めます。
なぜ自信満々に見えるのか
AIの出力が自信ありげに見えるのは、事後学習の影響もあります。
人間の評価を反映させる過程で、はっきりした答えを返す応答が好まれる傾向があるためです。
その結果、「分かりません」と答えるより、それらしい答えを返すほうが選ばれやすくなります。
不確かさを表明する振る舞いは、意図的に設計しないと出てきません。
確率値は信頼度ではない
モデルは出力するトークンに確率を割り当てますが、これは「次にこのトークンが来るもっともらしさ」であって、「内容が事実であるもっともらしさ」ではありません。
高い確率で出力された文が事実として誤っていることは普通に起きます。
確率値を信頼度として業務判断に使うことはできません。
つまずきポイント
「RAGを入れれば解決する?」
減りますが、なくなりません。
検索が適切な文書を取れなければ、モデルは記憶から答えます。
また、取れた文書に書かれていないことを補って答えることもあります。
RAGは有力な手段ですが、出力と参照文書の照合という工程は別に要ります。
→ RAGとは|5段階でわかる用語解説
理解度チェック
Q1. ハルシネーションが方式上の帰結だというのはどういう意味ですか?
確率的にもっともらしい続きを選ぶ方式に、「知らない」を検出して停止する機構が含まれていないためです。
バグとして修正できる種類のものではありません。
Q2. ハルシネーションの4種類を挙げてください。
知識の欠落、知識の陳腐化、与えた資料との矛盾、推論の誤りです。
Q3. モデルが出力する確率値を信頼度として使えないのはなぜですか?
その確率は次のトークンのもっともらしさを表すもので、内容の事実性を表していないためです。
Q4. RAGを入れてもハルシネーションが残る理由は?
検索が適切な文書を取れなければ記憶から答え、取れた文書にないことを補って答えることもあるためです。
ここまで読めば言えるようになること
- 方式上の帰結であることを説明できる
- 4種類に分けて対処を変えられる
- 確率値が信頼度でないと説明できる
仕事で判断する立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(方式上の帰結であること、4つの種類)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:業務ごとに許容できる誤りの水準を決め、確認工程を設計できる
用途を3つに仕分ける
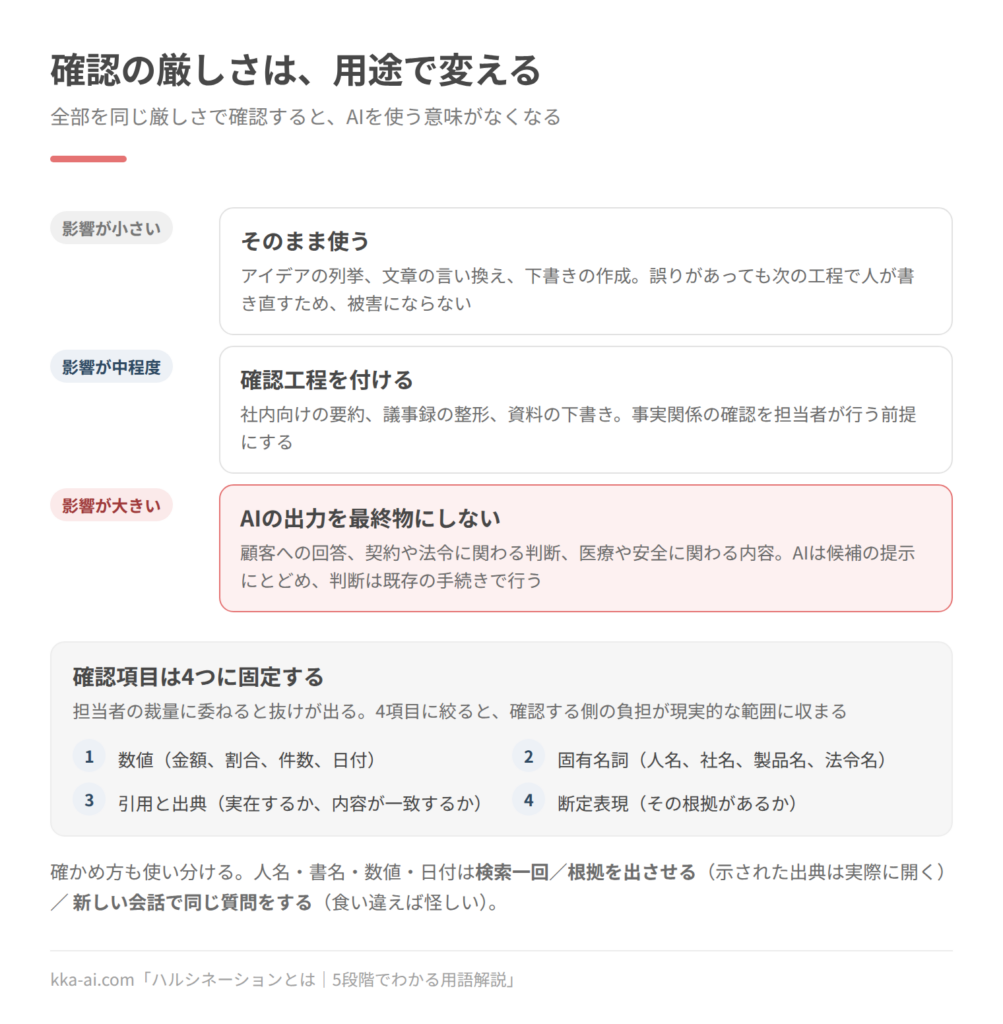
すべての業務で同じ厳しさの確認をすると、AIを使う意味がなくなります。
用途を、誤りが起きたときの影響で仕分けてください。
影響が小さい用途は、そのまま使えます。
アイデアの列挙、文章の言い換え、下書きの作成。
誤りがあっても、次の工程で人が書き直すため被害になりません。
影響が中程度の用途は、確認工程を付けます。
社内向けの要約、議事録の整形、資料の下書き。
事実関係の確認を担当者が行う前提にします。
影響が大きい用途は、AIの出力を最終物にしません。
顧客への回答、契約や法令に関わる判断、医療や安全に関わる内容。
AIは候補の提示にとどめ、判断は既存の手続きで行います。
事業者向けの指針でも、生成物の正確性の確認は利用者側の留意事項として挙げられています(AI事業者ガイドライン第1.2版)。
総務省・経済産業省「AI事業者ガイドライン(第1.2版)」(令和8年3月31日)
確認項目を固定する
確認を担当者の裁量に委ねると、抜けが出ます。
確認項目を固定してください。
- 数値(金額、割合、件数、日付)
- 固有名詞(人名、社名、製品名、法令名)
- 引用と出典(実在するか、内容が一致するか)
- 断定表現(「〜である」と書かれている箇所の根拠)
この4項目を確認するチェックリストを作り、承認フローに組み込みます。
4項目に絞ることで、確認する側の負担が現実的な範囲に収まります。
設計で減らす
運用でなく設計で減らせる部分もあります。
参照範囲を限定する。
社内文書を検索して答えさせる場合、対象範囲を絞ると精度が上がります。
何でも答えるより、扱える範囲を明示して外は答えない設計のほうが安全です。
出力に根拠を併記させる。
どの文書のどの部分に基づく回答かを併記させると、確認の工数が大幅に下がります。
根拠が示せない場合は答えない、という設計も可能です。
分からない場合の応答を定義する。
「該当する情報が見つかりませんでした」と返す経路を用意し、そう返すべき条件を指定します。
これがないと、無理に答える方向に倒れます。
計算と検索は外部に任せる。
数値の計算や最新情報の取得は、モデルに任せず外部のツールを呼ばせます。
事故が起きたときの備え
確認体制を作っても、通り抜けるものは出ます。
次を先に決めておいてください。
- 誤りが外部に出た場合の訂正の手順と責任者
- AIを使って作成した文書の記録の残し方(入力、出力、モデル、日時)
- 利用者への表示(AIを利用している旨を示すか)
記録が残っていないと、原因の切り分けができません。
実際に筆者が試したことの記録は以下の通りです。
試したこと(2026年9月9日)
- 使ったもの:Claude Pro
- やったこと:記事の下書きに出てきた統計の数字を、公表元の資料に当たって確認した
- 結果:調査の名前は実在したが、引用された数値は別の区分のものだった。全体の数字を、一部の区分の数字として書いていた
- つまずいた点:文章としては何も違和感がなかった。断定の口調で書かれていたので、読んで気付くことはできない。数字を全部拾って1つずつ当たる以外に見つける方法がなかった
教育で伝えるべきこと
社内教育では、次の3点に絞ると伝わります。
1つ目は、AIは正しさではなくもっともらしさを出しているという仕組みの理解。
2つ目は、確認すべき4項目。
3つ目は、判断そのものを任せてはいけない用途の一覧です。
「気をつけて使う」という指示は機能しません。
何を確認するかを具体的に示す必要があります。
つまずきポイント
「確認の工数で、効率化の効果が消えた」
確認項目を絞りきれていない可能性があります。
全文を読み直す運用は、書くのと同じ時間がかかります。
数値と固有名詞と出典に絞り、文章表現の確認は行わない、と決めるだけで工数は大きく下がります。
文章表現の誤りは、事実の誤りより影響が小さいためです。
理解度チェック
Q1. 用途を仕分ける基準は何ですか?
誤りが起きたときの影響の大きさです。
影響が大きい用途では、AIの出力を最終物にしません。
Q2. 確認項目として固定すべき4つは?
数値、固有名詞、引用と出典、断定表現の根拠です。
Q3. 「分からない場合の応答」を定義する理由は?
定義がないと、無理に答える方向に倒れるためです。
Q4. 確認の工数が膨らんだときに見直すべき点は?
確認項目を絞れているかです。
全文を読み直すのではなく、数値、固有名詞、出典に絞ります。
ここまで読めば言えるようになること
- 用途を影響の大きさで3つに仕分けられる
- 確認項目を固定してフローに組み込める
- 設計で減らす手段を4つ挙げられる
- 事故時の備えを準備できる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:検出手法の原理と限界を理解し、用途に応じて組み合わせられる
分類
ハルシネーションの分類と検出の研究は、2022年の総説にまとまっています。
Ziwei Ji ほか「Survey of Hallucination in Natural Language Generation」(arXiv:2202.03629・2022年・英語)
研究は、大きく2つに分けられます。
事実性のハルシネーションは、外界の事実と矛盾するものです。
検証には外部の知識源が要ります。
忠実性のハルシネーションは、与えられた入力(要約元の文書、参照文書)と矛盾するものです。
入力が手元にあるため、照合による検出が可能です。
RAGを組んだシステムで実務上問題になるのは、多くの場合こちらです。
参照文書が手元にあるぶん、検出の見込みも高くなります。
検出の手法
一貫性による検出は、同じ質問に対して複数回生成し、内容の一致度を測る方法です。
モデルが確信を持っていない事柄では、生成ごとに内容が揺れます。
外部の知識源を必要としない点が利点で、複数回の生成による費用が代償です。
照合による検出は、出力の各主張が参照文書のどこに根拠を持つかを判定する方法です。
主張の単位に分解し、それぞれについて含意関係を判定します。
判定自体をモデルに行わせる構成が一般的です。
確率に基づく指標は、生成時の確率分布から不確かさを推定する方法です。
ただし、意味的に同じ内容が異なる表現で生成される場合、表面的な確率は分散します。
意味の等価性を考慮して集約する手法が提案されています。
外部知識との照合は、検索や知識ベースへの問い合わせによって主張を検証する方法です。
確実性は高い一方、検証対象を主張単位に分解する処理と、検索の質に依存します。
抑制の手法
参照付き生成は、回答の各文に根拠を示させる方式です。
根拠を示せない主張を出力しない制約を課すことで、事実性を上げられます。
棄却の学習は、答えられない質問に対して答えないよう事後学習で学ばせる方法です。
過度に働くと、答えられる質問にも答えなくなるため、釣り合いの調整が要ります。
デコーディングの工夫では、参照文脈を与えた場合と与えない場合の出力分布の差を利用して、文脈に忠実な出力を強める手法があります。
外部ツールの利用は、計算、検索、データベースへの問い合わせをモデルの外に出す方式です。
モデルに数値計算をさせるより確実で、実務では最も効果が安定します。
評価の設計
自社システムのハルシネーション率を測るには、評価セットが要ります。
含めるべきは次の4種類です。
- 参照文書に答えがある質問(正しく答えられるか)
- 参照文書に答えがない質問(答えないと言えるか)
- 参照文書と矛盾する前提を含む質問(前提の誤りを指摘できるか)
- 存在しない対象を前提とした質問(作り出さずに済むか)
2番目と4番目が特に重要です。
答えられる質問への正答率だけを測ると、無理に答える傾向が評価に反映されません。
限界
現在の手法で、ハルシネーションを完全に除去することはできません。
検出手法にも誤りがあり、検出側のモデルが同じ種類の誤りを共有している場合、見逃しが生じます。
したがって、システムの設計としては、残ることを前提にした構成が要ります。
根拠の提示、人の確認を組み込む経路、誤りが判明した際の訂正の手順。
これらを、技術的な抑制と併せて設計することになります。
理解度チェック
Q1. 事実性と忠実性のハルシネーションの違いは何ですか?
事実性は外界の事実と矛盾するもの、忠実性は与えられた入力と矛盾するものです。
後者は入力が手元にあるため照合による検出が可能です。
Q2. 一貫性による検出の利点と代償は?
外部の知識源を必要としない点が利点で、複数回生成する費用が代償です。
Q3. 評価セットに含めるべき、見落とされやすい質問の種類は?
参照文書に答えがない質問と、存在しない対象を前提とした質問です。
無理に答える傾向を測るために必要です。
Q4. 検出手法にも見逃しが生じるのはなぜですか?
検出側のモデルが同じ種類の誤りを共有している場合があるためです。
ここまで読めば言えるようになること
- 事実性と忠実性を分けて対処できる
- 検出手法を4つ挙げ、原理と代償を説明できる
- 抑制の手段を用途に応じて選べる
- 評価セットを4種類の質問で設計できる
まとめ
ハルシネーションは、AIが事実でないことをもっともらしく出力する現象です。
Level 1では、知らないことも答えてしまう性質。
Level 2では、起きやすい場面が予測できる現象。
Level 3では、確率的に続きを選ぶ方式の帰結。
Level 4では、用途の仕分けと確認項目の固定で管理する対象。
Level 5では、検出と抑制を組み合わせつつ、残ることを前提に設計する制約。
なくせないものだと理解したうえで、確認の工程を業務に組み込めるかどうか。
AIを実務で使えるかどうかは、ほぼここで決まります。
次に読む記事
→ LLM(大規模言語モデル)とは
→ RAGとは|5段階でわかる用語解説
→ プロンプトとは?生成AIで必須の用語の意味と、初心者が最初に覚える「1つの型」を解説
→ 今さら聞けないAI用語30選
よくある質問(FAQ)
Q. ハルシネーションとは何ですか?
A. AIが事実に基づかない情報を、あたかも正しいかのように生成してしまう現象です。もともとは幻覚を意味する言葉です。
Q. なぜAIはハルシネーションを起こすのですか?
A. 正しさではなく、統計的にもっともらしい続きを選ぶ方式であり、「知らない」を検出して停止する仕組みを持たないためです。
Q. 高性能なモデルなら起きませんか?
A. 頻度は下がる傾向がありますが、ゼロにはなりません。むしろ出力がもっともらしくなるぶん、誤りに気付きにくくなる面もあります。
Q. RAGを導入すれば解決しますか?
A. 減りますが、なくなりません。検索が適切な文書を取れなければ記憶から答え、取れた文書にないことを補うこともあります。出力と参照文書の照合が別に必要です。
Q. 業務で使うとき、何を確認すればよいですか?
A. 数値、固有名詞、引用と出典、断定表現の根拠の4項目です。全文を読み直すのではなく、この4項目に絞ると確認の工数が現実的な範囲に収まります。
用語の全体像はこちらで確認できます。
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報