AIの料金表や仕様には、必ず「トークン」という単位が出てきます。 「100万トークンあたり〇ドル」「コンテキストは20万トークンまで」といった具合です。
暗号資産のトークンとも、ゲームセンターのコインとも関係ありません。 そして、この単位の意味を知らないままだと、AIの料金も、入力できる文章量の上限も、正しく見積もれません。
この記事では、トークンを「AIが文章を処理するときの最小単位」として押さえ、なぜ文字数ではないのか、日本語利用で何に効いてくるのかまでを解説します。
トークンとは何か?
まず、トークンという単位の実体からです。 「AIは文章をどう読んでいるのか」という素朴な疑問への答えが、そのままトークンの説明になります。
AIは文章をかけらに刻んでから読む
チャットAIの中身である言語モデルは、文章をそのままの形では扱えません。 処理の前に、文章を小さな断片に刻み、それぞれを番号に変換します。
この断片の一つひとつがトークンです。
刻み方は、文字単位でも単語単位でもなく、その中間にあたります。 よく使われる単語は1個のトークンに、珍しい単語は複数のトークンに分割される、という可変の仕組みです。
たとえば英語では、appleのような頻出単語は1トークン、専門用語や造語は「かけら」数個に割られます。 この分割を行う仕組みをトークナイザーと呼び、モデルごとに刻み方の癖が異なります。
なぜこんな回りくどい方式なのかというと、効率と柔軟性の折衷だからです。 単語単位では未知の単語に対応できず、文字単位では処理が長くなりすぎます。 「よく出る並びはまとめて1個、珍しい並びは分割」という方式が、その間を取った現実解になっています。
刻まれたトークンは番号として処理
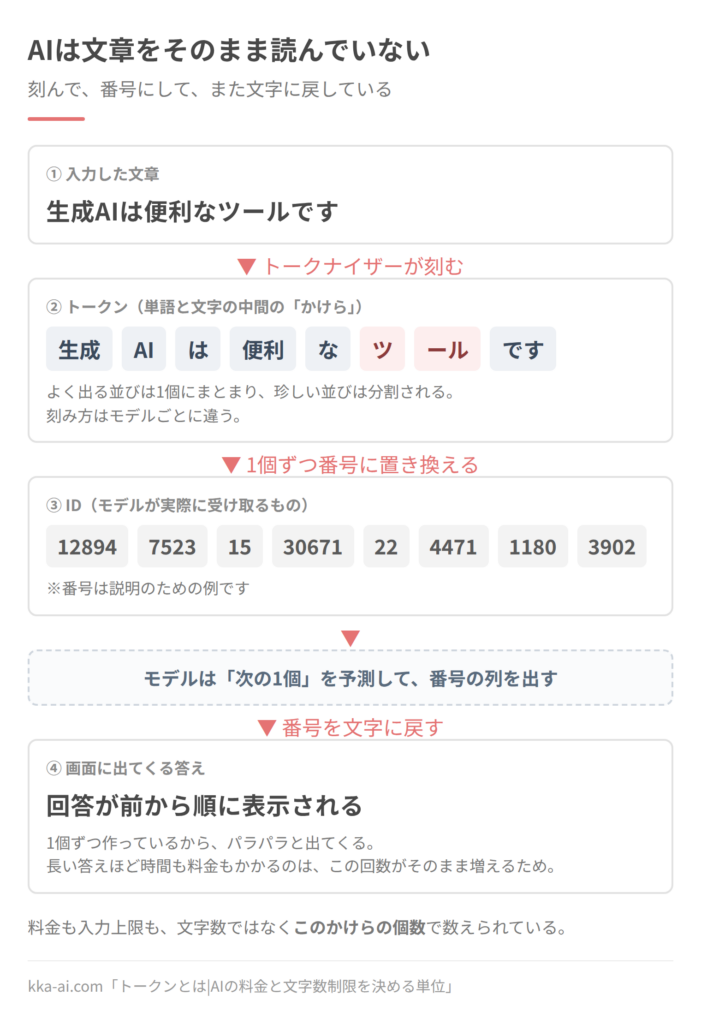
刻まれた各トークンは、モデルの中では番号(ID)として扱われます。 AIは文章を文章のまま読んでいるのではなく、番号の列として受け取り、番号の列として出力し、最後に人間向けの文字に戻しています。 「AIが言葉を理解している」ように見える処理の入口と出口には、この機械的な変換が必ず挟まっています。
トークン数と文字数の換算の目安
厳密な換算はモデルごとに違いますが、実用上の目安は次の通りです。
- 英語:1トークンはおおよそ4文字、単語数の3割増し程度
- 日本語:1トークンはおおよそ1〜2文字程度
英語では1トークンがおおよそ4文字、単語の3/4程度という目安が公式ヘルプに示されています。
【参考】:OpenAI「What are tokens and how to count them?」
つまり、日本語1,000文字の文章は、ざっくり数百から1,000トークン強に相当します。 正確な数は、各社が公開しているトークン数の計測ツールで確認できますので実際に試しました。
測定に使ったのは公式のトークナイザ tiktoken です。
【参考】:OpenAI「tiktoken」(トークナイザのライブラリ。o200k_base / cl100k_base)
試したこと(2026年9月7日)
- 使ったもの:tiktoken(OpenAI系のトークナイザ)を使った自作スクリプト。
ClaudeやGeminiは別の分割をするため、以下は他社での目安になります - やったこと:このサイトの記事1本(日本語4,875字)と、英語の技術文書(4,858字)を測った
結果:日本語は3,772トークンで、1文字あたり0.77トークン。英語は1,125トークンで、1文字あたり0.23トークンだった
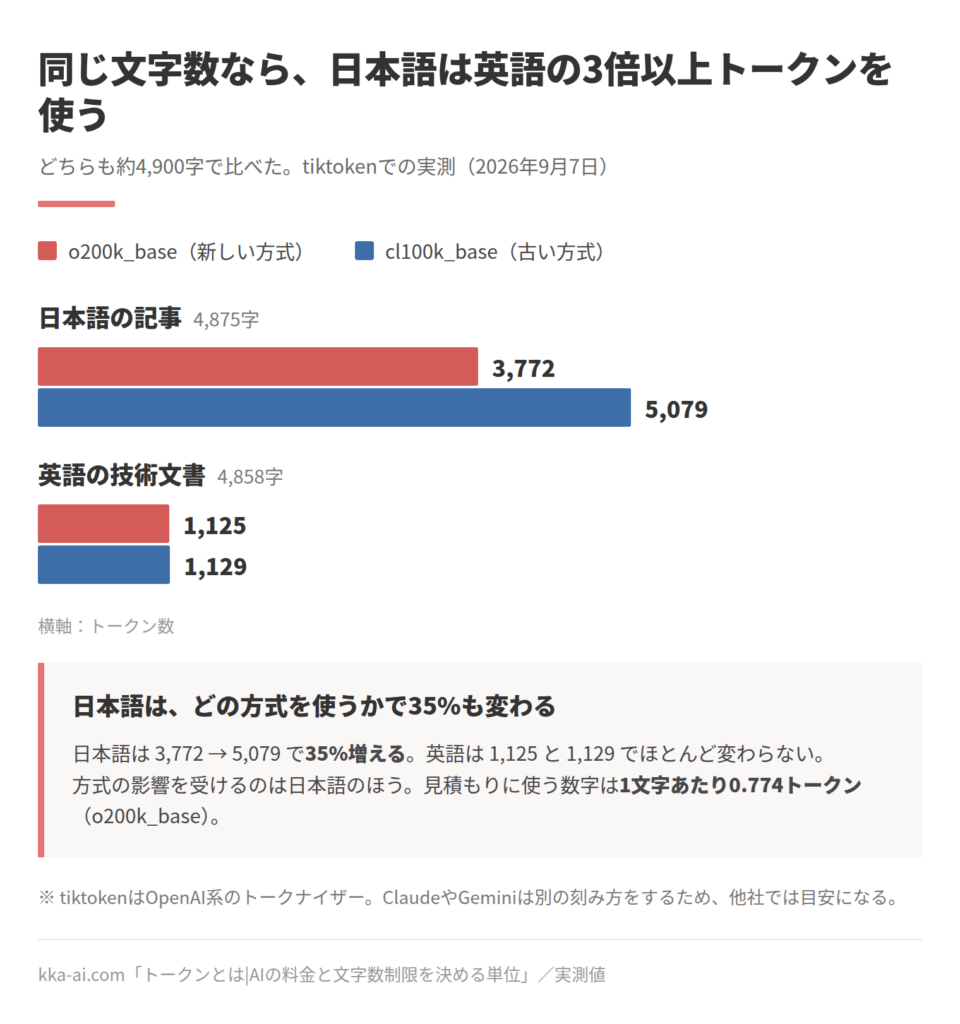
※日本語文章(AIエージェント記事:https://www.kka-ai.com/ai-agent-basics/)
| 測った文章 | 文字数 | o200k_base | cl100k_base | 1文字あたり |
|---|---|---|---|---|
| Japanese.md | 4,875 | 3,772 | 5,079 | 0.77 |
見積もりに使う数字:
1文字あたり平均 0.774 トークン(o200k_base)
例: 2,000文字の入力 → 約 1,547 トークン
※英語(技術文書から抜粋)
| 測った文章 | 文字数 | o200k_base | cl100k_base | 1文字あたり |
|---|---|---|---|---|
| English.md | 4,858 | 1,125 | 1,129 | 0.23 |
見積もりに使う数字:
1文字あたり平均 0.232 トークン(o200k_base)
例: 2,000文字の入力 → 約 463 トークン
- つまずいた点:同じ日本語でも、漢字が多い文章のほうがトークンあたりの文字数が増えた。
ひらがなが続く箇所は1文字1トークンに近くなる。1つの比率で全部を見積もると外れる。そして、この数字は自分が使っているサービスのものではない。
正確な消費量を知りたい場合は、各サービスの使用状況の画面を見るしかなかった
トークンで理解するAIの挙動
トークンを知ると、チャットAIの見慣れた挙動に次々と説明がつきます。 仕組みと日常の体験がつながる場面を3つ見てみましょう。
回答がパラパラと表示される理由
生成AIの文章生成は、「これまでの文脈から、次の1トークンを予測する」という計算の繰り返しです。 1トークン出しては、それを含めた文脈で次の1トークンを予測する。 この逐次処理を高速に回すことで、文章が組み立てられています。
チャットAIの回答が、先頭からパラパラと表示されていくのはこのためです。 演出ではなく、実際に先頭から順に生成されているものを、生成と同時に表示しています。
回答が長いほど遅く、高くなる理由
「回答が長いほど待ち時間もお金もかかる」のも、この仕組みの帰結です。 出力トークンが1個増えるごとに、1回分の予測計算が追加されるからです。 出力の単価が入力より高く設定されているのも、出力側にこの逐次計算の負荷があることが一因です。
もっともらしい誤りが出る理由
「次のトークンを予測しているだけ」という仕組みは、生成AIがもっともらしい誤り(ハルシネーション)を出す理由の説明にもなっています。 AIは事実を参照して答えているのではなく、続きとして自然なトークン列を組み立てているのです。
トークンの実用での場面
仕組みが分かったところで、利用者のコストと作業に関する解説に移ります。トークンは、料金と入力上限があり、日本語利用者には効率差の問題もあります。詳しく見ていきましょう。
料金は入力と出力のトークン数で決まる
AIのAPI料金は、文字数でも回数でもなく、トークン数で決まります。
しかも、入力(AIに読ませた量)と出力(AIが書いた量)の両方に課金され、一般に出力のほうが単価が高く設定されています。 長い資料を読ませて長い回答を書かせれば、その分だけ料金が積み上がる仕組みです。
この構造を知ると、AI活用のコスト感覚が具体的になります。
- 長い資料を丸ごと貼るより、必要な部分に絞って渡すほうが安い
- 「簡潔に答えて」という指示は、品質だけでなく料金にも効く
- 高性能モデルほどトークン単価が高いため、作業の重さでモデルを使い分ける価値がある
なお、チャット版の定額プランでも、内部ではトークンが計算資源の単位になっており、利用上限(回数や量の制限)の正体はトークン量の管理です。
入力の上限はコンテキストウィンドウ
もう一つの場面が、AIが一度に扱える文章量の上限です。
AIが1回の会話で参照できる範囲をコンテキストウィンドウと呼び、その大きさはトークン数で表されます。 「20万トークンまで」というモデルなら、日本語で数十万文字規模の文書までを一度に読ませられる計算です。
上限を超えた分は、AIには見えていません。 長い会話の序盤の内容をAIが「忘れた」ように見える現象は、多くの場合、古いやり取りがこの窓からあふれたことが原因です。
日本語はトークン数で割高になりやすい
トークナイザーの多くは英語中心のデータで設計されてきたため、英語は効率よく刻める一方、日本語は同じ内容でも多くのトークンに分割されがちです。 トークン数が多いことは、料金と入力上限の両方に効いてきます。 同じ予算、同じ上限でも、日本語は英語より「損」をしやすい構造がある、ということです。
分割のされ方にも、日本語ならではの癖があります。 ひらがなの助詞や頻出語はまとまって1トークンになりやすい一方、漢字は1文字ずつ、ときには1文字が複数トークンに割られることもあります。 つまり同じ文字数でも、漢字の多い硬い文章のほうが、トークン数は膨らみやすい傾向があります。 「文字数からの換算はあくまで概算」と言われるのは、この癖のためです。
ただし、近年のモデルでは日本語の分割効率も改善が進んでおり、この差は縮小傾向にあります。 「日本語は常に英語の何倍」と固定的に覚えるのではなく、「言語によって効率差がある」という構造だけ押さえておけば十分です。
トークンを無駄にしない3つのコツ
無駄にしないためのコツを3つ紹介します。
渡す情報を絞る
第一に、渡す情報を絞ることです。 資料全体を貼るより、関係する章だけを渡すほうが、料金も精度も改善します。 AIは長すぎる入力の中から要点を拾い損ねることがあるため、絞り込みは品質対策にもなります。
出力の形式を指定する
第二に、出力の形式を指定することです。 「箇条書きで5点」「結論を先に200字で」のような指定は、無駄な出力トークンを減らし、読む側の時間も節約します。 指示の書き方の基本は、別記事にまとめています。 → プロンプトとは?生成AIで必須の用語の意味と、初心者が最初に覚える「1つの型」を解説
長い会話を仕切り直す
第三に、長い会話を仕切り直すことです。 チャットの履歴は毎回まるごと入力として処理し直されるため、会話が長引くほど1往復あたりのトークン消費が膨らみます。 話題が変わったら新しい会話を始めるのが、コストと品質の両面で有利です。
私も長い原稿の推敲をAIに手伝わせるとき、章単位で区切って渡す運用にしています。 一度に全部を放り込むより、結果が安定するからです。
よくある質問(FAQ)
Q. トークンと文字数はどちらで数えればいいですか?
A.人間向けの原稿は文字数、AIとのやり取りの見積もりはトークン数、と使い分けてください。 AIの料金と上限はすべてトークン基準なので、文字数からの概算(日本語なら1文字1〜2トークン程度)を頭に入れておくと見積もりが速くなります。
Q. 絵文字や記号もトークンになりますか?
A.なります。 絵文字や特殊な記号は複数トークンに分割されることも多く、見た目の文字数以上にトークンを消費する場合があります。
Q. コンテキストウィンドウとトークンの関係を一言で言うと?
A.コンテキストウィンドウは「机の広さ」、トークンは「机に載せる書類の枚数の数え方」です。 机(ウィンドウ)の広さはトークン数で決まっており、入力も、会話の履歴も、AIの回答も、すべて同じ机の上に載ります。 机からあふれた古い書類(過去のやり取り)は、AIから見えなくなります。
Q. 暗号資産の「トークン」とは関係ありますか?
A.まったく別の用語です。 AI分野のトークンは文章処理の単位、暗号資産分野のトークンはデジタル資産の単位で、共通点は名前だけです。 記事のジャンルで読み分けてください。
まとめ
トークンとは、AIが文章を処理する最小単位で、単語と文字の中間にあたる「かけら」です。 AIの料金は入力と出力のトークン数で決まり、一度に扱える文章量の上限もトークン数で定義されています。
「トークン」の数字を見たら、日本語では1文字1〜2トークン程度という目安で、自分の使い方に引き付けて換算してみてください。 料金表と仕様が、具体的なコスト感覚として読めるようになります。
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
参考
以下の資料を参考にしました。
- OpenAI「What are tokens and how to count them?」
- OpenAI「tiktoken」(トークナイザのライブラリ。o200k_base / cl100k_base)