ChatGPTを毎日使っている人でも、その中で動いているLLM(大規模言語モデル)が何をしているかを説明できる人は多くありません。
LLMを知らなくてもChatGPTは使えますが、知っていると、うまくいかないときに原因の見当を付けやすくなります。
本記事では、LLMの説明を5つのレベルに分けて並べました。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(8分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(10分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(12分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で読み終えられます。
30秒で腕試し
理解度から決めたい場合は、次の3問を試してください。
答えられなくなったところが、あなたのスタート地点です。
Q1. LLMとChatGPTの違いを一言で説明できますか
→ 詰まったら Level 1から
Q2. AIが事実でないことを答えてしまう理由を、仕組みから説明できますか
→ 詰まったら Level 3から
Q3. 会話を10往復したとき、費用がどう変わるか説明できますか
→ 詰まったら Level 4から
→ 3問とも答えられるなら Level 5から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
機械学習という言葉で止まる場合は、先にこちらを読むと入りやすくなります。
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:LLMを「続きの言葉を当てるのがとても上手な機械」だと自分の言葉で言える
やっているのは、続きを当てるゲーム
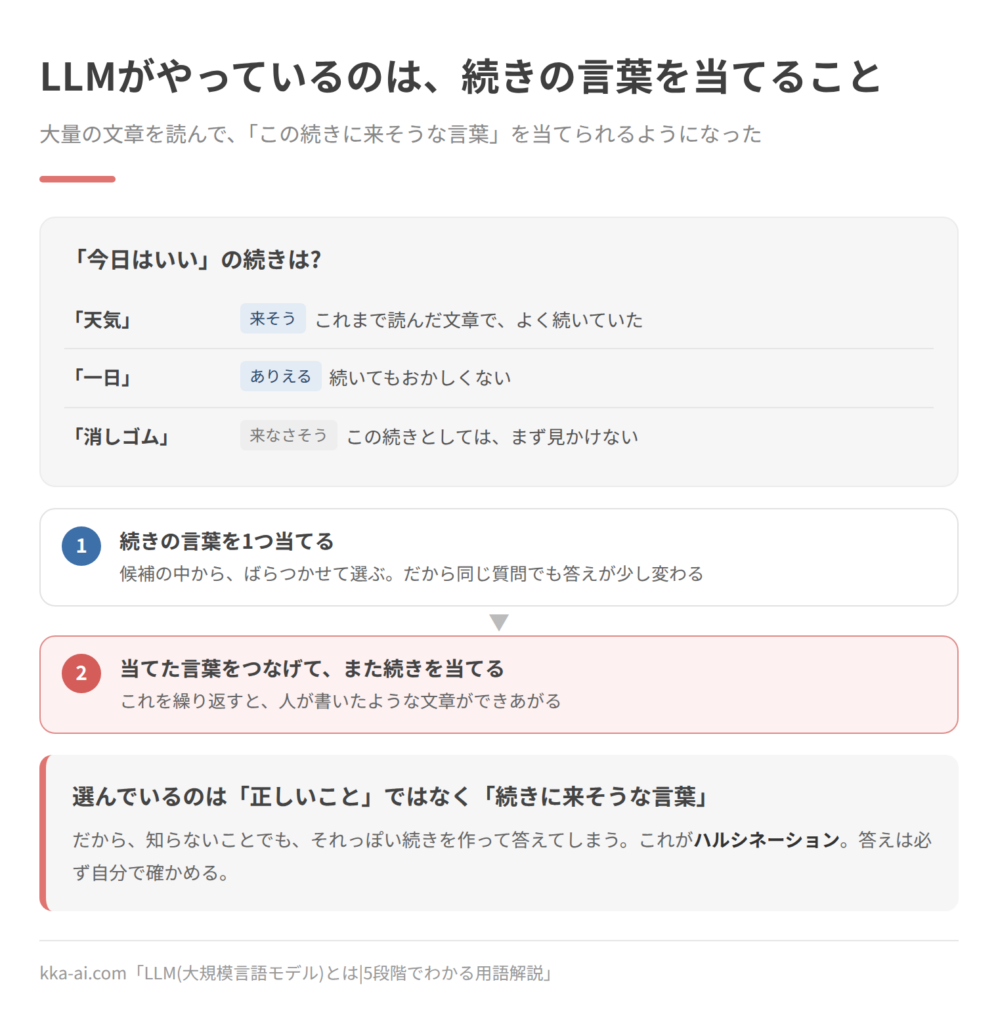
「今日はいい」と言われたら、次に何が来ると思いますか。
たぶん「天気」が浮かんだはずです。
「一日」でもよさそうですが、「消しゴム」はおかしい気がします。
なぜそう思えるかというと、これまでにたくさんの日本語を聞いてきたからです。
文法を習ったからではなく、聞いた量で身についています。
LLMがやっているのは、まさにこれです。
本、ニュース、ウェブサイトなど、途方もない膨大な量の文章を読んで、「この続きに来そうな言葉」を当てられるようになりました。
そして、当てた言葉の続きをまた当てる。
これを繰り返すと、まるで人が書いたような文章ができあがります。
LLMとは、「Large Language Model(大規模言語モデル)」の略です。
大きい、言葉の、模型。
名前のとおり、言葉のふるまいをマネる大きなしくみです。
ChatGPTとの関係は、エンジンと車
ChatGPTという名前のほうをよく聞くと思います。
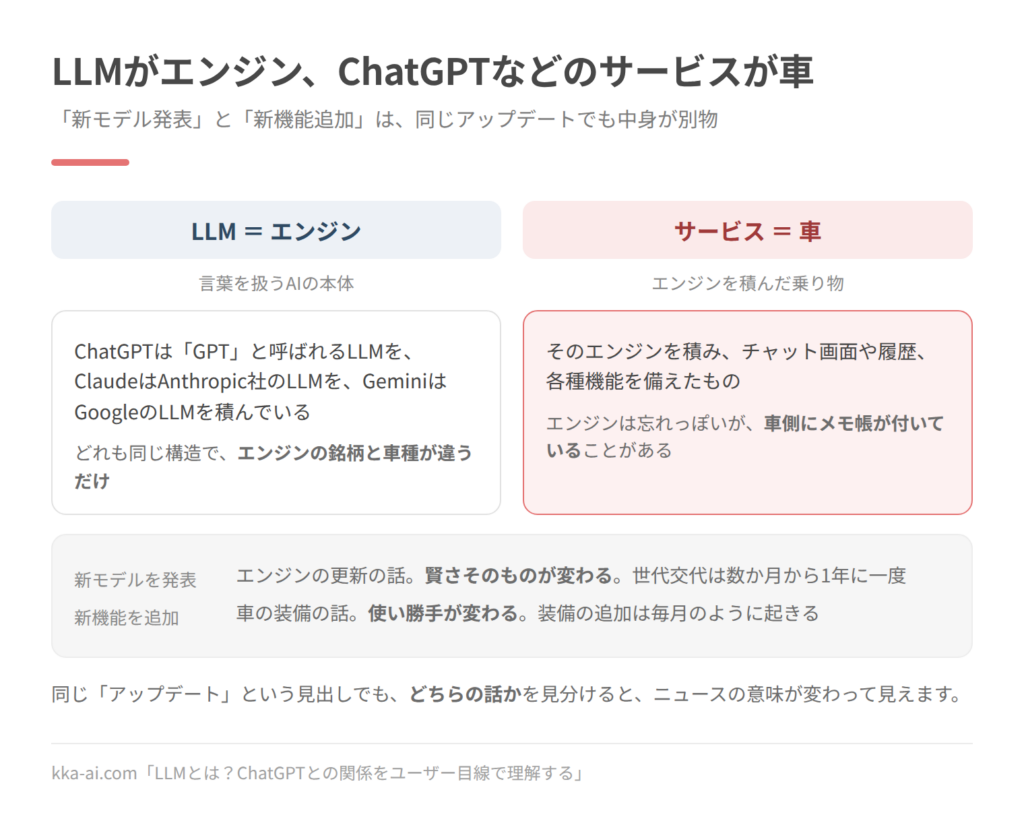
LLMとChatGPTの関係は、エンジンと車に例えられます。
- LLMがエンジン
- ChatGPTが、そのエンジンを積んだ車
エンジンだけでは走れません。
ボタンや画面、会話の履歴といったものを付けて、誰でも使えるようにしたのがChatGPTです。
同じ作りのサービスはほかにもあり、中に入っているエンジンがそれぞれ違います。
知らないことも、平気で答えてしまう
ここが、いちばん気をつけるところです。
LLMは「正しいこと」を選んでいるのではなく、「続きに来そうな言葉」を選んでいます。
だから、知らないことを聞かれても、それっぽい続きを作って答えてしまいます。
しかも、自信がなさそうな顔をしません。
この、もっともらしいうそのことをハルシネーションといいます。
LLMの答えは、必ず自分で確かめる。
これは大人も守っているルールです。
同じことを聞いても、答えが少し変わる
もう一つ、不思議に思うところがあります。
同じ質問をしても、答えが毎回少しずつ違うのです。
これは壊れているのではなく、わざとそうしてあります。
続きの候補をいくつか持っていて、その中から少しばらつかせて選ぶようにしてあるからです。
おかげで、気に入らない答えが返ってきたら、もう一度同じことを聞くだけで別の答えが出てきます。
つまずきポイント
「LLMはインターネットで調べているの?」
LLMそのものは、調べていません。
覚えている中から、続きを組み立てているだけです。
最近のサービスには検索する機能が付いていることもありますが、それは車の側にあとから付けた装備で、エンジン(LLM)の働きではありません。
理解度チェック
Q1. LLMがやっていることを一言で説明してください。
たくさんの文章を読んで、続きに来そうな言葉を当てています。
それを繰り返して文章を作ります。
Q2. LLMとChatGPTの関係を、たとえで説明してください。
LLMがエンジンで、ChatGPTがそのエンジンを積んだ車です。
Q3. LLMがうそをつくことがあるのはなぜですか?
正しいことではなく、続きに来そうな言葉を選んでいるからです。
知らないことでも、それっぽい続きを作ってしまいます。
ここまで読めば言えるようになること
- LLMは続きの言葉を当てるしくみだと説明できる
- LLMとChatGPTの違いを説明できる
- ハルシネーションという言葉を使って、確認が必要な理由を言える
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(続きを当てるしくみ、エンジンと車の関係)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:LLMの性質から、使い方のコツを自分で導ける
使う人は、2年で約6倍に
まず、どれくらい生成AIが使われているか見ていきましょう。
総務省の「令和8年版 情報通信白書」によると、日本で生成AIのサービスを「使っている(過去使ったことがある)」と答えた人は、2023年度の調査で9.1%、2024年度の調査で26.7%、2025年度の調査では58.8%でした。2024年度までの調査では調査対象の年齢を20歳以上としていましたが、2025年度の調査からは15〜19歳も対象に加わっています。20歳以上に限ると52.2%です。
さらに利用実態を年齢階層ごとに見ると、20代に限ると78.2%、15〜19歳は91.7%と高い水準です。若年層を中心に利用率が高い傾向が見られます。
一方で、同じ調査の米国は75.6%、中国は93.6%でした。
日本では、まだ他の国よりも低い水準という位置にあります。ただ、2025年度の調査で差は大きく縮まりました。
使う人が増えるほど、「中で何が起きているか」を知っているかどうかで、使いこなしに差が出ます。
「新モデル」と「新機能」は別の話
エンジンと車の区別ができると、ニュースの読み方が変わります。
「新モデルを発表」と出てきたら、エンジンが新しくなった話です。
賢さそのものが変わります。
「新機能を追加」の場合は、車の装備が増えた話です。
使い勝手は変わりますが、賢さは変わりません。
同じアップデートという言葉でも、中身は別物です。
使っているサービスの発表を読むとき、この2つを分けると、自分に関係があるかどうかが判断できるようになるでしょう。
トークンという単位
LLMは、文章を文字数ではなくトークンという単位で扱います。
トークンは、単語や単語のかけらにあたる細かい単位です。
なぜこれを知っておくとよいかというと、LLMをめぐる制限のほとんどがトークン数で決まっているからです。
- 一度に読ませられる長さの上限
- 料金の計算
- 「長い文書を入れたら途中で切れた」という現象
どれもトークンの話です。
文字数で考えていると、なぜ切れたのかが分からなくなります。
→ トークンとは|AIの料金と文字数制限を決める単位
一度に覚えていられる範囲がある
LLMが1回の会話で見ていられる範囲をコンテキスト、その上限をコンテキストウィンドウといいます。
長い会話を続けていると、最初のほうに伝えた前提を忘れたような答えが返ってくることがあります。
これは記憶力の問題ではなく、上限を超えて古い部分が外れているためです。
対処は単純で、話題が変わったら新しい会話を始める。
長い前提が必要なら、会話の途中でもう一度まとめて渡す。
この2つの対処で、答えの精度ははっきり変わります。
→ コンテキスト(文脈)とは|5段階でわかる用語解説
答えの質は、指示文で決まる
LLMは、与えられた文章の続きを作ります。
ということは、与える文章を変えれば、出てくるものも変わります。
この指示文をプロンプトと呼びます。
プロンプトで結果を左右するのは、主に次の4点です。
- 誰に向けた文章かを書く(小学生向け、社内の役員向け、など)
- どんな形式で欲しいかを書く(箇条書き、表、800字、など)
- 前提となる情報を渡す(自社の状況、対象読者、制約)
- してほしくないことを書く(専門用語を使わない、断定しない、など)
「もっと分かりやすく」とだけ書くより、「中学生が読む前提で、専門用語を使わずに」と書いたほうが結果が安定します。
これはLLMが察してくれないからではなく、続きを絞り込む材料が増えるからです。
→ プロンプトとは?生成AIで必須の用語の意味と、初心者が最初に覚える「1つの型」を解説
知識には期限がある
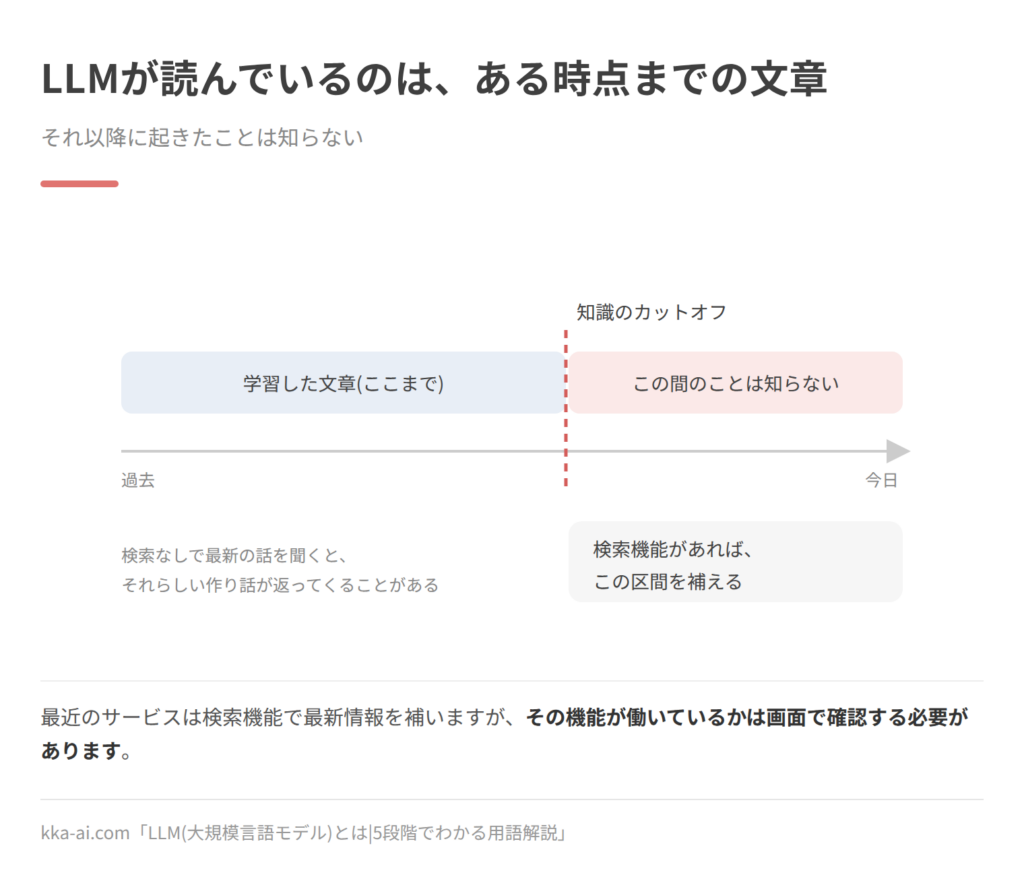
LLMは、学習した時点までの文章しか読んでいません。
そのため、それ以降に起きたことは知りません。
これを知識のカットオフといいます。
最近のサービスは、検索機能を組み合わせて最新情報を補うようになっていますが、その機能が働いているかどうかは画面上で確認する必要があります。
検索なしで最新の話を聞くと、それらしい作り話が返ってくる可能性が高くなります。
つまずきポイント
「同じ質問なのに答えが違うのは不具合では?」
仕様です。
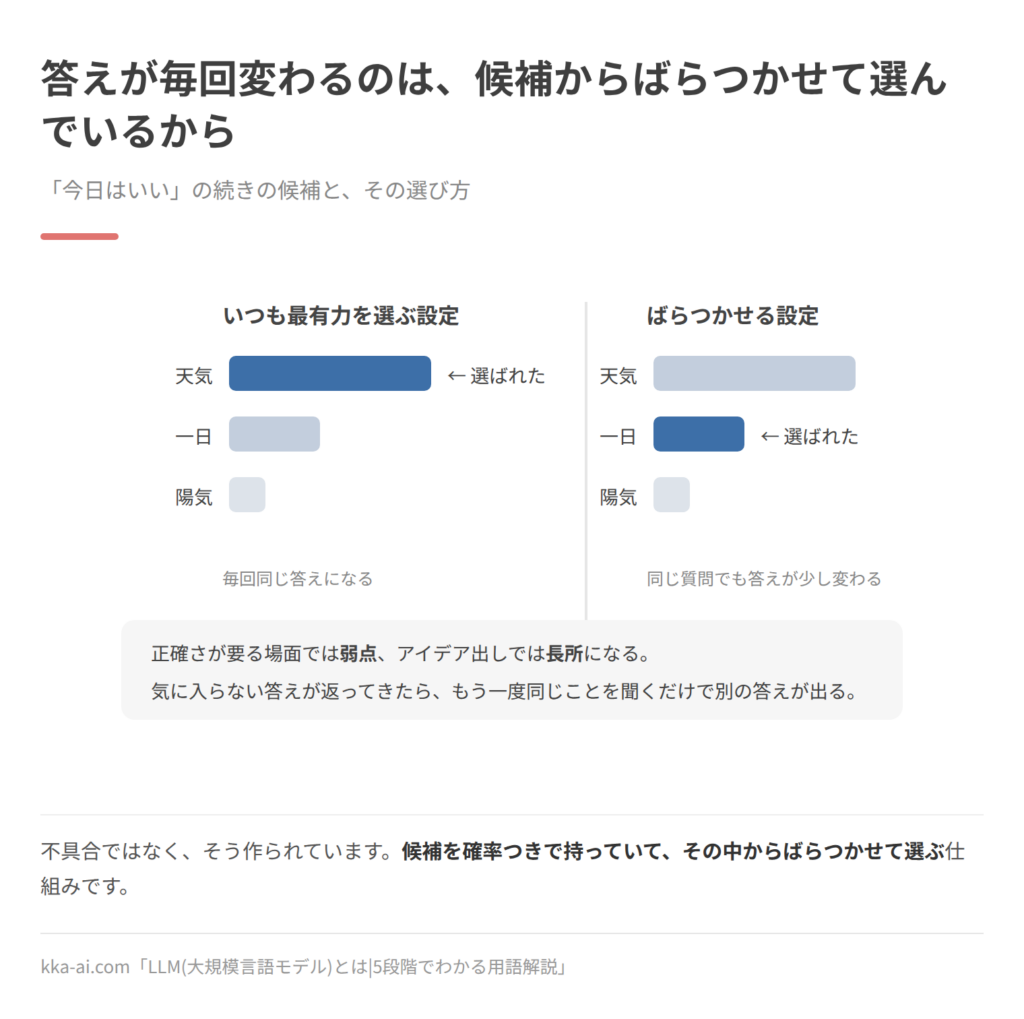
LLMは続きの候補を確率つきで持っていて、常に最有力の1語を選ぶのではなく、確率に応じてばらつかせて選びます。
このばらつきがあるから、文章に多様さが出ます。
正確さが要る場面では弱点、アイデア出しでは長所になる、という理解で使い分けてください。
理解度チェック
Q1. 日本で生成AIを使ったことがある人の割合は、どう変わりましたか?
2023年度の調査で9.1%、2024年度の調査で26.7%、2025年度の調査で58.8%でした。(総務省「令和8年版 情報通信白書」)。
Q2. 「新モデル発表」と「新機能追加」は、それぞれ何が変わりますか?
新モデルはエンジンの更新で、賢さが変わります。
新機能は車の装備の話で、使い勝手が変わります。
Q3. 長い会話で最初の前提を忘れたような答えが返るのはなぜですか?
コンテキストウィンドウの上限を超えて、古い部分が外れているためです。
Q4. プロンプトを具体的に書くと結果が安定するのはなぜですか?
続きを絞り込む材料が増えるためです。
LLMは与えられた文章の続きを作るので、前提が多いほど出力が定まります。
ここまで読めば言えるようになること
- トークンという単位で制限と料金が決まると説明できる
- コンテキストウィンドウを踏まえた会話の切り方ができる
- プロンプトで結果を左右する4つの要素を挙げられる
- 知識のカットオフを踏まえて質問を選べる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(トークン、コンテキスト、プロンプト)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:トランスフォーマーと学習の2段階を説明でき、ハルシネーションが起きる理由を仕組みから語れる
大規模とは、何が大規模なのか
言語モデル自体は、以前からありました。
文章や単語の出やすさを確率としてとらえ、次に来る言葉を予測する仕組みです。
スマホの予測変換も言語モデルの一種です。
LLMは、これを3つの面で大きくしたものです。
- 学習に使うデータ量
- 学習にかける計算量
- モデルの中の調整値であるパラメータの数
パラメータは、モデルの中にある調整つまみだと考えてください。その数は数十億から数千億にのぼります。
→ AIモデルのパラメータとは|「〇億パラメータ」の意味と読み方
この3つを大きくするほど性能が予測どおりに上がる、という関係はスケーリング則と呼ばれ、2020年の論文で示されました。
ただし、大きさだけでは決まらない
規模は、性能の目安の一つにすぎません。
それをはっきり示したのが、2022年の論文です。
人間の評価をもとに調整した13億パラメータのモデルの出力が、調整していない1750億パラメータのモデルの出力よりも好まれました。
パラメータの数は100分の1以下です。
学習データの質と、そのあとの調整の仕方で、性能は大きく変わります。
パラメータの数だけでモデルの優劣は決まりません。
トランスフォーマーとアテンション
現在のLLMの多くは、トランスフォーマーという構造を土台にしています。
2017年に発表された「Attention Is All You Need」という論文で示された構造です。
その中心にあるのがアテンション(注意機構)です。
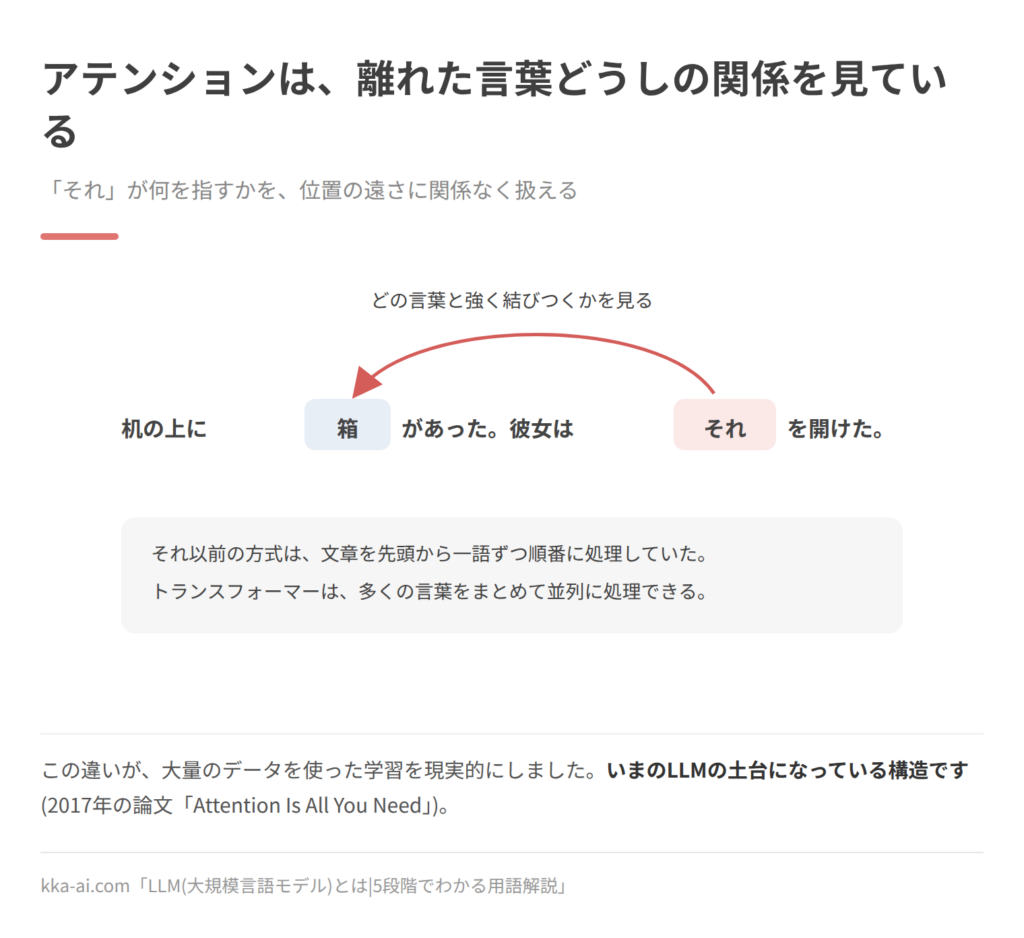
アテンションは、文章の中でどの言葉がどの言葉と強く関係しているかを捉え、文脈に応じて大事な部分に注目します。
「彼女はそれを開けた」という文の「それ」が何を指すかを、離れた位置にある言葉との関係から扱えます。
トランスフォーマー以前の方式は、文章を先頭から一語ずつ順番に処理していました。
トランスフォーマーは、多くの言葉をまとめて並列に処理できます。
この違いが、大量のデータを使った学習を現実的にし、LLMの大規模化を可能にしました。
学習は2段階に分かれる
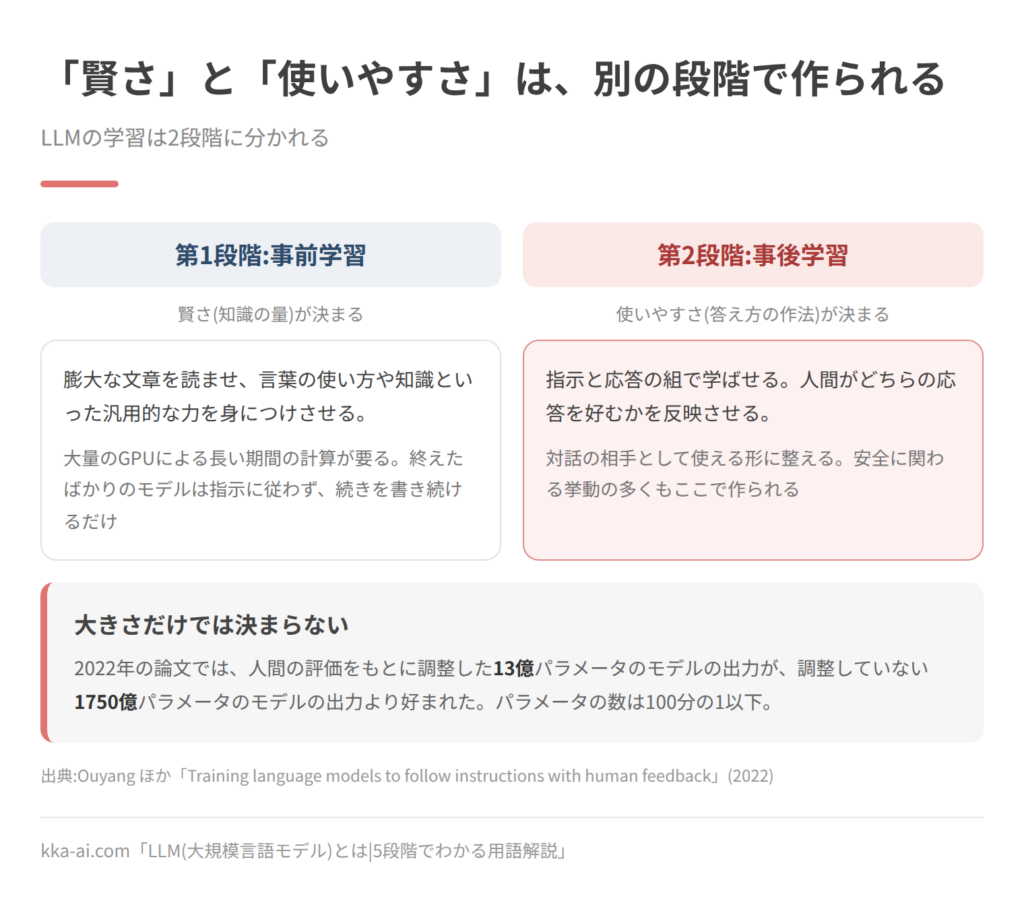
LLMの学習は、大きく2つの段階に分かれます。
第一段階が事前学習です。
大量のテキストを読ませ、言葉の使い方や知識といった、汎用的な言語の力を身につけさせます。
膨大な文章と、大量のGPUによる長い期間の計算が必要になります。
第二段階が事後学習です。
事前学習を終えたばかりのモデルは指示に従わず、文章の続きを書き続けるだけです。
そこで、指示と応答の組で学ばせたり、人間がどちらの応答を好むかを反映させたりして、対話の相手として使える形に整えます。
「賢さ」と「使いやすさ」は、この2段階に対応しています。
知識の量は事前学習で、指示への従い方や答え方の作法は事後学習で決まります。
前の節の「13億が1750億に勝った」話は、事後学習の差によるものでした。
ハルシネーションは、仕組みから来ている
ここまで来ると、ハルシネーションがなぜ起きるかが説明できます。
LLMは、確率的にもっともらしい続きを組み立てる仕組みです。
「知らない」という状態を見つけて黙る仕組みは、その中に含まれていません。
学習データにない事柄を聞かれても、形として自然な文字列が作られます。
つまり、ハルシネーションは不具合ではなく、この方式の帰結です。
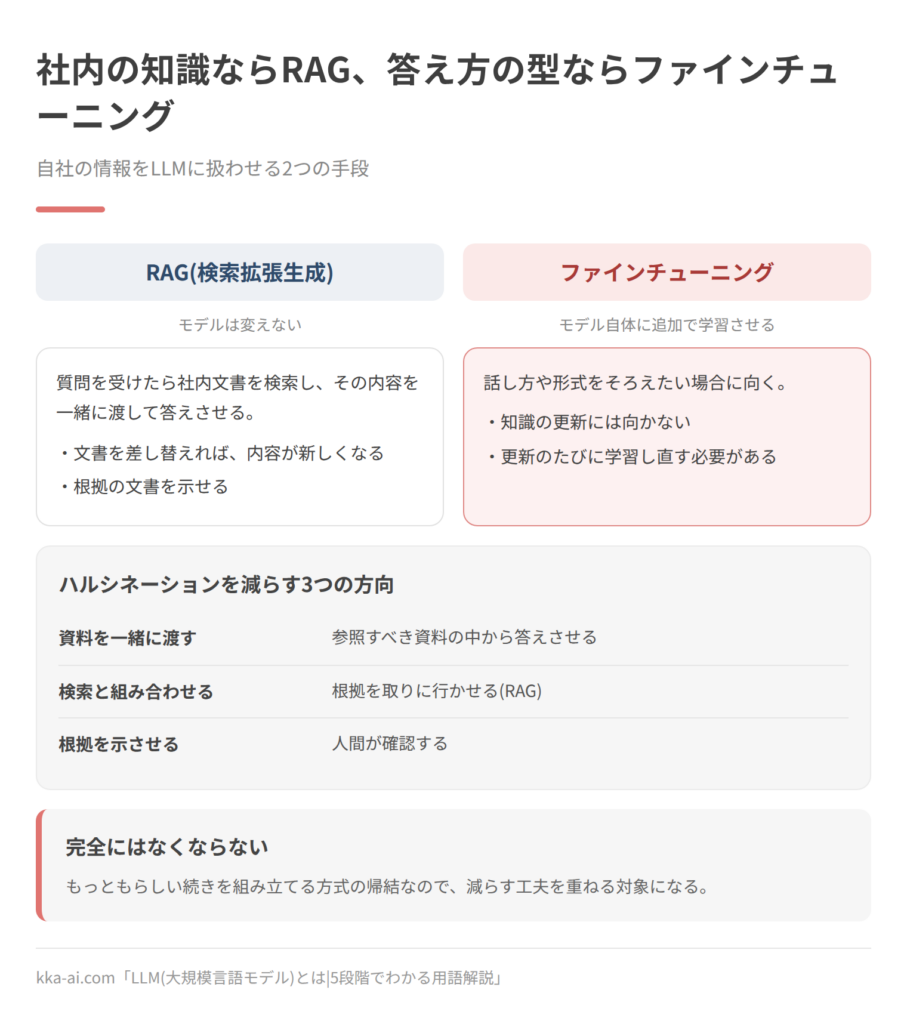
完全になくすことはできず、減らす工夫を重ねる対象になります。
減らす方向は主に3つです。
- 参照すべき資料を一緒に渡して、その中から答えさせる
- 検索と組み合わせて、根拠を取りに行かせる(次のRAG)
- 答えの根拠を示させて、人間が確認する
RAGとファインチューニングの違い
自社の情報をLLMに答えさせたい、という場面で使われる方法が以下のRAGとファインチューニングです。
RAG(検索拡張生成)は、質問を受けたときに社内文書やデータベースを検索し、その内容を一緒に渡して答えさせる方式です。
モデル自体は変えません。
文書を差し替えれば内容が新しくなり、根拠の文書を示せる点が、実務では大きな利点です。
→ RAGとは|5段階でわかる用語解説
ファインチューニングは、モデル自体に追加の学習をする方式です。
話し方や形式をそろえたい場合に向きますが、知識の更新には向きません。
更新のたびに学習し直す必要があるためです。
→ ファインチューニングとは|5段階でわかる用語解説
社内の知識を答えさせたいならRAG、答え方の型をそろえたいならファインチューニング。
この使い分けが基本です。
LLM進化の最近の方向
LLMの進化には、いくつかの方向があります。
マルチモーダル化は、テキストに加えて画像や音声、動画も扱えるようにする流れです。
→ マルチモーダルAIとは|5段階でわかる用語解説
推論に時間をかけるモデルは、すぐに答えを返すのではなく、段階を踏んで考えてから出力します。
複雑な問題で正確さが上がる一方、応答までの時間と費用は増えます。
AIエージェントは、LLMが自分でツールを使い、複数の手順からなる作業を進める使い方です。
→ AIエージェントとは|5段階でわかる用語解説
軽くて費用の小さい小規模言語モデル(SLM)も注目されており、用途に応じて大小を使い分ける動きも出ています。
つまずきポイント
「LLMは意味を理解しているのか」
人間と同じ意味での理解をしているとは考えられていません。
LLMは、言葉どうしの関係の統計から、もっともらしい続きを組み立てています。
ただし、理解していないから使えない、という話でもありません。
統計的に組み立てた出力が、多くの実務で十分に使える水準に達したことが、現在の状況です。
この区別があいまいなら、Level 1の「続きを当てるゲーム」に戻ってください。
理解度チェック
Q1. LLMの「大規模」は、何を大きくしたことを指しますか?
学習データの量、計算量、パラメータの数の3つです。
Q2. パラメータの数だけでモデルの優劣が決まらない例を挙げてください。
人間の評価をもとに調整した13億パラメータのモデルの出力が、調整していない1750億パラメータのモデルの出力より好まれた例です(2022年の論文)。
Q3. ハルシネーションが完全にはなくならないのはなぜですか?
確率的にもっともらしい続きを組み立てる方式そのものの帰結だからです。
「知らない」を見つけて黙る仕組みは含まれていません。
Q4. 社内文書に答えさせたい場合、RAGとファインチューニングのどちらを選びますか?
RAGです。
文書の差し替えで内容を新しくでき、根拠の文書も示せます。
ファインチューニングは答え方の型をそろえるのに向きます。
ここまで読めば言えるようになること
- 大規模化の3要素を挙げられる
- トランスフォーマーとアテンションの役割を説明できる
- 事前学習と事後学習で何が決まるかを分けて説明できる
- ハルシネーションの原因を仕組みから説明できる
- RAGとファインチューニングを使い分けられる
いま使われている主なモデルと、国産のLLMの状況は、動向版に時点つきでまとめています。
→ 主要LLMの最新動向2026|海外勢と国産モデル、政府の取り組み
仕事で導入や選定に関わるなら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(トランスフォーマー、2段階の学習、RAG)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:自社に合うLLMの使い方を、費用とリスクの両面から判断できる
具体的なモデル名、国産LLM、提供の状況は、動向版にまとめています。
→ 主要LLMの最新動向2026|海外勢と国産モデル、政府の取り組み
導入の形は4つに分かれる
LLMを業務で使う形は、費用と難しさの順で以下のように並べられます。下にいくほど難易度が上がります。
- 一般向けの有料プランを個人単位で使う:手軽だが、入力内容の扱いと社内の統制が課題になる
- 法人プランやチーム向けプランを契約する:管理者機能があり、入力を学習に使わない設定を組織単位で適用できる
- APIを自社のシステムに組み込む:従量課金。既存の業務システムやチャットツールに組み込む形。開発が必要
- RAGを作って社内文書に答えさせる:文書の整備が前提になり、構築の費用も大きくなる
このほか、機密性がとくに高い場合に、自社の環境にモデルを置いて動かす選択肢もあります。
データを外に出さずに済む一方、GPUの調達と運用の体制が要ります。
→ オープンソースとオープンウェイトとは|AIの「公開」の違いを5段階でわかる用語解説
多くの会社は、上の2つで効果を確かめてから下に進む順序が無難です。
料金はトークンで決まる
APIを使う場合、料金は処理したトークン数で決まります。
入力トークンと出力トークンで単価が異なり、一般に出力のほうが高く設定されています。
→ APIとは|5段階でわかる用語解説
見積もりは、次の順で立てます。
- 1件あたりの入力文字数と出力文字数を見積もる
- 使うモデルで、自社の代表的な文章が何トークンになるかを測る
- 想定件数を掛ける
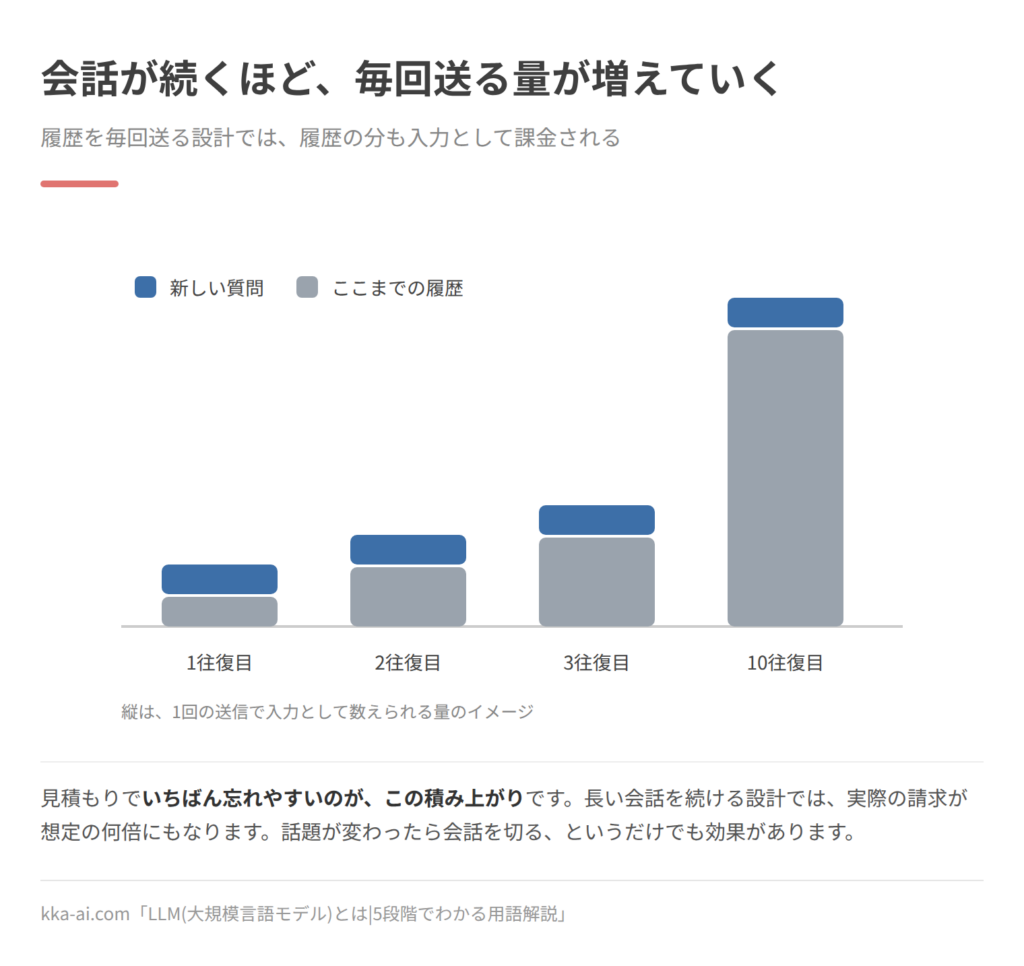
- 会話の履歴を毎回送る設計なら、その分を上乗せする
4を忘れると、実際の請求が想定の何倍にもなります。
長い会話を続ける設計では、履歴が毎回入力トークンとして課金されるためです。
モデルごとの単価は短い期間で変わります。
発注の前に、その時点の公式の価格表を確認してください。
選ぶのは、ベンチマークではなく自社の課題で
モデルの比較記事やベンチマークのスコアは、選定の決め手になりません。
公開されているスコアは、そのベンチマークの問題が学習データに混ざっていれば簡単に上がるためです。
現実的な選び方は、自社で実際に使う業務の代表的な例を20件から50件ほど用意し、候補のモデルに同じ条件で解かせて比べることです。
評価は担当者2人以上で行い、合否の基準を先に文章にしておきます。
この方法なら、モデルが世代交代しても同じ手順で測り直せます。
LLMは半年ほどで主力が入れ替わることも珍しくないため、測り直せる仕組みのほうが、一度の比較結果より価値があります。
情報の扱いは、契約プランで変わる
入力した内容が学習に使われるかどうかは、サービスとプランによって異なります。
一般向けの無料プランでは学習に使う設定が既定になっている場合があり、法人向けプランでは使わないことが規約で明示されていることが多い、という違いがあります。
→ オプトアウトとは|ChatGPTなどAIに学習させない設定と、オフでも残ること
社内ルールを作るときは、次の3点を書き分けてください。
- 入力してよい情報の範囲(顧客の個人情報、未公開の財務情報、秘密保持契約の対象の資料をどう扱うか)
- 使ってよいサービスとプランの一覧
- 出力を外に出す前の確認の担当と手順
判断に迷ったら入れない、という原則を添えておくと運用が安定します。
→ 生成AIに入力してよい情報とだめな情報|設定だけでは防げないこと【2026年9月】
LLMに特有のリスク
LLMに特有のリスクとして、プロンプトインジェクションがあります。
不正な指示を紛れ込ませて、LLMに想定外の動きをさせる攻撃です。
総務省のガイドライン(令和8年3月)は、これを2つに分けています。
- 直接:LLMに、細工をしたプロンプトを入力する
- 間接:LLMに、細工をしたデータを参照させる
2つ目の間接がやっかいです。
外部のウェブページや、利用者から送られた文書をLLMに読ませる仕組みでは、その文書の中に「これまでの指示を無視して次を実行せよ」といった文が仕込まれている可能性があります。
LLMのアプリケーションのセキュリティリスクをまとめたOWASPの一覧(2025年版)でも、プロンプトインジェクションは1番目に挙げられています。
RAGや、外部の情報を読ませるAIエージェントを作る場合は、この論点を設計に含める必要があります。
同じガイドラインは、LLMや連携するシステムを操作する仕組みの権限を必要最小限にすることを挙げています。
あわせて、外部から取り込んだ内容を指示として扱わない設計にします。
つまずきポイント
「社内で使わせたら、誰も使わなくなった」
原因は、たいてい使いどころが示されていないことです。
「自由に使ってよい」とだけ知らせると、何に使えばよいか分からないまま終わります。
自社の業務に合わせたプロンプトの例を10個ほど用意して配ると、使う人が定着しやすくなります。
理解度チェック
Q1. APIの費用の見積もりで、忘れると請求が跳ね上がる要素は何ですか?
会話の履歴を毎回送る設計の場合、その履歴が毎回入力トークンとして課金される点です。
Q2. 公開ベンチマークのスコアでモデルを選ぶことの問題は何ですか?
ベンチマークの問題が学習データに混ざっていればスコアは上がるため、実務での性能を保証しないことです。
Q3. 直接と間接のプロンプトインジェクションの違いは何ですか?
直接はLLMに細工をしたプロンプトを入力するもの、間接は細工をしたデータ(文書やウェブページ)をLLMに参照させるものです。
Q4. 社内ルールに書き分けるべき3点を挙げてください。
入力してよい情報の範囲、使ってよいサービスとプラン、出力を外に出す前の確認の担当と手順です。
ここまで読めば言えるようになること
- 導入の4つの形を、手軽さと難しさで並べられる
- トークン課金の見積もりを、履歴の分まで含めて立てられる
- 自社の課題でモデルを比べる手順を組める
- プロンプトインジェクションを設計の論点として挙げられる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:LLMの内部構成と運用上の制約を、費用と性能の観点から結び付けて説明できる
トークナイザと日本語の費用
テキストは、まずトークナイザによって語彙のIDの列に変換されます。
主流はサブワード分割で、バイト対符号化やその派生が使われます。
日本語では、語彙にどれだけ日本語の断片が含まれているかで、同じ文章のトークン数が変わります。
語彙が英語中心のモデルでは、日本語の1文字が複数のトークンに分割されることもあり、同じ内容でも入力トークン数と費用が増えます。
日本語での費用を比べる場合は、単価だけでなく、自社の代表的な文章を実際にトークン化して測るのが確実です。
自己注意の計算量と、KVキャッシュ
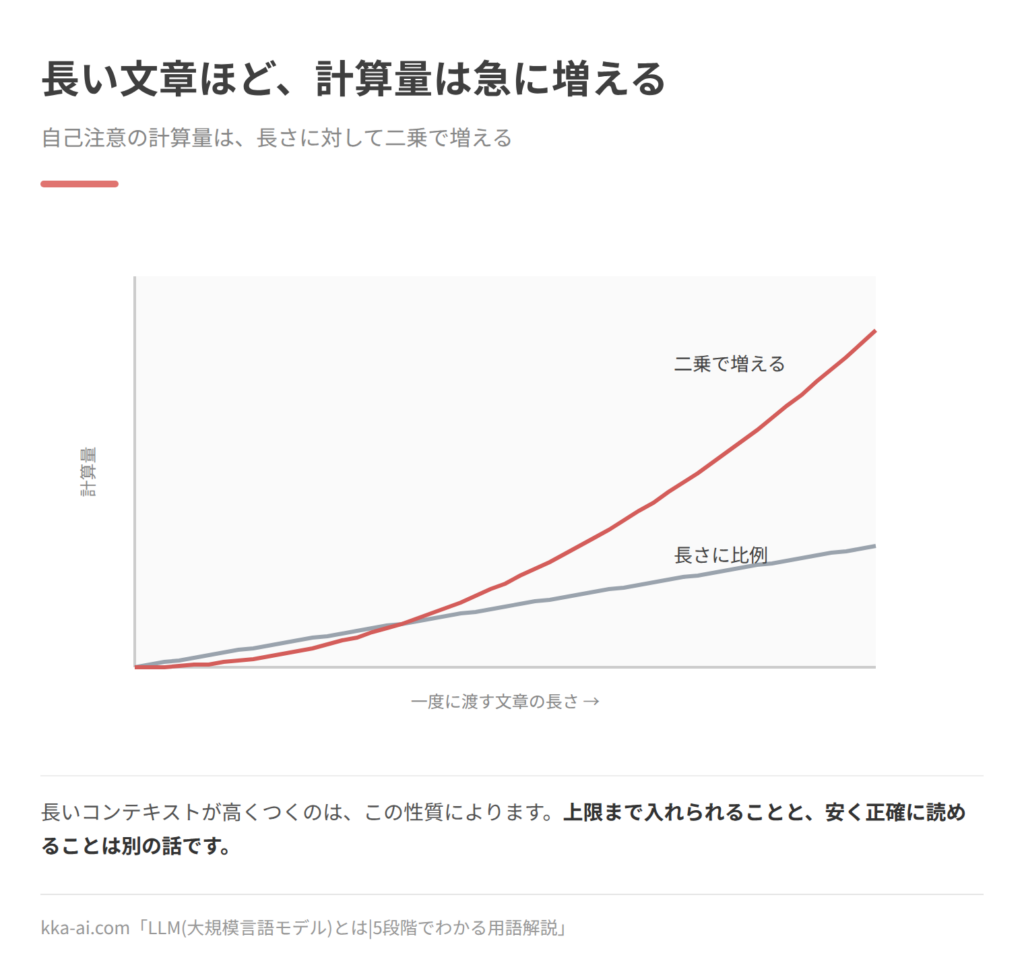
トランスフォーマーの自己注意は、系列長に対して二乗のオーダーで計算量が増えます。
長いコンテキストが高くつくのは、この性質によります。
生成のときには、過去のトークンの鍵と値を再計算しないよう保持するKVキャッシュが使われます。
これによって生成そのものは系列長に線形になりますが、キャッシュはGPUのメモリを占め、その量は系列長とバッチサイズに比例します。
長いコンテキストと高い同時実行数は、このメモリで衝突します。
推論基盤の設計では、計算能力よりも、メモリ帯域とメモリ容量が先に制約になることが多くなります。
長いコンテキストを「使える」かは別の話
コンテキストウィンドウが長いことと、その全体を有効に使えることは別問題です。
2023年の論文「Lost in the Middle」は、関係する情報が入力の最初か最後にあるときに性能が最も高く、中ほどにあると大きく下がることを示しました。
重要な指示は先頭か末尾に置く、という実装上の経験則は、この傾向につながっています。
長文への対応としては、注意の範囲を絞る方式、位置の表現を外挿する方式、注意の計算をメモリ効率よく行う実装などがあります。
混合エキスパートという規模の稼ぎ方
混合エキスパート(MoE)は、複数の部分ネットワークを持ち、トークンごとに一部だけを選んで計算する構成です。
総パラメータ数を増やしながら、1トークンあたりの計算量を抑えられます。
このため、MoEのモデルでは、総パラメータ数と実際に使われるパラメータ数(活性パラメータ数)が異なります。
公表された総パラメータ数だけで計算資源を見積もると外れるので、計算量は活性パラメータ数で見積もります。
一方、総パラメータ分の重みはメモリに載せる必要があるため、メモリの要件は総パラメータ数で決まります。
事後学習の系統
事前学習を終えたモデルを、対話に使える形にするのが事後学習です。
教師ありファインチューニング(SFT)は、指示と応答の組で学ばせる工程です。
人間のフィードバックによる強化学習(RLHF)は、応答の優劣についての人間の判断から報酬モデルを学習し、それを目標にモデルを最適化します。
Level 3で触れた2022年の論文(InstructGPT)は、この組み合わせの代表例です。
報酬モデルを明示的に置かず、選好データから直接最適化するDPO(2023年)のような手法も広く使われています。
安全性に関わる挙動の多くも、この段階で作られます。
同じ事前学習済みモデルでも、事後学習の違いで出力の性質は大きく変わります。
推論時に計算を積む方向
近年は、学習のときではなく、推論のときに計算を積んで性能を上げる方向が出てきています。
段階的に考える過程を生成させる方式、複数の候補を作って選ぶ方式、作った内容を自分で検証させる方式などです。
これらは、精度と引き換えに、出力トークン数と応答時間を増やします。
業務に組み込むときは、どの処理に推論の計算を厚く配分するかを、処理ごとに決めることになります。
全件に厚い推論を当てると、費用が想定を大きく超えます。
軽量化の手段
運用の費用を下げる手段は、主に3つです。
量子化は、重みを低いビット幅で表してメモリと計算を削る手法です。
8ビットや4ビットが実用で使われ、精度の低下は用途によっては許容範囲に収まります。
蒸留は、大きなモデルの出力を教師にして小さなモデルを学習させ、特定の用途に絞って性能を近づける手法です。
モデルの使い分けは、単純な処理を小さなモデルに、難しい処理だけを大きなモデルに振り分ける設計です。
実運用では、これが費用対効果の最も大きい手段になることが多くなります。
評価とハルシネーションの扱い
公開ベンチマークは、学習データへの混入(汚染)を完全には排除できません。
自社の業務データから評価用の問題を作り、公開されていない問題で測るのが確実です。
ハルシネーションは方式上の帰結なので、検出と抑制の設計になります。
根拠の文書を示させて出典を確かめる、何回か生成した結果の一致度を見る、外部の知識源との整合を機械的に確かめる、といった手段を組み合わせます。
モデルが出す確率の値は、次のトークンのもっともらしさを表すもので、内容の正しさの信頼度としてはそのまま使えない点にも注意が要ります。
進み方
原典に当たるなら、arXivのcs.CL(計算言語学)とcs.LG(機械学習)が主な発表先です。
査読前の原稿が多いので、追試や実装の公開状況を確かめながら読むことになります。
この記事で触れた原論文は、末尾の【参考】にまとめました。
スケーリング則、トランスフォーマー、事後学習、長いコンテキストの4本から読むと、現在の議論の土台がそろいます。
機械学習の一般的な理論の側から補強したい場合は、こちらのLevel 5が対応します。
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
理解度チェック
Q1. 日本語でLLMの費用を比べるとき、単価以外に確認すべきことは何ですか?
トークナイザの分割効率です。
語彙が英語中心のモデルでは、同じ日本語の文章でもトークン数が増え、費用が上がります。
Q2. 長いコンテキストと高い同時実行数が衝突するのはなぜですか?
KVキャッシュがGPUメモリを占め、その量が系列長とバッチサイズに比例するためです。
Q3. 「Lost in the Middle」が示した傾向は何ですか?
関係する情報が入力の最初か最後にあるときに性能が最も高く、中ほどにあると大きく下がる傾向です。
Q4. MoEのモデルで、計算量とメモリの見積もりには、それぞれどのパラメータ数を使いますか?
計算量は活性パラメータ数、メモリの要件は総パラメータ数で見積もります。
Q5. モデルが出す確率の値を、正しさの信頼度として使えないのはなぜですか?
その確率は次のトークンのもっともらしさを表すもので、内容の事実性を表していないためです。
ここまで読めば言えるようになること
- トークナイザの分割効率が費用を左右する理由を説明できる
- KVキャッシュから推論基盤のメモリ制約を導ける
- 長いコンテキストの「中ほど」が弱い傾向を、設計に反映できる
- MoEの総パラメータと活性パラメータを区別できる
- 量子化、蒸留、モデルの使い分けを費用対効果で比べられる
同じ質問を投げて、確かめたこと
私は前職のシステムエンジニアでの経験を生かして、AI分野の記事を書く仕事をしています。
その経験をもとに、このサイトを個人で立ち上げました。
前職では、同じ入力には必ず同じ結果を返すことを前提に仕組みを作っていました。
なので、同じ質問でも答えが毎回変わると知ったときには驚きました。もう1つ意外だったのは、わからない質問にも「わからない」と答えず、間違った答えをもっともらしく説明したことです。
2026年9月19日に、Gemini、ChatGPT、Claudeの3つに、同じ質問を新しい会話で3回ずつ投げてみました。
GeminiとChatGPTは無料版です。Claudeは有料プランのアカウントで、無料版でも使えるSonnetを選んで試しました。
どのサービスもログインをしていますが、シークレットモードにして、過去の会話や設定の影響が出ないようにしています。
| 質問 | 3回の答え |
|---|---|
| 答えが1つに決まる質問(クイズ1) | 3通りに割れた(誤答が2つ、わからないと答えたのが1つ) |
| 答えが1つに決まる質問(クイズ2) | すべてのサービスで3回とも正解 |
| 記事の見出し案を5つ | 3通りに割れ3回ともやや異なる出力 |
見出し案が毎回違うのは、そのまま使えるので助かりました。
意外だったのは、答えが決まる質問でも「間違える」「わからないと答える」「3回とも答えが異なる」というパターンがあったことです。
本文に「正確さが要る場面では弱点」と書いたのは、この結果からです。
まとめ
LLM(大規模言語モデル)は、大量のテキストを学習し、続きに来る言葉を確率的に予測することで文章を扱うAIモデルです。
Level 1では、続きの言葉を当てるのが上手な機械。
Level 2では、トークンとコンテキストという制約を持つ道具。
Level 3では、トランスフォーマーと2段階の学習で作られた仕組み。
Level 4では、費用とリスクを見積もって選ぶ対象。
Level 5では、メモリと計算量の制約の中で運用を設計する対象。
どのレベルでも共通するのは、LLMが正しさではなく、もっともらしさを出力しているという一点です。
この性質を押さえておけば、うまくいかないときに原因の見当が付くようになります。
次に読む記事
同じ5段階シリーズで、土台になる2本です。
→ AIとは何か|子供向けから専門的な話まで5段階でわかる用語解説
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
使い方の側に進むならこちらです。
→ プロンプトとは?生成AIで必須の用語の意味と、初心者が最初に覚える「1つの型」を解説
→ APIとは|5段階でわかる用語解説
→ AIエージェントとは|5段階でわかる用語解説
用語をまとめて確認したい場合は、こちらが索引になります。
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
よくある質問(FAQ)
Q. LLMとは何ですか?
A. Large Language Model(大規模言語モデル)の略で、大量のテキストを学習し、続きに来る言葉を予測することで文章を作るAIモデルです。ChatGPTなど多くの生成AIサービスの中核を担っています。
Q. LLMとChatGPTの違いは何ですか?
A. LLMは言葉を扱う技術そのもので、ChatGPTはそのLLMを対話向けに整えて使えるようにしたサービスです。エンジンと車の関係にあたります。
Q. LLMと生成AIの違いは何ですか?
A. 生成AIは文章、画像、音声、動画などを新しく作り出すAIの総称です。LLMはそのうちテキストを扱う中核の技術で、生成AIという大きな枠に含まれます。
Q. 同じ質問なのに毎回答えが変わるのはなぜですか?
A. LLMが続きの候補を確率つきで持ち、その中からばらつきを持って選ぶためです。不具合ではなく設計であり、このばらつきが文章の多様さを生んでいます。
Q. ハルシネーションはなくせますか?
A. 完全にはなくせません。もっともらしい続きを組み立てる方式そのものの帰結だからです。参照資料を渡す、検索と組み合わせる、根拠を示させて人が確認する、といった手段で減らします。
Q. 社内文書にLLMを答えさせたい場合、どうすればよいですか?
A. RAG(検索拡張生成)が基本です。質問を受けたときに社内文書を検索し、その内容を渡して答えさせます。文書を差し替えれば内容が新しくなり、根拠も示せます。
Q. LLMの利用料金はどう決まりますか?
A. 処理したトークン数で決まります。入力と出力で単価が異なり、会話の履歴を毎回送る設計では履歴の分も入力として課金されます。単価は短い期間で変わるため、発注の前に公式の価格表を確認してください。
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
※統計やガイドラインは、公表時点の情報です。改訂されるため、記述の時点をあわせて確認してください。
参考
利用の状況
- 総務省「令和8年版 情報通信白書」第Ⅰ部 第1章 第1節「個人におけるAI利用の現状」 https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r08/html/nd111110.html
(日本で生成AIサービスを使っている・使ったことがある割合:2023年度調査9.1%→2024年度調査26.7%→2025年度調査58.8%、20代78.2%、15〜19歳91.7%。米国46.3%→68.8%→75.6%、中国56.3%→81.2%→93.6%)
セキュリティ
- 総務省「AIのセキュリティ確保のための技術的対策に係るガイドライン」(令和8年3月) https://www.soumu.go.jp/main_content/001064122.pdf
(直接・間接のプロンプトインジェクション、オーケストレータの権限を必要最小限にする) - OWASP「LLM01:2025 Prompt Injection」(OWASP Top 10 for LLM Applications 2025) https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- 総務省・経済産業省「AI事業者ガイドライン(第1.2版)」(令和8年3月31日) https://www.meti.go.jp/shingikai/mono_info_service/ai_shakai_jisso/pdf/20260331_1.pdf
Level 3・5で触れた論点の原典
本記事の体験の節は、筆者が自分で試した記録です(実施日は本文に記載)
- Jared Kaplan ほか「Scaling Laws for Neural Language Models」(2020) https://arxiv.org/abs/2001.08361
- Ashish Vaswani ほか「Attention Is All You Need」(2017) https://arxiv.org/abs/1706.03762
- Long Ouyang ほか「Training language models to follow instructions with human feedback」(2022) https://arxiv.org/abs/2203.02155
(13億パラメータのInstructGPTの出力が、1750億パラメータのGPT-3の出力より好まれた) - Rafael Rafailov ほか「Direct Preference Optimization: Your Language Model is Secretly a Reward Model」(2023) https://arxiv.org/abs/2305.18290
- Nelson F. Liu ほか「Lost in the Middle: How Language Models Use Long Contexts」(2023) https://arxiv.org/abs/2307.03172