パラメータ とは、AIモデルの内部にあり、学習によって調整される数値のことです。「〇億パラメータ」という表現は、その数値が何個あるかを示しています。
「パラメーター」と長音をつけて書かれることもありますが、同じものです。「モデルパラメーター」「モデルのパラメータ」も、この記事で扱う数値を指します。
「パラメータ数7000億の巨大モデル」「小型ながら高性能な80億パラメータ」。 AIのニュースでは、モデルの規模がパラメータ数で報道されます。
パラメータというとゲームのステータス画面を連想する人もいるかもしれませんが、AI用語のパラメータはもう少し具体的な実体を持っています。 そして、この数字の意味を知ると、「大きい=すごい」という単純な図式が近年崩れつつあることまで見えてきます。
本記事では、パラメータを「モデル内部にある、学習で調整される数値」として押さえ、その数が何を意味するのかを解説します。
先に確認しよう「7B」「70B」「1000億」の読み方
英語圏のニュースや、モデルの名前に出てくる「7B」「70B」は、パラメータの数を表しています。
Bは「billion(10億)」の頭文字です。
| 表記 | 読み方の例 | パラメータの数 |
|---|---|---|
| 7B | 7ビリオン(セブンビー) | 70億 |
| 8B | 8ビリオン(エイトビー) | 80億 |
| 70B | 70ビリオン | 700億 |
| 100B | 100ビリオン | 1000億 |
| 675B | 675ビリオン | 6750億 |
| 1T | 1トリリオン | 1兆(1000B) |
日本語の記事の「約7,000億パラメータ」は、英語では「700B」です。
「1000億」は「100B」と同じ数です。
Bはバイトの単位ではありません。
モデルを動かすのに必要なメモリや、ファイルの大きさは「GB(ギガバイト)」で表します。
7Bのモデルが14GBほどになるのは、パラメータ1個に2バイトを使うとして計算した場合です(→ メモリの必要量)。
BとGBは、別の単位です。
「70B」のような表記は、そのまま読んで通じます。
「ななじゅうビー」「セブンティービー」など、決まった読み方はありません。
パラメータとは?その正体
まず、パラメータという言葉を解説します。 混同しやすい別物との区別しておくと、この後の話を安心して読み進められるでしょう。
モデル内部の「調整つまみ」
AIのモデルの実体は、膨大な数値の集まりです。 この一つひとつの数値がパラメータで、比喩としては「調整つまみ」が最も実感に近いと思います。
音響機器のミキサーを思い浮かべてください。 つまみを回すと音の出方が変わるように、パラメータの値が変わると、モデルの出力(答え方)が変わります。
モデルという言葉そのものはAIのモデルとはで解説しています。
つまみを回す作業が「学習」
AIの学習とは、このつまみを正解に近づく方向へ少しずつ回し続ける作業です。
ミキサーと違うのは、つまみの数です。 大規模言語モデルでは、つまみが数十億から数兆個あります。 「〇億パラメータのモデル」とは、「〇億個の調整つまみを持つモデル」という意味です。
人間がこの数のつまみを手で回すことは不可能なので、コンピュータが大量のデータを使って自動で回します。AI開発に膨大な計算資源が必要な理由は、ここにあります。
工程の詳細はAIの学習とはを参照してください。
「設定のパラメータ」とは別物
紛らわしいことに、AIの利用画面やAPIにも「パラメータ」と呼ばれる項目があります。 応答のランダムさを調整する項目や、出力の長さの上限などです。
これらは利用者が変えられる設定値であり、この記事で説明しているモデル内部の学習済みの数値とは別物です。
区別は簡単で、利用者がいじれるものは設定、いじれないものがモデルのパラメータです。
技術記事で「パラメータを調整」とあったら、文脈がモデル開発の話か、利用時の設定の話かを見分けてください。
AIのアプリやAPIの画面で見かける設定項目には、次のようなものがあります。
GoogleのGemini APIの説明をもとに、意味をまとめます。
| 設定項目 | 何を決めるか | 値の目安 |
|---|---|---|
| temperature(温度) | 言葉を選ぶときのランダムさ | 低いと決まった答えに寄り、高いと多様で創造的になる。0は決定的で、最も確率の高い答えが選ばれる |
| topK | 候補にするトークンの数 | 1なら、最も確率の高いトークンだけが選ばれる |
| topP | 確率の高い順に、合計が何割になるまでを候補にするか | 既定値は0.95。0.5なら、確率の合計が0.5に達するまでの候補から選ぶ |
| Max output tokens(最大出力トークン数) | 応答の長さの上限 | トークンの数で指定する |
これらは、利用者が変えられる設定です。
この記事で説明している、モデルの内部にある「〇億個の数値」(学習で決まる重みとバイアス)とは別物で、設定を変えても、モデルの賢さが変わるわけではありません。
なお、Googleの説明は、Gemini 3系のモデルではtemperatureを既定値のままにすることを強く勧めています。
値を下げると、複雑な計算や推論で、ループや性能低下が起きることがあるためです。
設定項目の初期値は、サービスやモデルによって違います。
変える前に、そのサービスの説明を確かめてください。
「ハイパーパラメータ」とも別物
もう1つ紛らわしいのがハイパーパラメータです。
学習を始める前に、開発者が決めておく設定値を指します。
代表的なものは学習率で、1回の学習でつまみをどれくらい大きく回すかを決めます。
Googleの機械学習の用語集では、学習率を0.01で試し、大きすぎれば次の学習で0.003に下げる、という例で説明されています。
つまり、同じ「パラメータ」という語が、立場によって3つのものを指します。
| 呼び方 | 何か | 誰が決めるか | 例 |
|---|---|---|---|
| モデルのパラメータ | モデル内部の数値(重みとバイアス) | 学習によって自動で決まる | 「70億パラメータ」の70億個 |
| ハイパーパラメータ | 学習のやり方を決める設定値 | 学習を始める前に開発者が決める | 学習率 |
| 生成時の設定 | 応答の出し方を決める設定値 | 利用者が画面やAPIで変える | 応答のランダムさ、出力の長さの上限 |
ニュースで「〇億パラメータ」と出てきたら、1行目のモデルのパラメータです。
開発の記事で「パラメータを調整した」とあれば2行目か3行目のことが多いので、文脈で見分けてください。
パラメータ数とAIの賢さとの関係
言葉の実体が分かったところで、本題に入ります。 パラメータ数はなぜ賢さの目安とされ、そしてなぜその見方が崩れつつあるのか。 AI開発の10年を動かした経験則と合わせて整理します。
なぜパラメータは「賢さの目安」になったのか
つまみが多いほど、モデルは複雑なパターンを表現できます。
単語の意味、文法、事実の知識、文脈の読み取りといった多様な能力を詰め込むには、それだけ多くのつまみが要る、という関係です。
ニュースで「過去最大級のモデル」と報じられるときの大きさは、基本的にこのパラメータ数(または学習の計算量)を指しています。
スケーリング則とは?パラメータの理解に必要な用語
パラメータ数の意味を理解するうえで欠かせないのが、スケーリング則 という言葉です。「モデルの規模、データ量、計算量を増やすほど、性能が法則的に伸びる」という経験則を指します。
2020年前後にこの法則が確認され、各社がモデルの大型化を競いました。数百万から始まったパラメータ数は、数年で数千億の規模まで駆け上がります。
この経験則が画期的だったのは、性能向上に資金を積めるようになった点です。賢いアイデアを待つのではなく、資金を投じて規模を拡大すれば性能の伸びがある程度予測できる。2020年代前半のAI開発競争が資本の勝負の様相を呈したのは、この法則が投資の根拠になったからです。
巨大データセンターの建設、GPUの争奪、電力問題。AIを巡るニュースの多くは、スケーリング則を信じた投資がもたらしたものです。
「パラメータが大きいほど賢い」が崩れつつある3つの理由
ところが近年、パラメータ数を賢さの物差しにする見方は、急速に古くなっています。 理由は3つあります。
小型モデルの性能が急伸したから
1つ目に、小型モデルの性能が急伸したことです。 学習データの質の改善や、大型モデルの能力を小型に引き継がせる「蒸留」などの技術によって、一世代前の大型モデルに匹敵する小型モデルが次々と登場しています。 「小さいのに賢い」が、業界の主要な競争軸になりました。
パラメータ数を非公開化するようになったから
2つ目は、パラメータ数の非公開化です。 かつては各社が数を競って公表していましたが、最先端モデルではパラメータ数を明かさないのが主流になりました。 公表される数字がなければ、物差しとしてそもそも使えません。
仕組みが多様化しているから
3つ目は、仕組みの多様化です。 質問の内容に応じて内部の一部だけを動かす構造(専門家の分業のような仕組み)のモデルでは、「総パラメータ数」と「実際に計算に使われる数」が別になり、単純な比較が成り立たなくなっています。
パラメータ数は時代の目安ではあっても、性能の保証ではなくなりました。
現在、モデルの実力は共通テスト(ベンチマーク)や利用者の評価で測るのが一般的です。
「規模の拡大だけでは伸びが鈍る」という議論も公然と語られるようになり、推論時に考える工程を増やす方式への注目は、学習の規模以外の伸びしろを探す動きでもあります。
パラメータ数の読み方
物差しとしての限界を踏まえたうえで、それでも数字が出てきたときの実用的な読み方を示します。 絶対値ではなくサイズ帯で読むのがコツです。
サイズ帯でとらえる
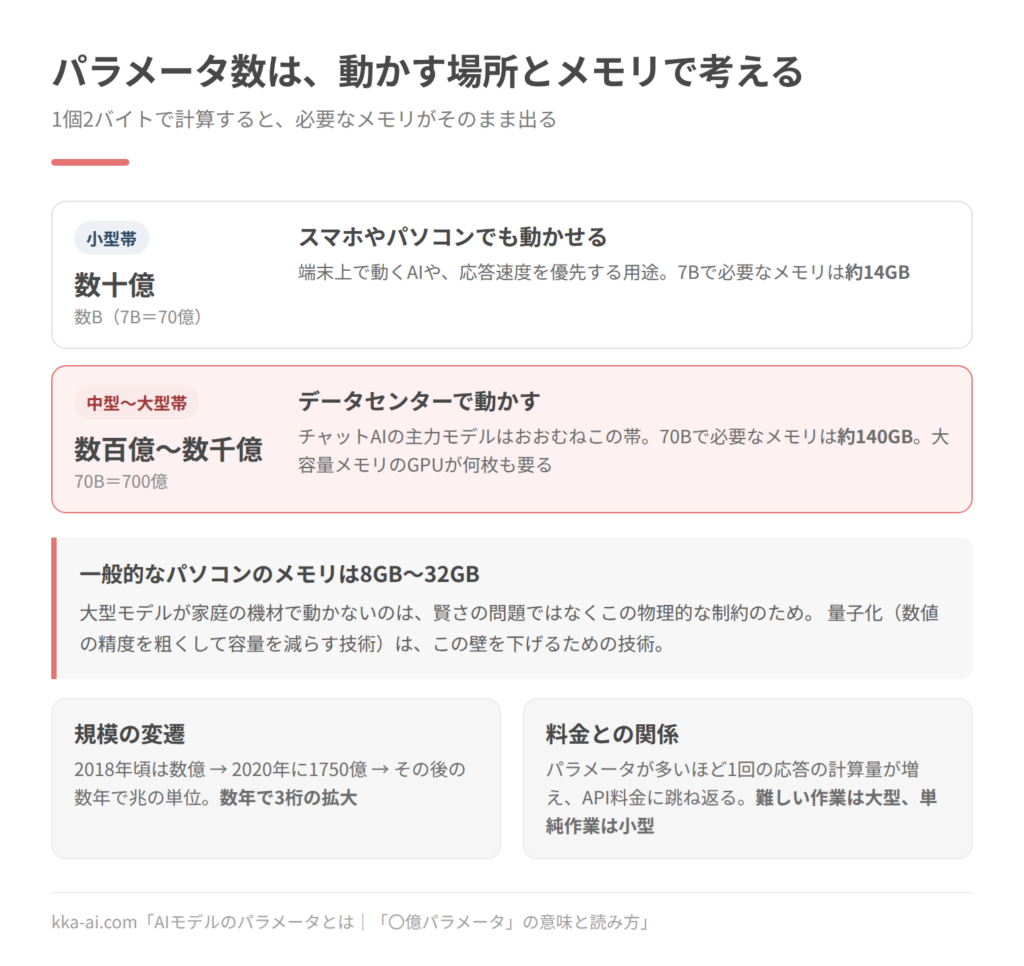
数十億(数B)クラスは、スマホやパソコンでも動かせる小型帯です。
端末上で動くAIや、応答速度優先の用途で使われます。
数百億から数千億のクラスは、データセンターで動かす中型から大型の帯です。
チャットAIの主力モデルは、おおむねこの帯にあります。
海外発のニュースでは、パラメータ数を「B」(billion、10億)で表記します。
「7B」は70億、「70B」は700億パラメータの意味です。
この読み方だけ覚えておくと、技術系の記事がぐっと読みやすくなります。
規模の変遷を並べると、2018年頃の言語モデルは数億パラメータでした。
2020年に1750億という数字が世界を驚かせ、その後の数年で兆の単位が語られるようになります。
数年で3桁の拡大です。
この急拡大の時期にパラメータ数が広報の主役だったこと、そして拡大が一巡した現在は効率が語られること。
数字の使われ方の変化そのものが、AI開発の局面の変化を映しています。
メモリの必要量:大型モデルに専用計算機が要る理由
パラメータは一つひとつが数値であり、モデルを動かすにはその全部を計算機のメモリに載せる必要があります。
1個のパラメータに2バイト使うとすれば、70億(7B)パラメータのモデルで約14GB、700億(70B)で約140GBのメモリが必要になる計算です。
一般的なパソコンのメモリが8GBから32GB程度であることを考えると、大型モデルが家庭の機材で動かない理由がそのまま分かります。
大規模モデルの推論に大容量メモリを積んだGPUが何枚も必要になるのは、この物理的な制約のためです。
逆に言えば、数十億パラメータ級の小型モデルなら最近のパソコンやスマホでも動きます。
量子化(数値の精度を粗くして容量を減らす技術)は、このメモリの壁を下げるための技術です。
「モデルのサイズ」という言葉が賢さの話とファイル容量の話の両方で使われるのは、パラメータ数がその両方を決めているからです。
料金との関係
パラメータが多いモデルほど、1回の応答に必要な計算量が増えます。
つまり推論のコストが上がり、API利用ではそのまま料金に跳ね返ります。
各社が大中小のサイズ展開を用意しているのは、このためです。
「難しい作業は大型、単純作業は小型」という使い分けは、パラメータ数と料金の関係を踏まえた基本のコスト戦略になっています。
料金の単位はトークンとはで扱っています。
ニュースでの数字の受け取り方
数字が出てくる記事を読むときに、確かめておくと役に立つ点を挙げます。
総数か、実際に使う数か
内部の一部だけを動かす構造のモデルでは、総パラメータ数と1回の応答で使われる数が違います。
発表資料が大きいほうの数字だけを出している場合があるので、両方が書かれているかを見てください。
どのモデルと比べているか
「同規模のモデルを上回る」という表現は、比較対象の選び方で印象が変わります。
比較相手が同世代か、旧世代かを確認するだけで、理解しやすくなります。
数字が出ていない場合
最先端モデルではパラメータ数が非公開なことが増えました。
数字がないこと自体は不誠実の証拠ではありません。
その場合は、ベンチマークの結果と、実際に自分の作業で試した感触で判断してください。
よくある質問(FAQ)
Q. 「7B」「70B」の「B」は何ですか。
A. billion(10億)の頭文字です。7Bは70億、70Bは700億、100Bは1000億のパラメータを表します。メモリやファイルの大きさを表す「GB」のバイトとは別の単位です。
Q. AIの設定画面にある「モデル・パラメーター」とは何ですか。
A. 画面によって指すものが違います。応答のランダムさ(temperature)や、応答の長さの上限(最大出力トークン数)などの設定項目を指している場合と、モデルの内部にある学習済みの数値を指している場合があります。利用者が変えられるのは前者です。
Q. パラメータには具体的に何が記録されているのですか?
A.一つひとつのパラメータは、単なる数値です。 「この単語が来たら次はこの単語が来やすい」といった知識が、特定の1個のパラメータに対応しているわけではなく、膨大な数値の組み合わせ全体として、言葉のパターンや知識が分散して保持されています。 だからこそ、中身を人間が読んで解釈するのが難しい(ブラックボックス)という課題があります。
Q. パラメータ数は人間の脳と比較できますか?
A.人間の脳のシナプス数(百兆規模)とパラメータ数を並べる記事がありますが、仕組みが違うため、数の比較に大きな意味はありません。 「脳に追いついた」系の見出しは、演出として読むのが安全です。
Q. パラメータ数と学習データ量はどちらが大事ですか?
A.両方が揃って初めて性能が出ます。 パラメータが多くてもデータが足りなければ学び切れず、データが多くてもパラメータが少なければ受け止め切れません。 研究では、規模に対する最適なデータ量のバランスが検討されており、「巨大なモデルより、適切な量のデータで鍛えた中型モデルのほうが強い」という結果が、小型高性能化の流れを後押ししました。
Q. 「モデルパラメーター」と「ハイパーパラメーター」は何が違いますか?
A. モデルパラメーターは、学習によって自動で決まるモデル内部の数値(重みとバイアス)です。ハイパーパラメーターは、学習を始める前に開発者が決める設定値で、学習率が代表例です。「〇億パラメータ」と数えられるのは前者だけです。
Q. パラメータとプロンプトの設定は関係ありますか?
A. 別物です。パラメータは学習で決まるモデル内部の数値で、利用者は変更できません。利用者が調整できるのは指示文と、一部サービスで提供される応答の設定です。
指示文についてはプロンプトとはを参照してください。
Q. パラメータ数が多いモデルほど誤りが少ないのですか。
A. 傾向としては減りますが、なくなりません。事実でないことをもっともらしく答える性質は、規模とは別の理由で残ります。
ハルシネーションとはで扱っています。
まとめ
パラメータとは、モデル内部にある学習で調整される数値のことで、その数はモデルの規模を示す伝統的な目安です。 ただし近年は、小型高性能化と非公開化が進み、「パラメータ数が多い=賢い」という読み方は通用しなくなりました。
「〇億パラメータ」という数字を見たら、性能の証明ではなく、モデルのサイズ帯(どこで動き、いくらかかるか)を示す情報として受け取ってください。
用語の全体像はAI用語30選から確認できます。
※モデルの規模と公開方針は変わりやすい領域です。記述は執筆時点の情報です。
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
参考
2026年10月13日に確認しました。
- Google for Developers「機械学習の用語集」(パラメータ、ハイパーパラメータの項)
- Google AI for Developers「プロンプト戦略」(Gemini API) https://ai.google.dev/gemini-api/docs/prompting-strategies