AI生成コンテンツと検索順位の議論で、必ず登場する言葉です。
経験、専門性、権威性、信頼性の頭文字を取ったもので、Googleが検索品質を評価する際の考え方として示しています。
この記事では、E-E-A-Tの説明を5つのレベルに分けて並べました。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(8分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(9分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(9分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で読み終えられます。
30秒で腕試し
理解度から自分のレベルを判断したい場合は、次の3問に答えてください。
答えられなくなったところが、あなたのスタート地点です。
Q1. E-E-A-Tの4つが何の頭文字か答えられますか
→ 詰まったら Level 1から
Q2. 個人サイトで現実的に強められる要素はどれか答えられますか
→ 詰まったら Level 3から
Q3. 組織として担保すべき編集体制の項目を挙げられますか
→ 詰まったら Level 4から
→ 3問とも答えられるなら Level 5から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
ハルシネーションという言葉があやふやな場合は、先にこちらを読んでください。
→ ハルシネーションとは|5段階でわかる用語解説
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:「誰が書いたか」で情報の信頼度が変わると説明できる
同じことを言っても、誰が言うかで違う
「この魚は釣りやすいよ」と言われたとします。
言ったのが、毎週釣りに行っている人だったら、信じられそうです。
言ったのが、釣りをしたことがない人だったら、少し疑いたくなります。
同じことを言っていても、誰が言うかで信じ方が変わります。
これは、インターネットの情報でも同じです。
4つの見方
Googleは、ウェブページを評価するときに、4つのことを見ると説明しています。
- 経験:実際にやったことがあるか
- 専門性:その分野に詳しいか
- 権威性:その分野で認められているか
- 信頼性:全体として信じられるか
この4つの英語の頭文字を並べて、E-E-A-Tといいます。
なぜ大事なのか
インターネットには、たくさんの情報があります。
その中には、間違った情報もあります。
特に、健康やお金の話で間違った情報を信じると、大変なことになります。
だから、信じられる情報を上に出そうとしているのです。
自分が調べるときにも使える
これは、検索する側にも使える見方です。
- 誰が書いたか書いてあるか
- その人はその分野の人か
- 実際に体験した話か、聞いた話か
- いつ書かれたか
この4つを見るだけで、情報の信じ方が変わります。
つまずきポイント
「点数が付くの?」
点数が付いて、それで順位が決まるわけではありません。
E-E-A-Tは、評価するときの考え方であって、計算される数値ではありません。
理解度チェック
Q1. E-E-A-Tの4つは何ですか?
経験、専門性、権威性、信頼性です。
Q2. なぜ「誰が書いたか」が大事なのですか?
間違った情報を信じると、特に健康やお金の話では大変なことになるためです。
Q3. E-E-A-Tは点数として計算されますか?
されません。評価するときの考え方であって、計算される数値ではありません。
ここまで読めば言えるようになること
- 4つの要素を挙げられる
- 誰が書いたかで信頼度が変わると説明できる
- 自分が調べるときの見方として使える
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(誰が書いたかで信頼度が変わること、4つの見方)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:4つの要素の違いを説明でき、特に信頼性が中心だと言える
4つの中身
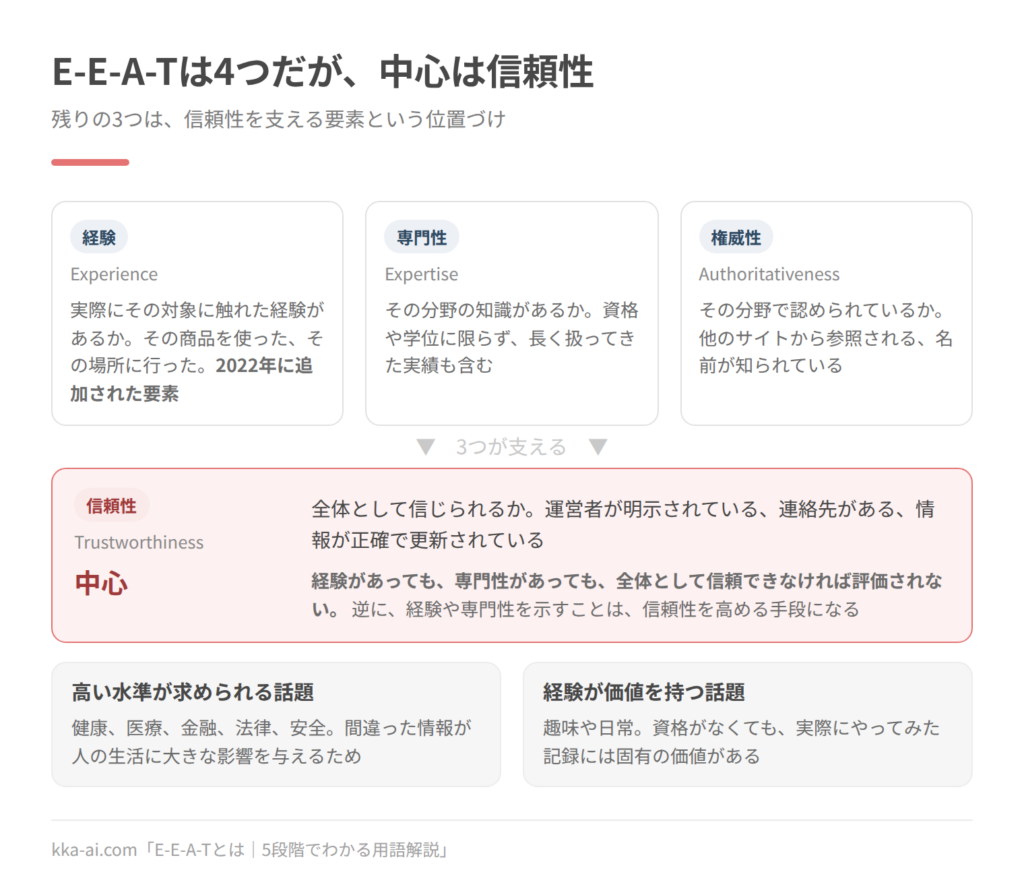
経験(Experience)は、実際にその対象に触れた経験があるかです。
その商品を実際に使った、その場所に実際に行った、その病気を実際に経験した。
2022年に追加された要素で、体験に基づく情報の価値が認められた形です。
専門性(Expertise)は、その分野の知識があるかです。
資格や学位に限らず、その分野を長く扱ってきた実績も含まれます。
権威性(Authoritativeness)は、その分野で認められているかです。
他のサイトから参照される、その分野で名前が知られている、といった外部からの評価です。
信頼性(Trustworthiness)は、全体として信じられるかです。
運営者が明示されている、連絡先がある、情報が正確で更新されている、といった要素です。
信頼性が中心
Googleの説明では、この4つのうち信頼性が中心に置かれています。
残りの3つは、信頼性を支える要素という位置づけです。
つまり、経験があっても、専門性があっても、全体として信頼できなければ評価されません。
逆に、経験や専門性を示すことは、信頼性を高める手段になります。
話題によって重みが違う
すべての話題で同じ厳しさが求められるわけではありません。
健康、医療、金融、法律、安全に関わる話題では、特に高い水準が求められます。
これらは、間違った情報が人の生活に大きな影響を与えるためです。
一方、趣味や日常の話題では、経験に基づく個人の記録が価値を持ちます。
資格がなくても、実際にやってみた記録には固有の価値があります。
AI生成コンテンツとの関係
Googleは、コンテンツの作り方(人が書いたかAIが書いたか)ではなく、内容の質で評価すると説明しています。
自動生成であっても、有用で信頼できる内容であれば評価されるという立場です。
一方、検索順位の操作を主な目的とした自動生成は、方針に反するものとして扱われます。
この2つは矛盾しません。
判断の基準は「誰が書いたか」ではなく「読む人の役に立つために作られたか」に置かれています。
つまずきポイント
「E-E-A-Tを高めれば順位が上がる?」
直接そうなるわけではありません。
E-E-A-Tは、評価する際の考え方を示したものです。
検索順位を決める仕組みは別にあり、その仕組みがこの考え方を反映するように作られている、という関係になります。
理解度チェック
Q1. E-E-A-Tの4つのうち、中心に置かれているのはどれですか?
信頼性です。残りの3つは信頼性を支える要素という位置づけです。
Q2. 特に高い水準が求められる話題は?
健康、医療、金融、法律、安全に関わる話題です。
Q3. AIが書いた記事は評価されませんか?
作り方ではなく内容の質で評価されるとされています。ただし検索順位の操作を主目的とした自動生成は方針に反するものとして扱われます。
ここまで読めば言えるようになること
- 4つの要素の中身を説明できる
- 信頼性が中心だと説明できる
- 話題による重みの違いを説明できる
- AI生成との関係を説明できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(4要素の中身、信頼性が中心であること、AI生成との関係)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:自サイトでE-E-A-Tを示す具体的な方法を選べる
何をすれば示せるのか
E-E-A-Tは、思っているだけでは伝わりません。
ページの中に、確認できる形で置く必要があります。
経験を示す方法です。
- 実際に使った、行った、試した記録を書く
- 自分で撮影した写真を使う
- 具体的な日付、金額、数値、失敗した内容を書く
- 想定と違った点、期待外れだった点を書く
最後が効果があります。
良いことだけが書かれた記事は、実際に使っていなくても書けます。
うまくいかなかった具体的な記述は、体験がないと書けません。
専門性を示す方法です。
- 運営者の経歴や、その分野での実績を示す
- 一つの分野に絞ってサイトを構成する
- 用語を正確に使い、根拠を示す
権威性を示す方法です。
- 一次情報(公的機関、公式サイト)へのリンクを置く
- 引用される、紹介される実績を積む
信頼性を示す方法です。
- 運営者情報、問い合わせ先、プライバシーポリシーを置く
- 情報の出典を明示する
- 更新日を明示し、古い情報を更新する
- 誤りが判明した場合、訂正を明示する
個人サイトで現実的なもの
企業サイトと個人サイトでは、取れる手段が違います。
個人が現実的に強められるのは、経験と信頼性です。
権威性は、外部からの評価であるため、短期間では作れません。
専門性も、資格や経歴に依存する部分があります。
一方、経験は、実際にやった記録を書くことで示せます。
そして、実体験に基づく具体的な記述は、他のサイトが真似できない差別化になります。
信頼性も、運営者情報の明示、出典の記載、更新の管理といった作業で改善できます。
やってはいけないこと
次は、逆効果になります。
- 実際には使っていない商品の使用感を書く
- 資格や経歴を実際より大きく書く
- 出典を示さずに数値を書く
- 情報を更新せずに放置する
- 誤りの指摘を受けても訂正しない
特に1つ目は、信頼性を根本から損ないます。
体験していないものについては、体験していない前提で書く(調べた結果としてまとめる)ほうが安全です。
生成AIを使う場合
記事の作成に生成AIを使う場合、次の工程が要ります。
- 事実関係を一次情報で確認する
- 数値、固有名詞、日付、引用を個別に検証する
- 自分の体験に基づく部分を、自分で書く
- 出典を明示する
生成AIは、もっともらしい文章を作りますが、事実性を保証しません。
確認の工程を省くと、誤った情報を含む記事ができます。
→ ハルシネーションとは|5段階でわかる用語解説
体験の部分をAIに書かせると、具体性が失われます。
数値、日付、失敗した内容といった、体験でしか書けない部分は自分で書くほうが結果的に価値が出ます。
つまずきポイント
「記事を大量に作れば評価される?」
量だけでは評価されません。
むしろ、確認されていない記事が増えると、サイト全体の信頼性が下がる可能性があります。
確認の工程を回せる範囲に、作成の量を合わせるほうが安全です。
理解度チェック
Q1. 経験を示すうえで最も効果がある書き方は?
想定と違った点や、うまくいかなかった具体的な記述です。体験がないと書けない内容だからです。Q2. 個人サイトで現実的に強められる要素は?
経験と信頼性です。権威性は外部からの評価であり、短期間では作れません。Q3. 生成AIを使う場合に必要な工程を4つ挙げてください。
事実関係の一次情報での確認、数値や固有名詞の個別検証、体験部分を自分で書くこと、出典の明示です。Q4. 記事を大量に作ることのリスクは?
確認されていない記事が増えると、サイト全体の信頼性が下がる可能性があることです。ここまで読めば言えるようになること
- 4要素それぞれの示し方を挙げられる
- 個人サイトで注力すべき要素を選べる
- 逆効果になる行為を避けられる
- 生成AI利用時の工程を設計できる
仕事で判断する立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(4要素の示し方、個人サイトで注力すべき要素)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:組織としてE-E-A-Tを担保する編集体制を作れる
体制で担保する
個人の心がけではなく、工程として組み込みます。
執筆者の明示を必須にします。
記名記事にし、執筆者のプロフィールと、その分野での経歴を示します。
外部ライターの場合も、実名または一貫した筆名と経歴を示します。
監修の仕組みを設けます。
専門性が求められる分野では、有資格者や実務者による確認を工程に入れ、監修者を明示します。
形だけの監修は、信頼性を損なうため避けます。
出典の管理を規定します。
数値と事実には一次情報の出典を付け、二次情報のみを根拠にしない方針を定めます。
更新の管理を仕組みにします。
制度や価格に関する記事は、変更が生じたときに更新される仕組みを持ちます。
更新日を表示し、内容が古い場合は明示します。
訂正の方針を定めます。
誤りが判明した場合の訂正の手順と、訂正履歴の表示方法を決めます。
生成AIを使う場合の工程
生成AIを制作に使う場合、次の工程を明示します。
- 調査:一次情報を人が収集する
- 構成:読者の課題と、答えるべき問いを人が定める
- 執筆:AIを下書きに使ってよい範囲を定める
- 検証:数値、固有名詞、日付、引用を個別に確認する
- 加筆:体験、実測、独自の見解を人が加える
- 監修:必要な分野では専門家が確認する
- 記録:使用したモデル、指示文、確認者を残す
3と5の線引きが要点です。
説明や整理はAIに任せ、体験と判断は人が書く、という分担が現実的です。
表示の方針
AI利用の表示については、次を検討します。
- 表示するかどうか(法令上の一律の義務は日本では定められていませんが、媒体や取引先が求める場合があります)
- 表示する場合の文言と位置
- どの程度の利用から表示するか(下書きに使った場合も含めるか)
方針を定めておくと、問われたときに一貫した説明ができます。
測るもの
E-E-A-Tは直接測れませんが、関連する指標は追えます。
- 記名記事と監修記事の割合
- 一次情報を出典とする記事の割合
- 更新から一定期間を超えた記事の数
- 訂正の件数と、訂正までの日数
- 外部からの参照(被リンク、引用)の推移
これらは、体制が機能しているかの確認に使えます。
検索順位そのものは、多数の要因に左右されるため、体制の評価指標としては不安定です。
つまずきポイント
「監修者を立てたのに評価が変わらない」
監修が形だけになっていないかを確認してください。
名前を借りただけで実際の確認が行われていない場合、内容の質は変わりません。
監修者が何を確認したかを記録し、指摘に基づいて修正した履歴を残す運用にすると、実質が伴います。
理解度チェック
Q1. 組織として担保すべき5項目を挙げてください。
執筆者の明示、監修の仕組み、出典の管理、更新の管理、訂正の方針です。
Q2. 生成AIを使う工程で、人が担うべき部分は?
調査、構成、検証、体験や実測や独自の見解の加筆です。説明や整理はAIに任せられます。
Q3. 体制の評価に検索順位を使うのが不安定なのはなぜですか?
順位は多数の要因に左右されるためです。記名率や出典率などの指標のほうが体制の確認に適します。
Q4. 監修が機能しているかを確認する方法は?
監修者が何を確認したかを記録し、指摘に基づく修正の履歴を残すことです。
ここまで読めば言えるようになること
- 編集体制の5項目を設計できる
- 生成AI利用の工程を定義できる
- 表示の方針を定められる
- 体制の指標を設定できる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:E-E-A-Tの位置づけを正確に理解し、誤解に基づく施策を避ける
位置づけの正確な理解
E-E-A-Tは、検索品質評価ガイドラインに記載された概念です。
このガイドラインは、検索結果の品質を人が評価する際の基準として用いられます。
重要なのは、この評価が個々のページの順位を直接決めるものではないという点です。
評価の結果は、検索の仕組みそのものの改善に用いられるという説明がなされています。
したがって、次の理解が正確です。
- E-E-A-Tは、順位を決める計算式の項目ではない
- 検索の仕組みが、この考え方に沿った結果を返すよう改善されている
- 個々の施策とE-E-A-Tを直接対応づけることはできない
「E-E-A-Tスコア」という概念は存在しません。
話題による水準の違い
人の生活に大きな影響を与えうる話題については、より高い水準が求められるとされています。
医療、金融、法律、安全、重要な購買判断などが該当します。
この区分は、個々のページの内容から判断されるものであり、サイト全体で一律に決まるものではありません。
一般的な話題を扱うサイトの中に、該当する話題のページがある場合、そのページには高い水準が求められます。
経験の要素が追加された経緯
経験の要素は、2022年に追加されました。
それ以前は、専門性、権威性、信頼性の3要素でした。
追加の背景として、専門的な資格を持たない人による実体験の情報にも固有の価値があることが挙げられています。
製品のレビュー、旅行の記録、症状の体験談などが該当します。
実務的には、資格や権威で競合できない領域において、実体験の記述が差別化の手段になることを示しています。
AI生成コンテンツの扱い
Googleは、制作方法ではなく内容の質で評価するという立場を示しています。
自動生成であること自体が方針違反となるわけではありません。
方針に反するとされるのは、検索順位の操作を主な目的として大規模にコンテンツを生成する行為です。
判断の基準は、読者に価値を提供する目的で作られたかどうかに置かれています。
実務上の含意は次の通りです。
- AIの使用を隠す必要はない
- ただし、確認されていない内容を大量に公開することは危険
- 差別化は、AIが生成できない部分(実体験、独自の測定、固有の見解)で行う
誤解に基づく施策
次は、E-E-A-Tの誤解から生じる施策で、効果が期待できないか、逆効果になります。
著者情報の形式的な追加は、実体を伴わなければ意味がありません。
経歴と、その分野での実績が確認できる形になっている必要があります。
構造化データの追加による解決を期待するのも誤りです。
構造化データは情報を機械可読にする手段であり、それ自体が評価を上げるものではありません。
専門用語の増加は、専門性の証明になりません。
むしろ読者の理解を妨げる場合があります。
外部リンクの量を増やすことも、権威性にはつながりません。
権威性は、外部から参照されることであり、外部を参照することではありません。
実務で効果があること
構造的に効果があるのは、次の3点です。
一次情報の参照は、事実の正確性を担保し、同時に出典の明示という信頼性の要素も満たします。
独自の情報の生成は、他が持たない価値を作ります。
自社での測定、実際の運用記録、独自の調査。
これらは、AIも競合も生成できません。
継続的な更新と訂正は、情報の鮮度と、訂正する姿勢の両方を示します。
いずれも、短期間で成果が出るものではありません。
E-E-A-Tに関わる要素は、蓄積によって効果が出てくるという性質を持ちます。
理解度チェック
Q1. E-E-A-Tと検索順位の関係を正確に説明してください。
E-E-A-Tは検索品質評価ガイドラインの概念であり、順位を決める計算式の項目ではありません。評価結果は検索の仕組みそのものの改善に用いられます。
Q2. 経験の要素が追加された背景は何ですか?
専門的な資格を持たない人による実体験の情報にも、固有の価値があることが認められたためです。
Q3. AI生成コンテンツが方針に反するとされるのはどんな場合ですか?
検索順位の操作を主な目的として、大規模にコンテンツを生成する場合です。
Q4. 権威性について、よくある誤解は何ですか?
外部へのリンクを増やすことと混同する誤解です。権威性は外部から参照されることであり、外部を参照することではありません。
ここまで読めば言えるようになること
- E-E-A-Tと順位の関係を正確に説明できる
- 話題による水準の違いを説明できる
- AI生成コンテンツの扱いを説明できる
- 誤解に基づく施策を避けられる
まとめ
E-E-A-Tは、経験、専門性、権威性、信頼性の頭文字で、Googleが検索品質の評価に用いる考え方です。
Level 1では、誰が書いたかで信頼度が変わるという見方。
Level 2では、信頼性を中心とした4つの要素。
Level 3では、自サイトで具体的に示す方法。
Level 4では、編集体制として担保する対象。
Level 5では、順位を決める計算式ではないという正確な位置づけ。
AI生成コンテンツとの関係では、作り方ではなく内容の質が基準になります。
差別化は、AIが生成できない部分(実体験、独自の測定、固有の見解)で行うことになります。
次に読む記事
→ ハルシネーションとは|5段階でわかる用語解説
→ 生成AIの商用利用とは|5段階でわかる用語解説
→ 今さら聞けないAI用語30選
よくある質問(FAQ)
Q. E-E-A-Tとは何ですか?
A. 経験(Experience)、専門性(Expertise)、権威性(Authoritativeness)、信頼性(Trustworthiness)の頭文字で、Googleが検索品質を評価する際の考え方として示しているものです。
Q. E-E-A-Tのスコアはありますか?
A. ありません。順位を決める計算式の項目ではなく、検索品質評価ガイドラインに記載された考え方です。評価の結果は、検索の仕組みそのものの改善に用いられます。
Q. AIが書いた記事は評価されませんか?
A. 制作方法ではなく内容の質で評価されるとされています。ただし、検索順位の操作を主な目的とした大規模な自動生成は、方針に反するものとして扱われます。
Q. 個人ブログでE-E-A-Tを高めるには何をすればよいですか?
A. 経験と信頼性に注力するのが現実的です。実際に使った記録、具体的な数値や失敗の記述、運営者情報と出典の明示、更新の管理が中心になります。
Q. 4つのうち最も重要なのはどれですか?
A. 信頼性です。Googleの説明では信頼性が中心に置かれ、残りの3つはそれを支える要素という位置づけになっています。
用語の全体像はこちらで確認できます。
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
参考
内容は2026年9月11日に以下の資料で確認しました。
- Google「品質評価ガイドラインの最新情報: E-A-T に Experience の E を追加」(2022年12月・日本語) https://developers.google.com/search/blog/2022/12/google-raters-guidelines-e-e-a-t
- Google「有用で信頼性の高い、ユーザーを第一に考えたコンテンツの作成」(日本語) https://developers.google.com/search/docs/fundamentals/creating-helpful-content
- Google「ウェブサイトで生成 AI によるコンテンツを使用するための Google 検索のガイダンス」(日本語) https://developers.google.com/search/docs/fundamentals/using-gen-ai-content
- Google「検索品質評価ガイドライン」本体(英語・PDF) https://static.googleusercontent.com/media/guidelines.raterhub.com/en//searchqualityevaluatorguidelines.pdf