「オープンソースのAIモデルを公開」というニュースを耳にしたことがある人も多いかもしれません。
このオープンソースという用語を、無料で自由に使える、と捉えると誤解が生まれます。
最近は「オープンウェイト」という言葉も、同じような場面で見かけるようになりました。
先に、2つの言葉の違いを書いておきます。
- オープンソース:中身が公開されていて、誰でも使う・調べる・直す・配ることが許されているもの。ソフトならソースコード、AIなら重みに加えて学習データの情報とコードまでが「中身」にあたる
- オープンウェイト:AIのうち、学習してできあがった重み(パラメータ)だけが公開されているもの。学習データや学習の手順は公開されていないことが多い
違いは、何が公開されているかです。
ニュースで「オープンソースのAI」と書かれているものの多くは、正確にはオープンウェイトにあたります。
| クローズド(非公開) | オープンウェイト | オープンソース | |
|---|---|---|---|
| 重み(パラメータ) | 非公開 | 公開 | 公開 |
| 学習データの情報 | 非公開 | 非公開のことが多い | 公開 |
| 学習に使ったコード | 非公開 | 非公開のことが多い | 公開 |
| 自分の環境で動かす | できない | できる | できる |
| 追加で学習させる | 提供元が認める範囲だけ | できる | できる |
| 同じものを一から作り直す | できない | できない | 手順の上ではできる |
本記事では、2つの言葉の意味をさらに詳しく解説するために5つのレベルに分けました。
どこから読むか
本記事ではオープンソースとオープンウェイトを5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(7分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(9分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(10分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(9分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で読み終えられます。
1分で腕試し
理解度から決めたい場合は、次の4問を試してください。
Q1〜Q4は、Level 1〜4の内容に1問ずつ対応しています。
最初にまちがえた問題のLevelが、あなたのスタート地点の目安です。
4問とも正解なら、Level 5から読んでください。
各レベルの終わりにも、4択の理解度チェックがあります。
基本情報技術者試験とITパスポート試験の過去問題も入れています。
モデルという言葉があやふやな場合は、先にこちらを読んでください。
→ AIの「モデル」とは何か|5段階でわかる用語解説
Q1.【オリジナル】「オープンソース」の説明として、最も適切なものはどれか。
- ア 無料で配られているソフトのこと
- イ インターネットにつながなくても動くソフトのこと
- ウ 中身(ソースコード)が公開されていて、使う、直す、配ることが許されているソフトのこと
- エ 大きな会社が作ったソフトのこと
正解:ウ
解説:
オープンソースの中心は、中身が公開されていて、使う、直す、配ることが許されていることです。
アは、よくある取り違えです。無料でも中身が見られないソフトは、オープンソースではありません。
イとエは、オープンソースかどうかとは関係がありません。
→ まちがえたら Level 1から
Q2.【オリジナル】ニュースで「オープンソースのAIモデル」と書かれているものの多くは、実際にはどの段階にあたるか。
- ア 重み、学習データの情報、コードのすべてが公開されている
- イ 重みは公開されているが、学習データや学習の手順は公開されていないことが多い(オープンウェイト)
- ウ 重みも学習データの情報も、何も公開されていない
- エ チャット画面だけが、無料で公開されている
正解:イ
解説:
重みだけを公開している段階を、オープンウェイトと呼びます。
ニュースで「オープンソース」と書かれるAIの多くは、実際にはこの段階です。
ウはクローズド(非公開)、アは本来の意味でのオープンソースです。
エは、公開の程度の話ではありません。
→ まちがえたら Level 2から
Q3.【オリジナル】公開されたモデルを自社の環境で動かすことについて、最も適切な説明はどれか。
- ア 自社に置けば、情報漏洩の心配はまったくなくなる
- イ 外部へ送る経路はなくなるが、社内の権限管理や機器の管理という責任が自社に移る
- ウ 自社に置いたモデルは、自動で新しい版に更新される
- エ 自社に置くと、外部のAPIよりも必ず性能が高くなる
正解:イ
解説:
入力が外部のサービスに送られなくなる一方で、権限管理、機器の物理的な管理、記録の扱いは自社の責任になります。
漏洩の心配が消えるのではなく、責任の置き場所が自社に移る、という理解が正確です。
エは誤りです。最高水準の性能に届かない場合があります。
ウは逆です。自社のモデルは、自分が更新しない限り変わりません。
→ まちがえたら Level 3から
Q4.【オリジナル】処理量がまだ小さい段階で、公開モデルの自社運用とAPIの利用を比べた。費用についての説明として、最も適切なものはどれか。
- ア APIは定額制なので、どれだけ使っても費用は変わらない
- イ GPU、運用の人件費、予備を含めると、処理量が小さいうちはAPIのほうが安いことがほとんど
- ウ 費用はどちらも同じなので、比べる必要はない
- エ ライセンス料がゼロなので、自社運用のほうが必ず安い
正解:イ
解説:
ライセンス料がゼロでも、総費用はゼロではありません。
自社運用が有利になるのは、処理量が安定して大きい場合です。
エは、総費用ではなくライセンス料だけを見ています。
アは誤りです。APIは従量課金が基本です。
→ まちがえたら Level 4から
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:オープンソースを「作り方が公開されていて、誰でも使ったり直したりできるもの」、オープンウェイトを「できあがりだけが配られているもの」だと言える
レシピが公開されている料理
理解しやすくするために料理のレシピに例えて解説します。
有名なお店の料理は、作り方が秘密です。
食べに行くことはできますが、家では作れません。
一方、レシピが公開されている料理なら、材料をそろえれば家でも作れます。
自分好みに味を変えて、友だちにレシピを教えることもできます。
コンピュータのソフトにも、この2種類があります。
ソフトの「レシピ」にあたるのが、ソースコード(プログラムの設計図)です。
- ソースコードが秘密のソフト:使うことはできるが、中身は見られない
- ソースコードが公開されていて、誰でも使ったり直したり配ったりしてよいソフト
後者をオープンソースと呼びます。
身の回りにもたくさんある
オープンソースのソフトは、実は身の回りにたくさんあります。
スマホやパソコン、ウェブサイトの裏側でも、たくさん使われています。
大勢の人が中身を見て、直して、よくしていく。
これがオープンソースの考え方です。
AIにも「中身を公開する」ものがある
AIにも、中身を公開しているものがあります。
- 中身が公開されていないAI:サービスとして使うことはできるが、持ち帰れない
- 中身が公開されているAI:自分のパソコンにダウンロードして動かせる
中身が公開されているAIは、インターネットにつながなくても使えます。
自分のパソコンの中だけで動くので、書いた内容が外に出ていきません。
ただし動かすには性能のよいパソコンが必要で、準備も簡単ではありません。
「できあがり」だけを配るAIもある
ただ、AIの「公開」は、料理のレシピの公開とは少し違います。
いま「中身が公開されている」と言われているAIの多くは、レシピを公開しているのではありません。
料理でいえば、できあがった料理を冷凍して配っているようなものです。
家で温めて食べられますし、味を足すこともできます。
でも、どんな材料をどこから仕入れて、どんな手順で作ったのかは分かりません。
AIでは、この「できあがり」にあたるものを重み(ウェイト)と呼びます。
重みだけを配るやり方を、オープンウェイトと呼びます。
レシピも材料の仕入れ先も手順も公開するのが、本来の意味のオープンソースです。
つまずきポイント
「オープンソースって、無料っていう意味?」
同じではありません。
オープンソースの中心は「中身が公開されていて、使う、直す、配ることが許されている」ことです。
無料で配られていても中身が見られないソフトは、オープンソースではありません。
また、AIの場合は「公開されているけれど、使い方に条件が付いている」ものも多くあります。
理解度チェック
Q1.【オリジナル】ソフトを料理にたとえたとき、ソースコードにあたるものはどれか。
- ア 料理を食べる人
- イ 料理の値段
- ウ 料理のレシピ(作り方)
- エ 料理を出すお店の看板
正解:ウ
解説:
ソースコードは、プログラムの設計図で、料理でいえばレシピにあたります。
レシピが公開されていれば、家でも作れて、味を変えて、人に教えることもできます。
ア、イ、エは、作り方そのものではありません。
→ 「レシピが公開されている料理」に戻る
Q2.【オリジナル】次のうち、オープンソースにあたるソフトはどれか。
- ア ソースコードが公開されていて、誰でも使ったり直したり配ったりしてよいソフト
- イ 会社の中だけで使われている、秘密のソフト
- ウ お金を払えば使えるが、中身は秘密のソフト
- エ 無料で配られているが、中身は見られないソフト
正解:ア
解説:
オープンソースは、ソースコードが公開されていて、使う、直す、配ることが許されているソフトです。
エは無料ですが、中身が見られないのでオープンソースではありません。
イとウは、中身が秘密のソフトです。
→ 「レシピが公開されている料理」に戻る
Q3.【オリジナル】AIを料理にたとえたとき、「オープンウェイト」にあたるものはどれか。
- ア できあがった料理が配られ、家で温めたり味を足したりできるが、材料の仕入れ先と作り方は分からない
- イ レシピも、材料の仕入れ先も、作り方の手順も、すべて公開されている
- ウ お店で食べることはできるが、持ち帰りはできない
- エ 料理の写真だけが公開されている
正解:ア
解説:
オープンウェイトは、できあがりにあたる重みだけを配るやり方です。
手元で動かしたり、追加で学習させたりはできますが、何から学び、どう作ったのかは分かりません。
イは、本来の意味でのオープンソースです。
ウは、中身が公開されていないAIにあたります。
エは、中身の公開ではありません。
→ 「「できあがり」だけを配るAIもある」に戻る
Q4.【オリジナル】中身が公開されているAIを、自分のパソコンにダウンロードして動かすよいところはどれか。
- ア いつでも、いちばん新しい知識で答えてくれる
- イ 準備が何もいらない
- ウ 書いた内容が外に出ていかない
- エ どんなパソコンでも、すぐに速く動く
正解:ウ
解説:
自分のパソコンの中だけで動くので、インターネットにつながなくても使え、書いた内容が外に出ていきません。
イとエは逆です。動かすには性能のよいパソコンが要り、準備も簡単ではありません。
アは誤りです。ダウンロードしたAIは、自分で入れ替えない限り新しくなりません。
→ 「AIにも「中身を公開する」ものがある」に戻る
Q5.【オリジナル】「オープンソース」と「無料」の関係について、正しいものはどれか。
- ア 無料で配られていても、中身が見られなければオープンソースではない
- イ オープンソースと無料は、まったく同じ意味である
- ウ お金を払うソフトは、すべてオープンソースである
- エ オープンソースのAIは、どれも使い方に条件がない
正解:ア
解説:
オープンソースの中心は、無料かどうかではなく、中身が公開されていて、使う、直す、配ることが許されていることです。
イは、よくある取り違えです。
ウは、お金を払うかどうかとオープンソースかどうかを混ぜています。
エは誤りです。AIの場合は、公開されていても使い方に条件が付いているものが多くあります。
→ 「つまずきポイント」に戻る
ここまで読めば言えるようになること
- オープンソースをレシピのたとえで説明できる
- オープンウェイトを「できあがりだけを配る」たとえで説明できる
- オープンソースと無料の違いを言える
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(ソースコードの公開、無料との違い、できあがりだけを配るやり方)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:本来の定義を知ったうえで、オープンソースとオープンウェイトの違いを説明し、配布ページで見分けられる
言葉の定義を持っている団体がある
オープンソースは何となく使われている言葉ではありません。
Open Source Initiative(OSI)という団体が「The Open Source Definition」という定義を公開し、10の項目で条件を決めています。
10項目のうち、押さえておきたいのは次の3つです。
- 自由な再配布:ソフトを売ったり配ったりすることを、ライセンスで禁じてはいけない
- ソースコード:プログラムはソースコードを含み、ソースコードのままでも配れなければならない
- 分野による差別の禁止:特定の分野で使うことを、ライセンスで禁じてはいけない
3つ目の「分野による差別の禁止」がとくに重要です。
原文は「The license must not restrict anyone from making use of the program in a specific field of endeavor.」です。
「商用に使ってはいけない」という条件が付いていたら、それは定義の上ではオープンソースではない、ということになります。
オープンソースとオープンウェイトの違い
ところが、AIでは事情が変わります。
AIの「中身」は、ソースコードだけではないからです。
AIモデルの中身は、大きく3つに分かれます。
- 学習してできあがったパラメータ(重み)
- 学習に使ったデータ
- 学習と実行に使ったコード
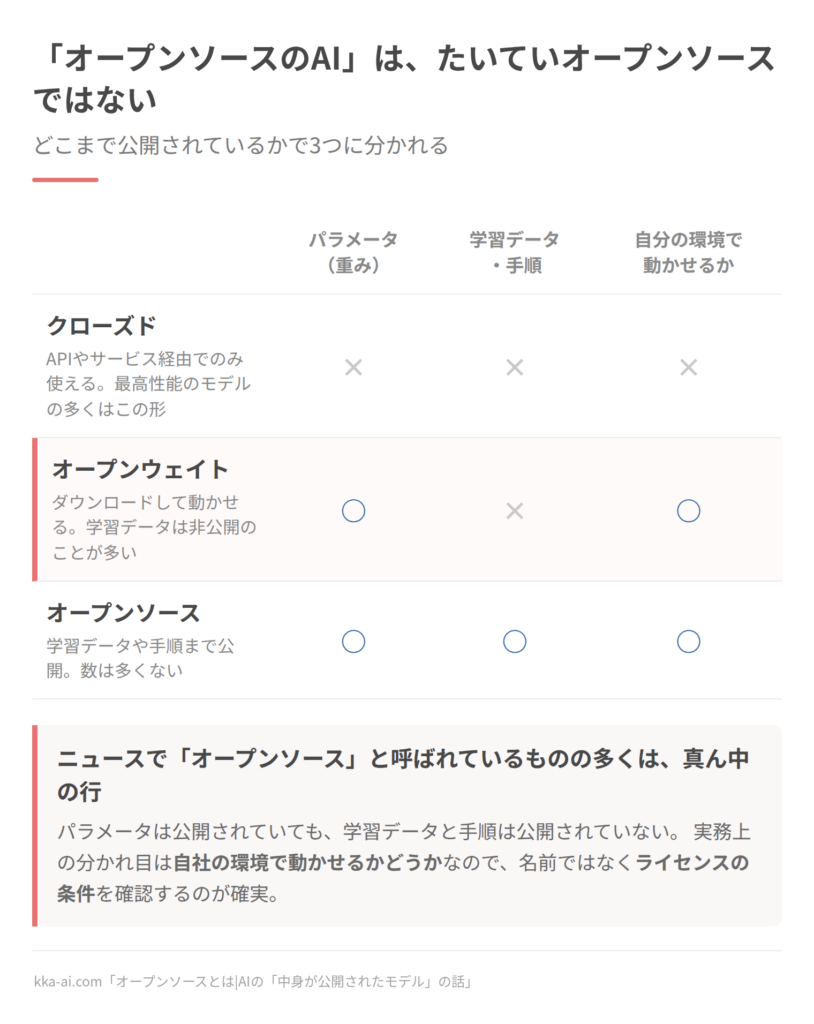
どこまで公開するかで、呼び方が3段階に分かれます。
クローズド(非公開)は、パラメータが公開されずサービスやAPI経由でのみ使えます。
最高性能のモデルの多くがこの形です。
オープンウェイトは、パラメータが公開されダウンロードして動かせます。
ただし、学習データや学習の手順は公開されていないことが多くなります。
オープンソースは、パラメータに加えて学習データの情報や学習の手順まで公開されているものです。
数は多くありません。
ニュースで「オープンソース」と書かれているものは、実際には2番目のオープンウェイトを指していることが多いです。
「ウェイト」は重みのこと
オープンウェイトの「ウェイト(weight)」は、重さではなく重みのことです。
AIは、学習した結果を膨大な数の数値として持っています。
この数値を、重み、またはパラメータと呼びます。
パラメータについては以下の記事でも詳しく解説しています。
→ AIモデルのパラメータとは|「〇億パラメータ」の意味と読み方
重みしか公開されていないものをオープンソースと呼ぶと、学習データやコードまで公開されているように聞こえます。
その状態を正確に言い表すために、オープンウェイトという言葉が使われるようになりました。
「オープンモデル」と書かれることもありますが、指している範囲は記事ごとに違うので、何が公開されているかを本文で確かめましょう。
配布ページで見分ける3つの点
あるモデルがどの段階にあたるかは、配布ページで次の3つを確かめると分かります。
1. 重みのファイルをダウンロードできるか
できなければ、クローズドです。
2. 学習データについて、どこまで書かれているか
「どんなデータを、どれくらい、どこから集めたか」まで書かれているか。
「公開されているデータなどを使った」程度の一文だけなら、情報の公開とは言えません。
3. 学習に使ったコードが公開されているか
動かすためのコードだけなのか、学習させるためのコードまであるのか。
1だけならオープンウェイト、2と3までそろっていればオープンソースに近づきます。
もう1つ、ライセンス(利用条件)の名前も見ておきます。
同じオープンウェイトでも、付いているライセンスで、できることが変わるからです。
読み方はLevel 3で扱います。
なぜ区別が必要か
区別が必要なのは、できることが変わるからです。
オープンウェイトなら、自分の環境で動かせて、追加学習もできます。
実務で必要になるのは、たいていここまでです。
一方、「なぜこの答えが出るのか」を学習データまでさかのぼって調べたい場合や、同じものを一から作り直したい場合には、学習データと手順の公開がいります。
公開する側の事情
企業がモデルを公開する理由は、いくつかあります。
- 多くの人に使われることで、周辺技術や使い方が発展する
- 自社サービスへの入り口となる
- 業界の中での存在感を高められる
一方で、公開しない理由もあります。
開発費用の回収、安全性への懸念、競争上の理由です。
このため、最高性能のモデルは非公開、その一世代前や小さめのモデルは公開、という形が多く見られます。
国の方針にも、この考え方が出てきます。
日本の「AIロボティクス戦略」(令和8年3月26日)は、国産のロボット基盤モデルのベータ版を2027年6月頃を目途に「オープンソースで公開」すると書いています。
土台を共有して、その上で各社が競う、という産業の作り方です。
→ AIロボットとは|5段階でわかる用語解説
つまずきポイント
「オープンウェイトは、オープンソースより劣っている?」
違いは公開の範囲で、性能の違いではありません。
手元で動かす、追加で学習させる、という実務で必要なことの多くは、オープンウェイトでできます。
「オープンなモデルは性能が低い?」
一概には言えません。
最高性能のモデルが非公開であることが多いのは事実ですが、公開されたモデルの性能も上がり続けています。
用途によっては、公開されたモデルで十分なことが多くあります。
理解度チェック
Q1.【IPA過去問】OSIによるオープンソースソフトウェアの定義に従うときのオープンソースソフトウェアに対する取扱いとして,適切なものはどれか。
- ア ある特定の業界向けに作成されたオープンソースソフトウェアは,ソースコードを公開する範囲をその業界に限定することができる。
- イ オープンソースソフトウェアを改変して再配布する場合,元のソフトウェアと同じ配布条件となるように,同じライセンスを適用して配布する必要がある。
- ウ オープンソースソフトウェアを第三者が製品として再配布する場合,オープンソースソフトウェアの開発者は第三者に対してライセンス費を請求することができる。
- エ 社内での利用などのようにオープンソースソフトウェアを改変しても再配布しない場合,改変部分のソースコードを公開しなくてもよい。
出典:平成31年度 春期 基本情報技術者試験 午前 問20
正解:エ
解説:
OSIの定義が定めているのは、配布するときの条件です。再配布しないなら、改変部分のソースコードを公開する義務は生じません。
アは、特定の分野や人を差別してはいけないという条件に反します。
イの「同じライセンスで配布する」は、コピーレフトと呼ばれる一部のライセンスの条件で、OSIの定義がすべてのオープンソースに求めるものではありません。
ウは、自由な再配布の条件に反します。定義は、再配布に対して使用料などを求めることを認めていません。
→ 「言葉の定義を持っている団体がある」に戻る
Q2.【オリジナル】AIモデルの「中身」として、この記事で挙げた3つに含まれないものはどれか。
- ア 学習に使ったデータ
- イ 学習と実行に使ったコード
- ウ 学習してできあがったパラメータ(重み)
- エ そのAIを紹介する広告
正解:エ
解説:
AIモデルの中身は、パラメータ、データ、コードの3つに分かれます。
どこまで公開するかで、クローズド、オープンウェイト、オープンソースの3段階に分かれます。
エは、モデルの中身ではありません。
→ 「オープンソースとオープンウェイトの違い」に戻る
Q3.【オリジナル】「オープンウェイト」の説明として、最も適切なものはどれか。
- ア パラメータが公開され、ダウンロードして動かせるが、学習データや学習の手順は公開されていないことが多い
- イ 重さ(ファイルの大きさ)が軽いモデルのこと
- ウ パラメータに加えて、学習データの情報や学習の手順まで公開されている
- エ パラメータは公開されず、サービスやAPI経由でのみ使える
正解:ア
解説:
オープンウェイトは、パラメータ(重み)を公開している段階です。
エはクローズド、ウは本来の意味でのオープンソースです。
イは誤りです。「ウェイト」は重さではなく、パラメータ(重み)のことです。
→ 「「ウェイト」は重みのこと」に戻る
Q4.【オリジナル】オープンウェイトでは足りず、学習データと手順の公開まで必要になるのは、どんな場合か。
- ア 「なぜこの答えが出るのか」を、学習データまでさかのぼって調べたい場合
- イ チャット画面から質問したい場合
- ウ 追加学習をしたい場合
- エ 自分の環境でモデルを動かしたい場合
正解:ア
解説:
答えの理由を学習データまでさかのぼって調べたり、同じものを一から作り直したりするには、学習データと手順の公開が要ります。
ウとエは、オープンウェイトでもできます。実務で必要になるのは、たいていここまでです。
イは、公開されていないモデルでもできます。
→ 「なぜ区別が要るのか」に戻る
Q5.【オリジナル】日本の「AIロボティクス戦略」(令和8年3月26日)は、国産のロボット基盤モデルのベータ版を、2027年6月頃を目途にオープンソースで公開するとしている。この考え方として、最も適切なものはどれか。
- ア ロボットの開発をやめて、ソフトウェアだけにする
- イ 土台を共有して、その上で各社が競う
- ウ 1社だけがモデルを独占して使う
- エ モデルの中身を秘密にして、海外に売る
正解:イ
解説:
土台になるモデルを公開して共有し、その上で各社が製品やサービスで競う、という産業の作り方です。
企業がモデルを公開するのも、周辺の技術や使い方が育つことや、自社サービスへの入り口になることが理由です。
アは、公開とは関係のない話です。
ウとエは、公開とは反対の考え方です。
→ 「公開する側の事情」に戻る
ここまで読めば言えるようになること
- オープンソースの定義を持つ団体と、主な条件を挙げられる
- オープンソースとオープンウェイトの違いを、公開の範囲で説明できる
- 配布ページで、どの段階のモデルかを見分けられる
- 公開する側の事情を説明できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(OSIの定義、公開の程度の3段階、配布ページでの見分け方)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:AI向けの定義とライセンスの読み方を知り、オープンウェイトの条件の幅と、自社環境で動かす条件を判断できる
AI向けの定義ができた
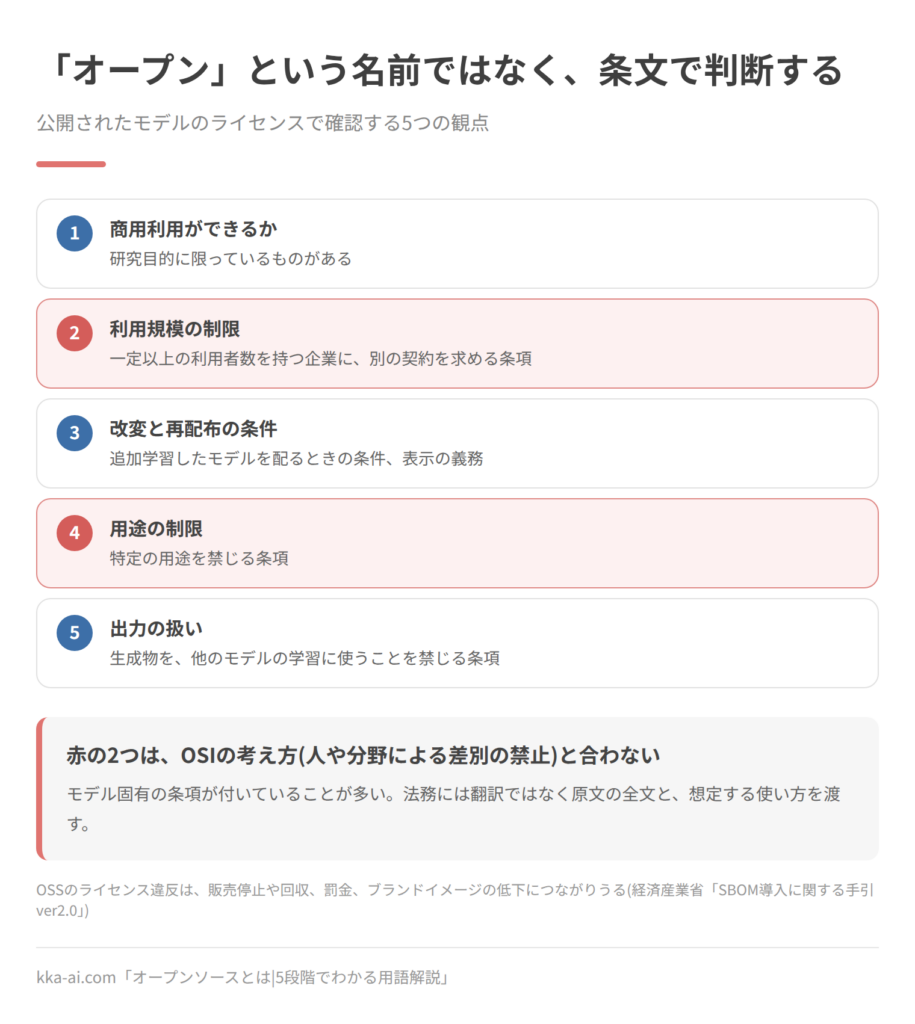
ソフトウェアの定義をそのままAIに当てはめると、「データはどうするのか」が決定しません。
そこでOSIは、2024年10月28日に「The Open Source AI Definition」(OSAID)1.0を公開しました。
OSAIDは、AIシステムについて以下の4つの自由を求めています。
- 使う(Use):許可を求めずに、どんな目的にも使える
- 調べる(Study):仕組みを調べ、構成要素を点検できる
- 直す(Modify):出力を変えることも含め、どんな目的にも改変できる
- 配る(Share):改変してもしなくても、他人が使えるように配れる
そして、改変に必要なものとして次の3つの公開を求めています。
- データの情報:熟練した人が実質的に同等のシステムを作れるだけの、学習データについての詳しい情報
- コード:システムの学習と実行に使った完全なソースコード
- パラメータ:重みなどのモデルのパラメータ
多くの公開モデルは3番目のパラメータだけを公開しています。
なので、この定義に照らすと「オープンソース」とは呼べず、「オープンウェイト」と呼ぶほうが正確です。
一方で、学習データや、追加学習に使ったデータまで公開するモデルも、研究機関を中心に出てきています。
同じ「公開」でも、3つのうちどこまで出しているかは、モデルごとに確かめる必要があります。
ライセンスを理解する5つの観点
公開されたモデルには、ライセンス(利用条件)が付いています。
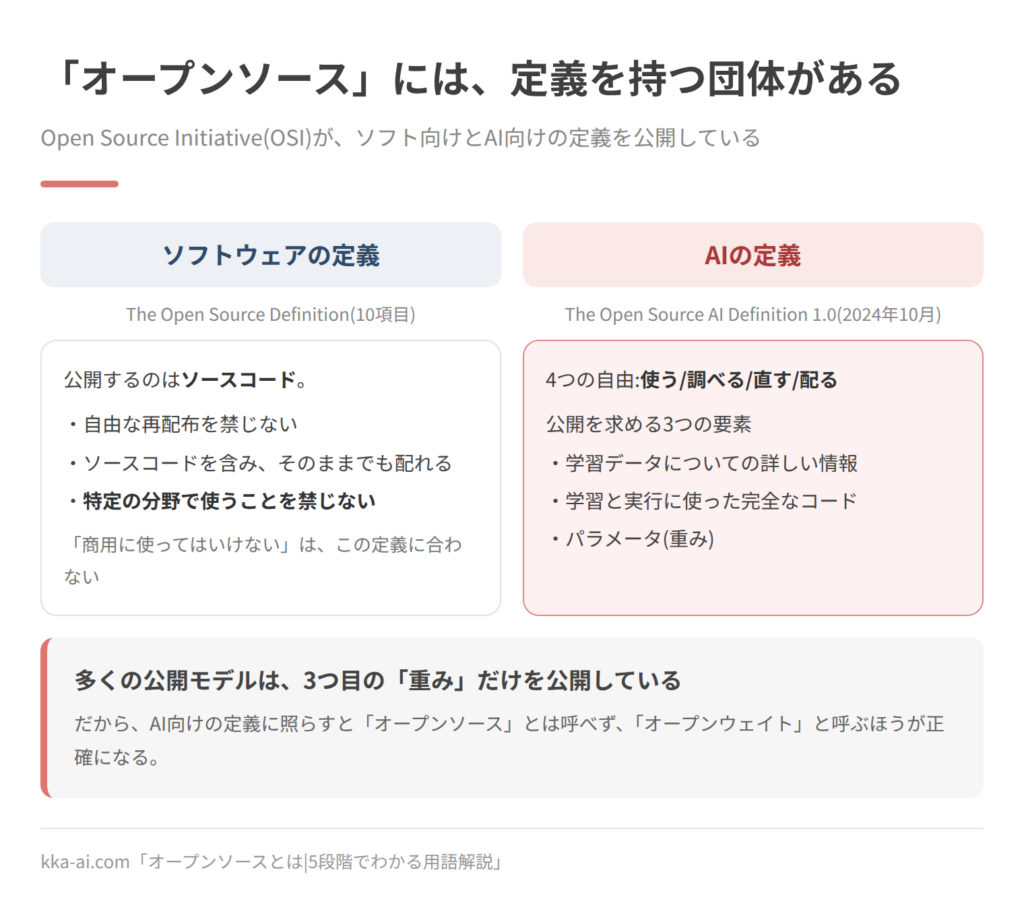
確認するのは次の5つです。
1. 商用利用ができるか
研究目的に限っているものがあります。
2. 利用規模の制限
一定以上の利用者数や売上を持つ企業に、別の契約を求める条項が置かれることがあります。
3. 改変と再配布の条件
追加学習したモデルを配るときの条件や、表示の義務があるか。
4. 用途の制限
特定の用途を禁じる条項が置かれることがあります。
5. 出力の扱い
生成物を、他のモデルの学習に使うことを禁じる条項が置かれることがあります。
2と4の条項があるライセンスは、Level 2で見たOSIの考え方(分野や人による差別の禁止)とは合致しません。
モデル固有の条項が付いていることが多いので、「オープン」という名前ではなく条文で判断します。
オープンウェイトの中にも幅がある
同じオープンウェイトでも付帯するライセンスはさまざまです。
大きく2つに分かれます。
標準的なライセンス
ソフトウェアの世界で長く使われてきたライセンスです。
商用利用を認め、著作権表示やライセンス文の同梱といった、決まった義務だけを求めます。
開発元が独自に作ったライセンス
基本は自由に使えますが、一定の条件を超えると追加の義務がかかります。
置かれる条件には、次のようなものがあります。
- 利用者数や売上が一定を超えるサービスで使うとき、画面にモデル名を表示する
- モデルそのものを外部に提供する事業で、売上が一定を超えたら、別の契約を結ぶ
- 一定の規模を超える事業者は、開発元の審査を受けてから使う
- 派生モデルの名前に、元のモデル名を付ける
多くは大きな規模の事業者だけにかかる条件で、社内だけで使う場合を対象外にしているものもあります。
ただし、どこからが「外部に提供」にあたるかは、条文ごとに書き方が違います。
もう1つ大事なのは、同じ開発元でも、版が変わるとライセンスが変わることがある点です。
標準的なライセンスから独自のライセンスへ移った例も、その逆の例もあります。
前の版の条件で判断せず、使う版の条文を読みます。
個別のモデルの条件は、動向版に時点つきでまとめています。
自社環境で動かす利点
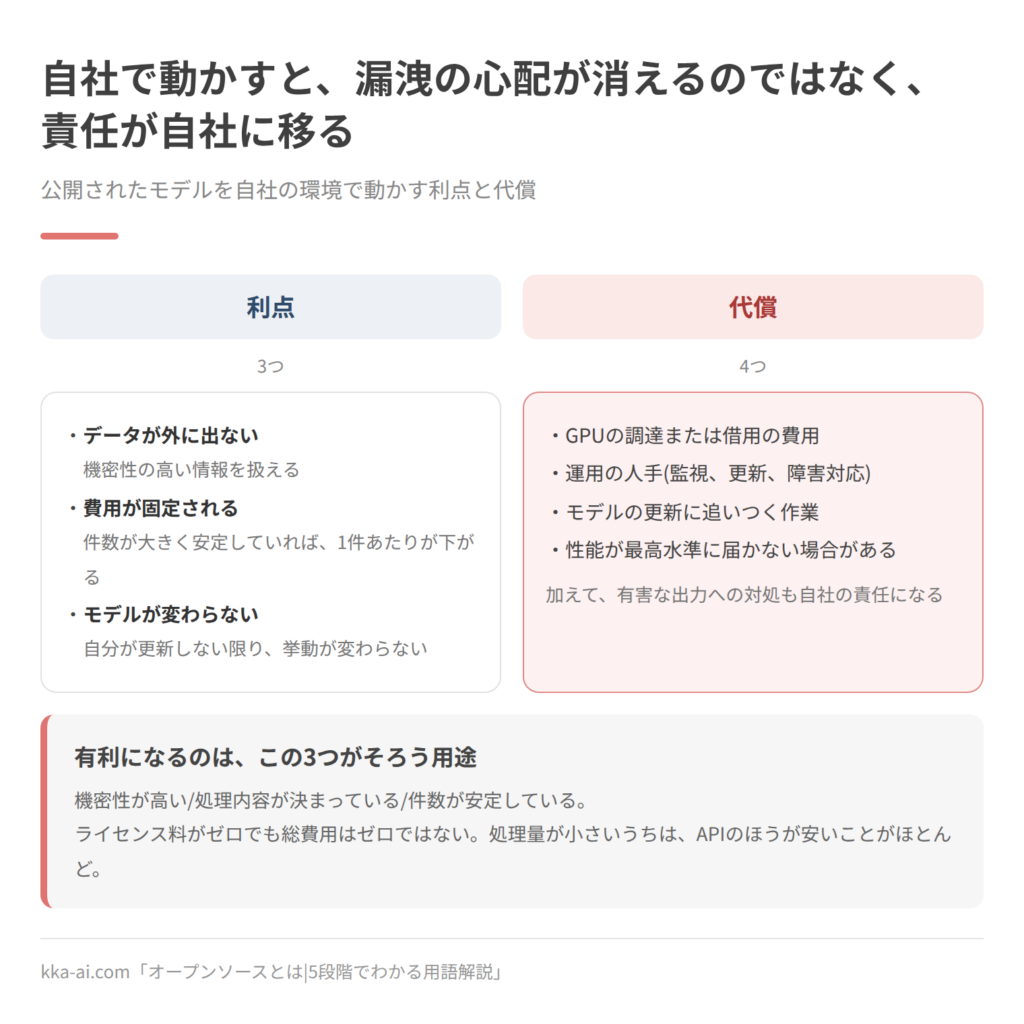
公開されたモデルを自社の環境で動かす利点は3つです。
データが外に出ない
入力が外部のサービスに送られないため、機密性の高い情報を扱えます。
費用が固定される
従量課金ではなく、機器の費用になります。
処理件数が大きく安定している場合、1件あたりの費用が下がります。
モデルが変わらない
外部のAPIは、同じ名前のまま挙動が変わることがあります。
自社に置いたモデルは、自分が更新しない限り変わりません。
出力の再現性が要る用途では、ここが決め手になります。
自社環境で動かす代償
一方、次の負担が生まれます。
- GPUの調達または借用の費用
- 運用の人手(監視、更新、障害対応)
- モデルの更新に追いつく作業
- 性能が最高水準に届かない場合がある
選ぶかどうかは用途で決まります。
機密性が高く、処理内容が決まっていて、件数が安定している用途で有利になります。
手元で動かすの実際
小さなモデルであれば、一般的なパソコンでも動きます。
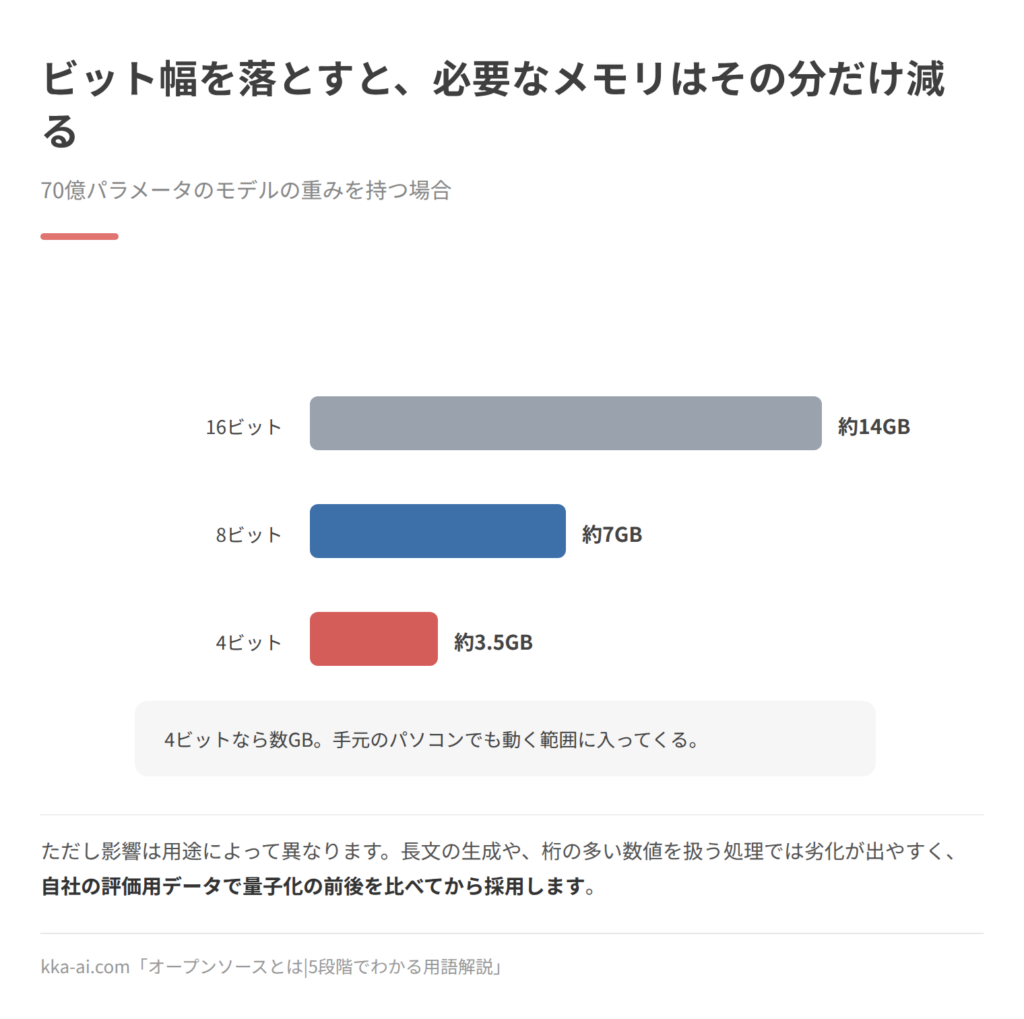
70億パラメータ規模のモデルを4ビットで扱えば、必要なメモリは数GB程度です。
→ AIモデルのパラメータとは|「〇億パラメータ」の意味と読み方
向いているのは、要約、分類、簡単な文章作成など、判断の幅が狭い処理です。
複雑な推論や、専門的な知識が要る処理では、規模の差が出ます。
つまずきポイント
「自社に置けば、情報漏洩の心配はなくなる?」
外部へ送る経路はなくなります。
一方で、社内の権限管理、機器の物理的な管理、記録の扱いという別の責任が生まれます。
漏洩の心配が消えるのではなく、責任の置き場所が自社に移る、という理解が正確です。
理解度チェック
Q1.【オリジナル】OSAIDが公開を求める3つの要素のうち、多くの公開モデルが公開しているのはどれか。
- ア 学習と実行に使った完全なソースコードだけ
- イ 学習データについての詳しい情報だけ
- ウ 3つすべて
- エ パラメータ(重み)だけ
正解:エ
解説:
OSAIDは、データの情報、コード、パラメータの3つの公開を求めています。
多くの公開モデルは、パラメータだけを公開しています。
だから、この定義に照らすと「オープンソース」ではなく、「オープンウェイト」と呼ぶほうが正確です。
ア、イ、ウは、多くの公開モデルの実態とは違います。
→ 「AI向けの定義ができた」に戻る
Q2.【オリジナル】公開モデルのライセンスに「モデルの出力を、他のモデルの学習に使ってはならない」という条項があった。この条項があるとできないことはどれか。
- ア 社内の問い合わせ対応の下書きに使う
- イ 手元のパソコンで動かす
- ウ 社内で、文章の要約に使う
- エ モデルに作らせた文章を、別のモデルを学習させるデータとして使う
正解:エ
解説:
出力の扱いは、ライセンスで確認する5つの観点の1つです。
この条項があれば、学習用のデータを作る目的には使えません。
ア、イ、ウは、この条項だけでは制限されません(ほかの条項は別に確認します)。
→ 「ライセンスを読む5つの観点」に戻る
Q3.【オリジナル】オープンウェイトのモデルに付いているライセンスについて、最も適切な説明はどれか。
- ア 重みが公開されていても、利用者数や売上が一定を超えると、表示や別の契約を求めるライセンスがある
- イ 重みが公開されていれば、条文を読まなくても、どんな使い方も自由にできる
- ウ オープンウェイトのモデルには、すべて同じライセンスが付いている
- エ 一度決まったライセンスは、新しい版が出ても変わらない
正解:ア
解説:
同じオープンウェイトでも、標準的なライセンスと、開発元が独自に作ったライセンスがあります。
独自のライセンスには、規模が一定を超えると追加の義務がかかるものがあります。
イは、名前ではなく条文で判断する、という原則に反します。
ウは誤りです。ライセンスはモデルごとに違います。
エも誤りです。版が変わるとライセンスが変わることがあります。
→ 「オープンウェイトの中にも幅がある」に戻る
Q4.【オリジナル】外部のAPIではなく、公開モデルを自社の環境で動かす利点のうち、「出力の再現性が要る用途」で決め手になるものはどれか。
- ア 最高水準の性能が、必ず手に入る
- イ 処理件数が増えても、費用がゼロになる
- ウ 自分が更新しない限り、モデルが変わらない
- エ GPUがなくても、大きなモデルが速く動く
正解:ウ
解説:
外部のAPIは、同じ名前のまま挙動が変わることがあります。
自社に置いたモデルは、自分が更新しない限り変わらないので、同じ入力に同じような出力を保ちやすくなります。
イは誤りです。機器と運用の費用がかかります。
アとエは、自社運用の代償の側の話で、どちらも保証されません。
→ 「自社環境で動かす利点」に戻る
Q5.【IPA過去問】OSS(Open Source Software)のライセンスにおけるコピーレフトに関する記述として,適切なものはどれか。
- ア OSSの作成者が,ソフトウェアの著作権を放棄している。
- イ OSSの著作権者は,利用者がソフトウェアを利用することに対して金銭的な対価を要求しなければならない。
- ウ OSSの利用者が改変して作成した派生ソフトウェアは,改変部分のソースコードを非公開としたまま,配布することができる。
- エ OSSの利用者が改変して作成した派生ソフトウェアを配布する場合には,元のOSSのライセンスと同じライセンスを適用しなければならない。
出典:令和8年度 ITパスポート試験 公開問題 問73
正解:エ
解説:
コピーレフトは、改変したものを配布するときにも、元と同じ条件(同じライセンス)を引き継がせる考え方です。
ライセンスを読む5つの観点のうち、「改変と再配布の条件」にあたります。
アは誤りです。コピーレフトは、著作権を持ったうえで、その権利を使って条件を引き継がせるしくみです。
イは誤りです。対価を要求しなければならない、という決まりはありません。
ウは、コピーレフトとは逆の扱いです。
→ 「ライセンスを読む5つの観点」に戻る
ここまで読めば言えるようになること
- AI向けの定義(OSAID)の4つの自由と3つの要素を説明できる
- ライセンスの確認観点を挙げられる
- オープンウェイトのライセンスにも幅があることを説明できる
- 自社環境で動かす利点と代償を比べられる
いま公開されている主なオープンウェイトのモデルと、それぞれのライセンスは、動向版に時点つきでまとめています。
→ オープンウェイトの最新動向2026|ライセンスの読み方
仕事で判断する立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(ライセンスの確認観点、オープンウェイトの条件の幅、自社運用の利点と代償)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:オープンウェイトのモデルとオープンソースのソフトを、法務と費用の両面から扱える
個別のモデルとライセンスの現状は、動向版にまとめています。
この節では、モデルが入れ替わっても変わらない判断の順序を扱います。
→ オープンウェイトの最新動向2026|ライセンスの読み方
ソフトのオープンソースはすでに管理対象
AIの前に、まずソフトウェアの話です。
オープンソースのソフトは、ほとんどの会社のシステムにすでに入っています。
経済産業省の「ソフトウェア管理に向けたSBOM(Software Bill of Materials)の導入に関する手引 ver2.0」(令和6年8月29日)は、その状況をこう書いています。
オープンソースソフトウェア(OSS)の利用が一般化する中で、自社製品において利用するソフトウェアであっても、コンポーネントとしてどのようなソフトウェアが含まれているのかを把握することが困難な状況がある。
ライセンスに違反したときの影響も、同じ手引にはっきり書かれています。
OSS のライセンスに違反した場合、ソフトウェアの販売停止や回収、罰金の支払い、企業ブランドイメージの低下等、大きな影響を受ける可能性がある。
対策として挙げられているのがSBOMです。
手引は、SBOMを「ソフトウェアコンポーネントやそれらの依存関係の情報も含めた機械処理可能な一覧リスト」と定義しています。
何が入っているかの一覧を持ち、そこにライセンスの情報も載せる。
公開されたAIモデルも、同じ一覧の対象に入れて管理するのが自然です。
採用判断の順序
公開されたモデルを使うかどうかは、次の順で判断します。
- 要件の確認:機密性、処理件数、応答速度、再現性の要求
- ライセンスの確認:商用利用、規模、用途の制限
- 性能の実測:自社の業務データで、候補を比べる
- 費用の比較:APIの従量課金と、自社運用の総費用を比べる
- 運用体制の確認:誰が監視し、誰が更新するか
3の性能の実測を飛ばして機器の調達に進むと、性能が足りないことが後から分かります。
まず借りた環境で性能を測ってから、調達を判断してください。
法務に渡すもの
ライセンスの確認では、次を法務に渡します。
- ライセンス条文の全文(翻訳ではなく原文)
- 配布ページに併記された利用規約や、禁止用途の方針(ライセンスとは別に置かれていることがある)
- 想定する使い方(社内で使うか、外部に提供するか)
- 改変するかどうか(追加学習をするか)
- 自社の規模(利用者数や売上の条件に関わる)
とくに、追加学習したモデルの位置づけと、生成物の扱いは、条文によって扱いが分かれます。
「モデルの出力を他のモデルの学習に使わない」という条項があれば、学習用のデータを作る目的には使えません。
社内だけで使う場合を対象外にしている条項は、「社内」の範囲(グループ会社、委託先を含むか)も確かめます。
費用の比較
自社運用とAPIを比べるときは、次を含めます。
自社運用の側:
- GPUの調達費用、または時間あたりの借用費用
- 電力と設置の費用(自社に置く場合)
- 運用の人件費
- 止まらないようにするための予備
- モデルの更新に追いつく作業
APIの側:
- トークン単価 × 想定処理量
- 処理量の増減への対応のしやすさ
処理量が安定して大きい場合は自社運用が有利になり、増減が大きい用途ではAPIが有利です。
稼働率と障害時の対応も、費用として見込みます。
供給の安定性
公開されたモデルには、供給の安定性という論点があります。
公開元がライセンスを変えることがあります。
一度ダウンロードしたモデルは手元に残りますが、新しい版の入手や、規約変更後の使い続けは保証されません。
業務の土台にする場合は、使っているモデルとその版を、自社で保管する運用が要ります。
安全性の責任
商用のサービスには、有害な出力を抑える仕組みが組み込まれています。
公開されたモデルにも安全性の調整はされていますが、その水準はモデルによって異なり、追加学習で外れることもあります。
自社で動かす場合、有害な出力への対処は自社の責任です。
入力と出力の検査を、別に組み込む設計が要ります。
公開する側にも責任があります。
AI事業者ガイドライン(第1.2版)は、開発したAIシステムを「オープンソース化にあたっても、社会的な影響を検討する」ことを求めています。
自社で追加学習したモデルを公開する場合は、この立場になります。
つまずきポイント
「無料だから安い、と説明したら通らなかった」
ライセンス料がゼロでも、総費用はゼロではありません。
GPU、運用の人件費、予備を含めた総費用で比べる必要があります。
処理量が小さいうちは、APIのほうが安いことがほとんどです。
理解度チェック
Q1.【オリジナル】経済産業省の手引が定義する「SBOM」の説明として、最も適切なものはどれか。
- ア ソフトウェアの操作方法をまとめた説明書
- イ ソフトウェアの販売価格を記した一覧
- ウ ソフトウェアの部品と、その依存関係の情報を含む、機械で処理できる一覧
- エ ソフトウェアを開発した人の名簿
正解:ウ
解説:
SBOMは、ソフトウェアに何が入っているかの一覧です。
部品ごとのライセンスの情報も載せて管理できるため、違反のリスクを下げられます。
公開されたAIモデルも、同じ一覧の対象に入れて管理するのが自然です。
ア、イ、エは、部品の一覧ではありません。
→ 「ソフトのオープンソースは、すでに管理の対象」に戻る
Q2.【オリジナル】経済産業省の手引が、OSSのライセンスに違反した場合の影響として挙げていないものはどれか。
- ア ソフトウェアの販売停止や回収
- イ 企業ブランドイメージの低下
- ウ 罰金の支払い
- エ ソフトウェアの処理速度の低下
正解:エ
解説:
手引は、販売停止や回収、罰金の支払い、企業ブランドイメージの低下などの大きな影響を挙げています。
エは、ライセンス違反の影響ではありません。
→ 「ソフトのオープンソースは、すでに管理の対象」に戻る
Q3.【オリジナル】公開モデルの採用を検討している。GPUなどの機器を調達する前に、必ずしておくべきことはどれか。
- ア ライセンスの確認を後回しにする
- イ 自社の業務データで性能を実測する
- ウ 社内に、採用が決まったと発表する
- エ いちばん大きなモデルを選ぶ
正解:イ
解説:
借りた環境で、自社の業務データを使って候補を比べてから、調達を判断します。
実測を飛ばして機器の調達に進むと、性能が足りないことが後から分かります。
エは、性能と費用の釣り合いを見ていません。
アは逆です。ライセンスは、性能の実測より前に確認します。
ウは、判断の前に結論を出してしまっています。
→ 「採用判断の順序」に戻る
Q4.【オリジナル】公開モデルを自社で動かす場合の安全性の責任について、最も適切なものはどれか。
- ア 公開されたモデルには安全性の調整がないので、使ってはいけない
- イ 有害な出力への対処は自社の責任になるので、入力と出力の検査を別に組み込む
- ウ 公開元が、すべての有害な出力に責任を持つ
- エ 追加学習をしても、安全性の調整が外れることはない
正解:イ
解説:
商用のサービスには、有害な出力を抑える仕組みが組み込まれています。
公開されたモデルにも調整はされていますが、水準はモデルによって違います。
自社で動かすなら、有害な出力への対処は自社の責任です。
アは言い過ぎです。調整されていても、水準が違うということです。
ウは誤りです。動かしている側の責任になります。
エは誤りです。追加学習で外れることがあります。
→ 「安全性の責任」に戻る
Q5.【オリジナル】公開モデルを業務の土台にする場合の、供給の安定性についての対策として、最も適切なものはどれか。
- ア 使っているモデルとその版を、自社で保管する
- イ 毎回、最新の版を公開元からダウンロードして使う
- ウ ライセンスの条文は、翻訳だけを読めば十分である
- エ 公開元がライセンスを変えることはないので、何もしない
正解:ア
解説:
公開元がライセンスを変えることがあり、新しい版の入手や、規約変更後の使い続けは保証されません。
業務の土台にするなら、使っているモデルと版を自社で保管します。
イでは、版が勝手に変わり、ライセンスも変わることがあります。
ウは誤りです。法務には、翻訳ではなく原文の条文を渡します。
エは誤りです。ライセンスは変わることがあります。
→ 「供給の安定性」に戻る
ここまで読めば言えるようになること
- ソフトのオープンソースが管理の対象になっている理由を説明できる
- 採用判断の順序を組める
- 法務に渡す情報をそろえられる
- 総費用で比べ、供給と安全性の責任を説明できる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:オープンウェイトのモデルを、配布形式から運用まで設計できる
配布形式
オープンウェイトのモデルは、重みと構成をセットとして配布されます。
形式は読み込むときに任意のコードが実行されない、安全なテンソル形式が標準です。
配布物には以下が含まれます。
- 重み(分割されたファイル群)
- 構成の記述(層の数、隠れ次元、注意ヘッドの数など)
- トークナイザの定義と語彙
- 生成の既定の設定
- 対話形式のテンプレート
最後の対話テンプレートは見落とされがちですが重要です。
指示と応答をどの形で並べるかがモデルごとに決まっていて、これを外すと性能が大きく落ちます。
実行環境
実行環境は次の選択肢があります。
汎用のライブラリは、動作の確認や少量の処理に向きます。
まとめて処理する最適化が弱く、本番の同時実行には向きません。
専用の推論サーバは、連続バッチングとKVキャッシュのブロック管理によって、実際の処理量を大きく上げます。
本番運用ではこちらが前提になります。
軽量な実行環境は、量子化した重みをCPUや小さなGPUで動かす用途に向きます。
手元の機器での実行や、小規模な組み込みに合います。
量子化の選択
自社運用では、量子化が必要な機器の規模をそのまま左右します。
重みだけを低いビット幅で持つ方式は、メモリ帯域の制約を緩め、生成の段階を直接速くします。
外れ値を持つチャネルを高精度で残す構成や、少量のデータで補正する構成によって、4ビットでも実用的な精度が出る場合が増えています。
ただし、影響は用途によって異なります。
長文の生成や、桁の多い数値を扱う処理では劣化が出やすい傾向があります。
自社の評価用データで、量子化の前後を比べてから採用してください。
資源の見積もり
必要なGPUメモリは、次の合計です。
- 重み:パラメータ数 × 1パラメータあたりのバイト数
- 実行時の中間データ
- KVキャッシュ:層の数、ヘッドの数、ヘッドの次元、系列長、同時実行数の積に比例
同時実行数と扱う系列長を決めないと、KVキャッシュは見積もれません。
逆に、機器が決まっている場合は、この2つの上限が決まります。
更新の運用
モデルの更新には、次の作業が伴います。
- 評価用データでの測り直し
- プロンプトの調整(対話テンプレートが変わることがある)
- 量子化のやり直し
- 追加学習をしている場合は、その再実行
外部のAPIと違い、更新の時期を自社で決められるのは利点です。
一方、更新しなければ性能向上の恩恵は受けられません。
更新の判断基準と周期を、運用に組み込んでおきます。
更新のたびに、Level 4で書いた一覧(SBOM)の版とライセンスの情報も書き換えます。
ライセンスは、版が変わると変わることがあるためです。
安全性の実装
自社運用では、安全性の仕組みを自分で組み込みます。
- 入力の検査(禁止事項に当たる要求を止める)
- 出力の検査(有害な内容、機密情報の混入)
- 権限の最小化(モデルにツールを与える場合)
- 記録(入力、出力、モデルの版、日時)
追加学習をする場合、安全性に関する調整が外れることがあります。
学習の前後で、安全性についても評価してください。
理解度チェック
Q1.【オリジナル】公開モデルの配布物のうち、見落とすと性能が大きく落ちるものとして、この記事が挙げたものはどれか。
- ア モデルの紹介文
- イ 公開元のロゴ
- ウ ダウンロードの回数
- エ 対話形式のテンプレート(指示と応答の並べ方)
正解:エ
解説:
指示と応答をどの形で並べるかは、モデルごとに決まっています。
これを外すと、性能が大きく落ちます。
ア、イ、ウは、モデルの動作には関係しません。
→ 「配布形式」に戻る
Q2.【オリジナル】本番運用で、専用の推論サーバが前提になる理由として、最も適切なものはどれか。
- ア 専用の推論サーバでないと、モデルを読み込めないから
- イ 連続バッチングとKVキャッシュのブロック管理で、実際に処理できる量が大きく上がるから
- ウ 汎用のライブラリは、すべて有料だから
- エ 専用の推論サーバを使うと、量子化が不要になるから
正解:イ
解説:
汎用のライブラリは、動作の確認や少量の処理に向きますが、まとめて処理する最適化が弱く、本番の同時実行には向きません。
アは誤りです。汎用のライブラリでも読み込めます。
ウは誤りです。費用の違いが理由ではありません。
エは誤りです。量子化をするかどうかは、機器の規模と精度で判断します。
→ 「実行環境」に戻る
Q3.【オリジナル】KVキャッシュに必要なメモリを見積もるために、先に決めておくべき2つの項目はどれか。
- ア 利用者の人数と、利用者の年齢
- イ GPUの色と、置き場所
- ウ 同時実行数と、扱う系列長
- エ モデルの名前と、公開日
正解:ウ
解説:
KVキャッシュは、層の数、ヘッドの数、ヘッドの次元、系列長、同時実行数の積に比例します。
このうち運用で決めるのが、同時実行数と系列長です。
逆に、機器が決まっている場合は、この2つの上限が決まります。
ア、イ、エは、メモリの見積もりには使いません。
→ 「資源の見積もり」に戻る
Q4.【オリジナル】量子化で、劣化が出やすい傾向がある処理として、この記事が挙げたものはどれか。
- ア 短い文章の分類
- イ 単語の置き換え
- ウ 決まった形式への書き換え
- エ 長文の生成や、桁の多い数値を扱う処理
正解:エ
解説:
量子化の影響は用途によって違い、長文の生成や、桁の多い数値を扱う処理では劣化が出やすい傾向があります。
だから、自社の評価用データで量子化の前後を比べてから採用します。
ア、イ、ウは、判断の幅が狭く、比較的影響が出にくい処理です。
→ 「量子化の選択」に戻る
Q5.【オリジナル】自社で動かしている公開モデルを、新しい版に更新した。SBOMで書き換えるべき情報として、最も適切なものはどれか。
- ア 更新した日の天気
- イ 担当者の名前だけ
- ウ モデルの版と、ライセンスの情報
- エ 何も書き換えなくてよい
正解:ウ
解説:
版が変わると、ライセンスが変わることがあります。
更新のたびに、一覧の版とライセンスの情報を書き換えます。
あわせて、評価用データでの測り直し、プロンプトの調整、量子化のやり直しも必要になります。
ア、イ、エでは、ライセンスの変化を追えません。
→ 「更新の運用」に戻る
ここまで読めば言えるようになること
- 配布物の構成要素を説明できる
- 実行環境を用途に応じて選べる
- 量子化と資源の見積もりができる
- 更新と安全性の運用を設計できる
自分で「中身」と条件を確かめたこと
私は前職のシステムエンジニアでの経験を生かして、AI分野の記事を書く仕事をしています。
その経験をもとに、このサイトを個人で立ち上げました。
2026年10月8日に、このサイトを動かしているWordpressとそれのテーマのライセンス表記を、自分で開いて確かめました。
確かめるまで知らなかったのは、テーマにも本体と同じライセンスが付いていたことです。
毎日使っているのに、条件を読んだのはこれが初めてでした。
続けて、あるオープンウェイトのモデルのライセンスを本文の5つの観点で読んでみました。
5つのうち見つけられたのは4つで、かかった時間は10分です。
「外部に提供」が、自分のブログ記事に当てはまるのかどうかは、読んでも判断がつきませんでした。
まとめ
オープンソースは、中身が公開されていて、誰でも使う、調べる、直す、配ることが許されているものを指します。
オープンウェイトは、AIのうち、できあがった重み(パラメータ)だけが公開されているものを指します。
2つの違いは、学習データの情報とコードまで公開されているかどうかです。
Level 1では、レシピが公開された料理と、できあがった料理だけを配るやり方。
Level 2では、定義を持つ言葉であり、AIでは公開の程度が3段階に分かれ、配布ページで見分けられるもの。
Level 3では、4つの自由と3つの要素で判定し、オープンウェイトの中の条件の幅まで条文で読む対象。
Level 4では、SBOMで一覧にし、総費用と法務の両面から採用を決める対象。
Level 5では、配布形式から更新までを自社で設計する対象。
ニュースで「オープンソース」と書かれていても、実際にはオープンウェイトであることが多く、条件もモデルごとに違います。
名前ではなく条文で判断する。この一点が、実務ではいちばん大きな差になります。
次に読む記事
→ オープンウェイトの最新動向2026|ライセンスの読み方
→ AIの「モデル」とは何か|5段階でわかる用語解説
→ AIモデルのパラメータとは|「〇億パラメータ」の意味と読み方
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
よくある質問(FAQ)
Q. オープンソースとは何ですか?
A. ソースコード(プログラムの設計図)が公開されていて、誰でも使う、直す、配ることが許されているソフトウェアのことです。Open Source Initiative(OSI)が10項目の定義を公開しています。
Q. オープンウェイトとは何ですか?
A. AIモデルのうち、学習してできあがった重み(パラメータ)が公開され、ダウンロードして自分の環境で動かせるものです。学習データや学習の手順は公開されていないことが多く、その状態を正確に言い表すために使われる言葉です。
Q. オープンソースとオープンウェイトの違いは何ですか?
A. 何が公開されているかの違いです。オープンウェイトは重みだけが公開されたもの、オープンソースは重みに加えて学習データの情報と学習に使ったコードまで公開されたものを指します。OSIのAI向けの定義(OSAID 1.0)は、この3つすべての公開を求めています。
Q. オープンソースと無料は同じですか?
A. 同じではありません。無料で配られていても、中身が見られなかったり、使い方に制限があったりするものはオープンソースに当たりません。
Q. 「オープンソースのAI」と呼べるモデルはありますか?
A. 重み、学習データの情報、コードのすべてを公開したモデルは、研究機関のものを中心にありますが、数は多くありません。ニュースで「オープンソースのAI」と書かれているものの多くは、定義に照らすとオープンウェイトです。
Q. オープンウェイトのモデルは、自由に商用利用できますか?
A. できるとは限りません。標準的なライセンスなら商用利用を認めていますが、開発元が独自に作ったライセンスでは、利用者数や売上が一定を超えると表示や別の契約を求めるもの、研究目的に限るもの、特定の用途を禁じるものがあります。条文の確認が必要です。
Q. 自社の環境で動かせば安全ですか?
A. 外部へ送る経路はなくなりますが、社内の権限管理、機器の管理、有害な出力への対処が自社の責任になります。責任の置き場所が移る、という理解が正確です。
参考
内容は2026年10月11日に、以下の資料で確認しました(経済産業省の手引とAIロボティクス戦略、AI事業者ガイドラインは2026年9月16日に確認)。
オープンソースの定義
- Open Source Initiative「The Open Source Definition」(Version 1.9・英語。10項目:自由な再配布、ソースコード、分野による差別の禁止 ほか)
- Open Source Initiative「The Open Source AI Definition – 1.0」(2024年10月28日公開・英語。Use、Study、Modify、Shareの4つの自由と、Data Information、Code、Parametersの3要素)
ソフトウェアの管理
- 経済産業省「ソフトウェア管理に向けたSBOM(Software Bill of Materials)の導入に関する手引 ver2.0」(令和6年8月29日・PDF。OSSの利用の一般化、ライセンス違反の影響、SBOMの定義)
AIの公開と責任
- 総務省、経済産業省「AI事業者ガイドライン(第1.2版)」(令和8年3月31日・PDF。「オープンソース化にあたっても、社会的な影響を検討する」)
- AIロボティクスに関する関係府省連絡会議「AIロボティクス戦略~社会実装を加速し、巨大市場を切り拓く~」(令和8年3月26日・PDF。2027年6月頃を目途に、国産のロボット基盤モデルのベータ版をオープンソースで公開)
理解度チェックの過去問題
- 情報処理推進機構(IPA)平成31年度 春期 基本情報技術者試験 午前 問20、令和8年度 ITパスポート試験 公開問題 問73(正解は各回の解答例で照合)
- 本記事の体験の節は、筆者が自分で確かめた記録です(実施日は本文に記載)
※定義やライセンスは改訂されることがあります。記述の時点をあわせて確認してください。
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報