AIのニュースで最も頻繁に出てくるのに、説明されないまま使われるのが「モデル」という言葉です。
「新モデルを発表」「モデルを乗り換える」「軽量モデル」。
どれも同じ言葉ですが、指しているものの解像度は場面によって違います。
この記事では、モデルという言葉の中身を5つのレベルに分けて並べました。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(7分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(9分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(9分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で通り過ぎます。
30秒で腕試し
理解度から決めたい場合は、次の3問を試してください。
答えられなくなったところが、あなたのスタート地点です。
Q1. 「新モデル発表」と「新機能追加」の違いを説明できますか
→ 詰まったら Level 1から
Q2. オープンウェイトとオープンソースの違いを説明できますか
→ 詰まったら Level 3から
Q3. 自社に合うモデルを、ベンチマーク以外の方法で選べますか
→ 詰まったら Level 4から
→ 3問とも答えられるなら Level 5から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:モデルを「勉強を終えたAIの本体」だと自分の言葉で言える
勉強が終わったあとに残るもの
AIは、たくさんの例を見て賢くなります。
では、勉強が終わったあと、何が残るのでしょうか。
残るのは、覚えたことがぎっしり詰まったファイルです。
これをモデルと呼びます。
人にたとえるなら、勉強の中身が全部入った頭のようなものです。
新しい問題を出されたら、その頭を使って答えます。
「モデル」は、洋服のモデルではない
ここでつまずく人が多いところです。
AIの世界のモデルは、ファッションのモデルとは関係ありません。
プラモデルの「モデル」に近い意味で、何かをまねて作ったもの、という意味です。
AIのモデルは、言葉の使い方や、ものの見分け方をまねて作ったものです。
だから「言語モデル」は、言葉の使い方をまねたもの、という意味になります。
「新モデル発表」は、頭が新しくなった話
ニュースで「新モデルを発表」と聞いたら、AIの頭が新しくなった、という意味です。
前より賢くなっていたり、できることが増えていたりします。
これに対して「新機能を追加」は、使い方が便利になった話で、頭が変わったわけではありません。
同じ「新しくなった」でも、中身は別です。
つまずきポイント
「ChatGPTはモデル?」
ちがいます。
ChatGPTは、モデルを使えるようにしたサービスの名前です。
中に入っているモデルには、別の名前がついています。
車とエンジンの関係で、ChatGPTが車、モデルがエンジンです。
理解度チェック
Q1. モデルとは何ですか?
AIが勉強を終えたあとに残る、覚えたことが詰まった本体です。
Q2. 「新モデル発表」は何が変わったという意味ですか?
AIの頭そのものが新しくなり、賢さやできることが変わったという意味です。
Q3. ChatGPTとモデルの関係は?
ChatGPTはモデルを使えるようにしたサービスで、モデルはその中身です。
車とエンジンの関係にあたります。
ここまで読めば言えるようになること
- [ ] モデルは学習の結果できあがった本体だと説明できる
- [ ] 新モデルと新機能の違いを説明できる
- [ ] サービス名とモデル名を区別できる
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(学習の結果できあがった本体、サービスとの違い)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:モデルの名前の読み方が分かり、世代や大きさの表記を判断できる
モデルの実体は、大量の数値
モデルの中身は、大量の数値です。
学習によって調整された数値の集まりで、この一つ一つをパラメータと呼びます。
→ AIモデルのパラメータとは|「〇億パラメータ」の意味と読み方
つまりモデルとは、パラメータの値が入った巨大なファイルと、その数値をどう使うかを決めた構造の組み合わせです。
知識が文章として書かれているわけではなく、数値の並びとして分散して保持されています。
このため、モデルから特定の知識だけを取り出したり消したりすることは簡単ではありません。
名前の付き方に規則がある
モデルの名前は、多くの場合いくつかの要素でできています。
- 系列の名前:同じ開発元の同じ路線を示す(GPT、Claude、Gemini、Llamaなど)
- 世代の番号:大きいほど新しい。世代が変わると性能が大きく変わることが多い
- 規模や用途の表記:大きさや速度の違いを示す(mini、flash、proなど)、あるいはパラメータ数(7B、70Bなど)
- 日付や版:同じ世代の中での更新を示す
「7B」の「B」はbillion、つまり10億です。
70Bなら700億のパラメータを持つという意味になります。
大きい=賢い、ではない
パラメータ数が多いほど性能が高い傾向はありますが、それだけでは決まりません。
学習データの質、学習にかけた計算量、事後学習の丁寧さで、性能は大きく変わります。
実際、小さいモデルが特定の用途で大きいモデルを上回ることは珍しくありません。
また、小さいモデルには、速い、安い、手元の機器で動かせるという利点があります。
数字の大きさは目安の一つにすぎない、と考えてください。
モデルは入れ替わる
AIのモデルは、半年から1年ほどで主力が入れ替わることも珍しくありません。
去年の比較記事が、今年はもう当てにならないことがよくあります。
だから、モデルの優劣を覚えるより、比べ方を覚えるほうが長く使えます。
自分がよく使う作業を3つ決めて、新しいモデルが出たらその3つを同じ条件で試す。
これだけで、自分にとっての優劣が判断できます。
つまずきポイント
「同じサービスなのに、答えの質が変わった気がする」
サービス側で使われるモデルが切り替わることがあります。
無料プランと有料プランで別のモデルが使われる、混雑時に軽いモデルに切り替わる、といった運用があるためです。
画面上でモデル名を選べる場合は、そこを確認してください。
理解度チェック
Q1. モデルの実体は何ですか?
学習によって調整された大量の数値(パラメータ)と、その数値の使い方を決めた構造の組み合わせです。
Q2. モデル名の「70B」は何を意味しますか?
700億個のパラメータを持つという意味です。Bはbillion(10億)を指します。
Q3. パラメータ数が多ければ性能が高いと言えますか?
言えません。
学習データの質、計算量、事後学習の丁寧さでも性能は大きく変わります。
ここまで読めば言えるようになること
- [ ] モデルの実体を数値の集まりとして説明できる
- [ ] モデル名の構成要素を読み解ける
- [ ] 規模が性能の一要素にすぎないと説明できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(パラメータの集まり、モデル名の読み方)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:モデルの種類と、公開のされ方の違いを整理できる
基盤モデルという考え方
大量のデータで汎用的に事前学習され、さまざまな用途に転用できるモデルを基盤モデルと呼びます。
LLMや画像生成モデルの多くがこれにあたります。
この考え方が現在の実務を規定しています。
用途ごとにモデルを一から作るのではなく、基盤モデルを土台にして用途に合わせて調整する。
その調整の手段が、ファインチューニングやRAG、プロンプトの工夫です。
→ ファインチューニングとは|5段階でわかる用語解説
公開のされ方で3つに分かれる
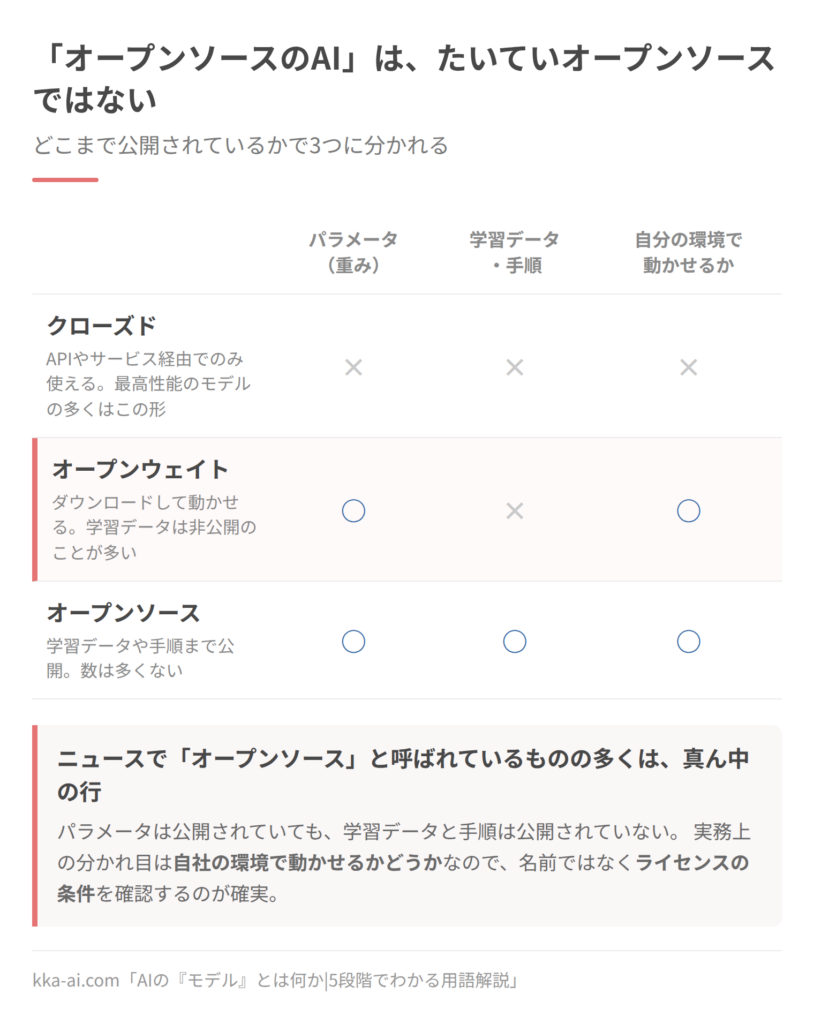
モデルは、どこまで公開されているかで区別されます。
クローズドなモデルは、パラメータが公開されず、APIやサービス経由でのみ使えます。
最高性能のモデルの多くはこの形です。
オープンウェイトのモデルは、パラメータが公開され、自分の環境にダウンロードして動かせます。
学習データや学習コードは公開されていないことが多く、その意味では完全なオープンソースとは異なります。
オープンソースのモデルは、パラメータに加えて学習データや手順まで公開されているものを指します。
数は多くありません。
用語としては、オープンウェイトのモデルがオープンソースと呼ばれることも多く、混同が起きやすい部分です。
自社の環境で動かせるかどうかが実務上の分かれ目なので、ライセンスの条件を確認するのが確実です。
→ オープンソースとオープンウェイトとは|AIの「公開」の違いを5段階でわかる用語解説
用途別の分岐
同じ系列でも、用途別に派生が用意されていることがあります。
- 指示に従うよう調整されたもの:通常の対話用途で使うのはこれ
- 事前学習だけのもの:指示に従わず文章の続きを書き続ける。追加学習の土台に使う
- コードに特化したもの:プログラムの生成や補完に最適化
- 推論を重視したもの:段階を踏んで考えてから答える。時間と費用は増える
- 軽量なもの:速度と費用を優先。手元の機器で動かせる規模のものもある
サービスでモデルを選べる場合、質問の性質に応じて使い分けると、費用と待ち時間が変わります。
蒸留という作られ方
大きなモデルの出力を教師として、小さなモデルを学習させる手法を蒸留と呼びます。
これによって、大きなモデルの振る舞いを特定の範囲で引き継いだ、小さく速いモデルを作れます。
軽量モデルの多くは、この手法や関連する工夫によって作られています。
ただし、引き継げるのは学習させた範囲に限られ、あらゆる用途で大きなモデルに並ぶわけではありません。
つまずきポイント
「モデルを自社で持てば、情報漏洩の心配はなくなる?」
自社の環境で動かせば、入力が外部に送られる経路はなくなります。
一方で、GPUの調達と運用、モデルの更新、社内での権限管理という別の責任が発生します。
漏洩の懸念が消えるのではなく、責任の所在が自社に移る、という理解が正確です。
理解度チェック
Q1. 基盤モデルとは何ですか?
大量のデータで汎用的に事前学習され、さまざまな用途に転用できるモデルです。
Q2. オープンウェイトとオープンソースの違いは何ですか?
オープンウェイトはパラメータが公開されているもので、学習データや手順は非公開のことが多くなります。
オープンソースは学習データや手順まで公開されているものを指します。
Q3. 蒸留とは何ですか?
大きなモデルの出力を教師として小さなモデルを学習させ、振る舞いを引き継がせる手法です。
ここまで読めば言えるようになること
- [ ] 基盤モデルという枠組みを説明できる
- [ ] 公開のされ方による3分類を区別できる
- [ ] 用途別の派生を選び分けられる
仕事で判断する立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(基盤モデル、公開のされ方の3分類)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:モデル選定と乗り換えの手順を、再現できる形で設計できる
ベンチマークでは選べない
公開ベンチマークのスコアは、選定の決め手になりません。
そのベンチマークの問題が学習データに混ざっていればスコアは上がり、その混入を完全には検出できないためです。
現実的な手順は次の通りです。
- 自社で実際に使う業務の代表例を20件から50件用意する
- 期待する出力と、合否の基準を先に文章にする
- 候補のモデルに同じプロンプトで解かせる
- 担当者2人以上で評価し、一致しない項目は基準を見直す
この評価セットを一度作れば、モデルが世代交代しても同じ手順で測り直せます。
半年で主力が入れ替わる領域では、一度の比較結果より、測り直せる仕組みのほうが価値があります。
選定で見る軸
精度以外に、次の軸が実務的です。
- 応答時間:対話用途では体感に直結する。推論を重視したモデルは遅い
- 費用:トークン単価。入力と出力で単価が異なる
- 一度に扱える長さ:長い資料を扱うなら制約になる
- 日本語の扱い:同じ文章でもトークン数が変わり、費用と精度に影響する
- データの所在と規約:入力を学習に使うか、保存期間はどうか
- 提供の安定性:モデルの廃止予定と移行期間が示されているか
最後の項目は見落とされがちです。
使っているモデルが廃止されると、プロンプトの調整をやり直すことになります。
契約時に、廃止の予告期間を確認してください。
乗り換えのコスト
モデルを乗り換えると、同じプロンプトでも出力が変わります。
出力の形式が崩れる、指示の解釈が変わる、といったことが起きます。
このため、乗り換えには次の作業が伴います。
- 評価セットでの再測定
- プロンプトの調整
- 出力を後段で処理している場合、その処理の見直し
複数のモデルを切り替えて使う設計にしておくと、この負担が下がります。
モデル名を設定ファイルに外出しし、評価セットを自動で流せる状態にしておくのが基本です。
用途に応じた使い分けが最も効果的
費用対効果の面では、単一のモデルに統一するより処理ごとに使い分けるほうが有効です。
- 分類や抽出のような単純な処理:軽量なモデル
- 文章の作成や要約:標準的なモデル
- 複雑な判断や計算:推論を重視したモデル
全件を高性能なモデルで処理すると、費用は簡単に数倍になります。
どの処理にどのモデルを充てるかを設計するのが、運用側の主要な仕事になります。
つまずきポイント
「開発時はうまくいったのに、本番で出力が安定しない」
入力の多様性が原因のことが多くなります。
開発時に使った例は、担当者が選んだ整った入力です。
本番では、誤字、途中で切れた文、想定外の形式が入ってきます。
評価セットには、うまくいく例だけでなく、崩れた入力を意図的に含めてください。
理解度チェック
Q1. モデル選定でベンチマークが決め手にならない理由は?
ベンチマークの問題が学習データに混入していればスコアは上がり、その混入を完全には検出できないためです。
Q2. 契約時に確認しておくべき、見落とされやすい項目は何ですか?
モデル廃止の予告期間と移行期間です。
廃止されるとプロンプトの調整をやり直すことになります。
Q3. 費用対効果を最も高める運用設計は何ですか?
処理の性質に応じてモデルを使い分けることです。
単純な処理は軽量モデル、複雑な判断だけ高性能モデルに振り分けます。
Q4. 評価セットに含めるべき、忘れられやすい入力は?
誤字、途中で切れた文、想定外の形式など、崩れた入力です。
ここまで読めば言えるようになること
- [ ] 自社の評価セットを設計できる
- [ ] 精度以外の選定軸を6つ挙げられる
- [ ] 乗り換えに伴う作業を見積もれる
- [ ] 処理ごとのモデル使い分けを設計できる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:モデルの実体と、運用上の制約を具体的に扱える
モデルの実体としてのファイル
学習済みモデルは、パラメータの数値配列(重み)と、構造を記述した設定の組み合わせとして保存されます。
配布形式としては、任意コード実行の危険がない安全なテンソル形式が標準になっています。
重みのデータ型は、学習時は16ビット浮動小数が主流で、推論時にはより低いビット幅に変換されることが多くなります。
70億パラメータのモデルなら、16ビットで約14GB、8ビットで約7GB、4ビットで約3.5GBが目安です。
これに、実行時の活性値とKVキャッシュのぶんが加わるため、GPUメモリの見積もりは重みのサイズより大きくなります。
量子化の選択
量子化は、重みを低ビット幅で表現してメモリと帯域を削る手法です。
重みのみを量子化し計算は高精度で行う方式と、活性も含めて量子化する方式があります。
前者はメモリ制約を緩和し、後者は計算スピードを上げますが精度への影響も大きくなります。
外れ値を持つチャネルを高精度のまま残す、量子化後に少量のデータで補正する、といった手法によって、4ビットでも実用的な精度が得られる場合が増えています。
ただし影響は用途によって異なるため、自社の評価セットでの確認が前提です。
適応の手段と、その保存の仕方
基盤モデルを用途に合わせる手段は、費用の低い順に次の通りです。
- プロンプトによる指示
- 少数の例を文脈に含める方式
- 検索した文書を文脈に加える方式(RAG)
- パラメータ効率的な微調整(低ランク適応など)
- 全パラメータの微調整
低ランク適応は、元の重みを固定したまま低ランクの差分行列だけを学習する手法です。
学習するパラメータが元の1%未満で済み、保存される成果物も小さくなります。
用途ごとに差分だけを保持し、実行時に切り替える運用が可能です。
一方、全パラメータの微調整は、破滅的忘却によって元の汎用性能が落ちる危険があります。
学習率を下げる、元のモデルの出力から離れすぎないよう正則化する、といった手当てが要ります。
提供形態と運用
自社環境で動かす場合、推論サーバの選択が性能を左右します。
連続バッチングによって到着した要求を随時まとめる方式、KVキャッシュをページ単位で管理してメモリ断片化を抑える方式などが、実効スループットを大きく変えます。
複数のモデルを並行して提供する場合、GPUメモリの配分が制約になります。
低ランク適応の差分だけを切り替える方式なら、基盤モデルを共有したまま複数用途に対応できます。
『基盤モデル』という言い方は、2021年のスタンフォード大の報告書で提案されたものです。
Rishi Bommasani ほか「On the Opportunities and Risks of Foundation Models」(arXiv:2108.07258・2021年・英語)
再現性と記録
モデルを業務に組み込む場合、次の記録が後から必ず必要になります。
- 使用したモデルの識別子と版
- プロンプトの版
- 生成時のパラメータ(温度など)
- 入力と出力
外部APIのモデルは、同じ名前のまま挙動が変わることがあります。
出力の変化を検知するため、評価セットを定期的に流して結果を記録しておく運用が要ります。
理解度チェック
Q1. 70億パラメータのモデルを4ビットで保持する場合、重みのサイズの目安は?
約3.5GBです。
これに活性値とKVキャッシュのぶんが加わります。
Q2. 低ランク適応の利点は何ですか?
元の重みを固定したまま低ランクの差分だけを学習するため、学習するパラメータが少なく、成果物も小さくなります。
用途ごとに差分を切り替える運用ができます。
Q3. 全パラメータの微調整で注意すべき現象は?
破滅的忘却です。
元の汎用性能が落ちるため、学習率を下げるなどの手当てが要ります。
Q4. 外部APIのモデルを使う場合、なぜ評価セットを定期的に流す必要がありますか?
同じモデル名のまま挙動が変わることがあり、出力の変化を検知する必要があるためです。
ここまで読めば言えるようになること
- [ ] 重みのサイズからGPUメモリを見積もれる
- [ ] 量子化の方式と影響を説明できる
- [ ] 適応手段を費用順に並べ、選択できる
- [ ] 業務組み込み時に残すべき記録を挙げられる
よくある質問(FAQ)
Q. AIのモデルとは何ですか?
A. 学習の結果できあがったAIの本体です。実体は、学習で調整された大量のパラメータと、その使い方を定めた構造の組み合わせです。
Q. モデルとChatGPTの違いは何ですか?
A. モデルは中身の技術で、ChatGPTはそれを使えるようにしたサービスです。同じサービスでも、使われるモデルはプランや時期によって変わることがあります。
Q. パラメータ数が多いモデルほど優れているのですか?
A. 傾向としては性能が上がりますが、それだけでは決まりません。学習データの質や事後学習の丁寧さでも変わり、小さいモデルが特定用途で上回ることもあります。
Q. オープンソースのモデルとは何ですか?
A. 一般にはパラメータが公開され、自分の環境で動かせるモデルを指して使われます。学習データや手順まで公開されているものは少なく、正確にはオープンウェイトと呼び分けられます。
Q. モデルを乗り換えるとき、何が必要になりますか?
A. 評価セットでの再測定、プロンプトの調整、出力を後段で処理している場合はその見直しです。モデル名を設定として外出ししておくと負担が下がります。
まとめ
モデルは、学習の結果できあがったAIの本体です。
Level 1では、勉強を終えたAIの頭。
Level 2では、大量のパラメータからなる実体と、その名前の読み方。
Level 3では、基盤モデルという枠組みと、公開のされ方による分類。
Level 4では、自社の評価セットで選び、使い分ける対象。
Level 5では、メモリと精度の釣り合いの中で運用するファイル。
モデルの優劣は短期間で入れ替わります。
どのモデルが優れているかを覚えるより、自社の評価セットで測り直せる仕組みを持つほうが有効です。
次に読む記事
→ AIモデルのパラメータとは|「〇億パラメータ」の意味と読み方
→ AIの「学習」とは|5段階でわかる用語解説
→ AIの「推論」とは|5段階でわかる用語解説
→ 今さら聞けないAI用語30選
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報