「さっき伝えた前提を忘れている」「長い資料を渡したのに、途中しか見ていない」。
AIを使っていて起きるこの種の不満は、ほとんどがコンテキストの理解で説明が付きます。
この記事では、コンテキストの説明を5つのレベルに分けて並べました。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(7分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(9分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(9分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で通り過ぎます。
1分で腕試し
理解度から決めたい場合は、次の4問を試してください。
Q1〜Q4は、Level 1〜4の内容に1問ずつ対応しています。
最初にまちがえた問題のLevelが、あなたのスタート地点です。
4問とも正解なら、Level 5から読んでください。
各レベルの終わりにも、4択の理解度チェックがあります。
トークンという単位があやふやな場合は、先にこちらを読んでください。
→ トークンとは|AIの料金と文字数制限を決める単位
Q1.【オリジナル】AIとの会話が長くなったとき、最初に伝えた前提を無視した返事が返ってきた。理由として、最も適切なものはどれか。
- ア AIが前提を覚えたうえで、わざと無視している
- イ 一度に見ていられる範囲がいっぱいになり、最初のほうが範囲から外れて見えなくなった
- ウ AIが疲れて、集中力が落ちた
- エ 前提を伝えた文章に、誤字があった
正解:イ
解説:
AIが一度に見ていられる範囲(コンテキスト)には限りがあります。
会話が長くなると、最初のほうに置いた内容が範囲から外れます。
アは誤りです。見えていないので、無視しているわけではありません。
ウは誤りです。AIは疲れません。
エは、前提を無視する理由の説明になっていません。
→ まちがえたら Level 1から
Q2.【オリジナル】1回のやり取りで、コンテキストの上限を消費しているものに含まれないものはどれか。会話をまたいで覚える機能は使っていないものとする。
- ア サービスが毎回付けている指示文
- イ その会話の中で、これまでに交わしたやり取り
- ウ これからAIが作る答えの分
- エ 別に始めた新しい会話の中で交わしたやり取り
正解:エ
解説:
別々の会話は、別々の机です。
アは、利用者には見えないことが多いものの、毎回入力に含まれています。
イは、会話を続けるたびに毎回入力に含まれます。
ウの答えの分も、上限の中に含まれます。
→ まちがえたら Level 2から
Q3.【オリジナル】コンテキストに上限がある理由の組み合わせとして、最も適切なものはどれか。
- ア 自己注意の計算量が長さの二乗で増えることと、生成時に保持する中間結果のメモリが長さに比例すること
- イ 著作権の制限と、サービスの料金体系
- ウ 学習データが足りないことと、利用者の入力の速さ
- エ 計算量が長さに比例して増えることと、会話の記録を保存するストレージの容量
正解:ア
解説:
計算量とメモリの両面から、長さには実用上の制約がかかります。
イは、仕組みの上での理由ではありません。
ウは、どちらも上限の理由ではありません。
エは誤りです。自己注意の計算量は長さの二乗で増えます。問題になるのも保存用のストレージではなく、生成中に保持するメモリです。
→ まちがえたら Level 3から
Q4.【オリジナル】業務システムで、会話の履歴が上限に近づいたときの扱いとして、本文で最も事故が少ないとした方式はどれか。
- ア 古い順に落とす(先頭の指示も一緒に落とす)
- イ 古い順に落とし、落としたことは利用者に知らせない
- ウ 利用者に、新しい会話への切り替えを促す
- エ 毎回、履歴全体を要約して圧縮する
正解:ウ
解説:
挙動が予測しやすく、費用も抑えられます。
アは、最初に伝えた重要な前提が落ちる危険があります。
イは、落ちたことが見えないため、前提の外れに気付けません。
エは、要約の生成に費用と時間がかかり、要約の過程で情報が失われる危険もあります。
→ まちがえたら Level 4から
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:AIが覚えていられる範囲には限りがあると説明できる
机の広さで考える
宿題をするとき、机の上に教科書やノートを広げます。
机が広ければたくさん置けますが、いっぱいになったら、古いものから片付けることになります。
AIも同じです。
一度に見ていられる範囲が決まっていて、その範囲をコンテキストといいます。
机の広さにあたるのがコンテキストウィンドウです。
会話が長くなると、机がいっぱいになります。
すると、最初のほうに置いた紙が片付けられて、見えなくなります。
「忘れた」ように見えるのは、机から落ちたから
長く話していると、最初に伝えたことを無視した返事が返ってくることがあります。
これは、AIが忘れっぽいのではありません。
机から落ちて、もう見えていないのです。
だから、また同じことを伝えれば、ちゃんと分かってくれます。
一度に渡せる量にも限りがある
長い文章を渡したときも同じです。
机に載りきらない分は、見てもらえません。
「全部読ませたはずなのに、後半のことしか答えない」というのは、前半が机から落ちたということです。
どうすればいいか
やり方は2つです。
一つは、話題が変わったら新しい会話を始めることです。
机をきれいに片付けてから始めるのと同じです。
もう一つは、大事な前提をもう一度伝えることです。
落ちた紙を、また机に置き直す作業にあたります。
つまずきポイント
「新しい会話にすると、前のことは完全に消える?」
消えます。
別々の会話は、別々の机です。
ただし、サービスによっては会話をまたいで覚えておく機能を持つものもあります。
その場合は、覚えている内容を確認できる画面があるはずです。
理解度チェック
Q1.【オリジナル】本文で、コンテキストを机にたとえたとき、「机の広さ」にあたるものはどれか。
- ア AIが学習した本の数
- イ AIを動かしているコンピュータの大きさ
- ウ AIが一度に見ていられる範囲の大きさ(コンテキストウィンドウ)
- エ AIが答えを出すまでの時間
正解:ウ
解説:
机の上に置けるものが、AIが一度に見ていられるものです。
机の広さにあたるのが、コンテキストウィンドウです。
アの学習の量は、机の広さとは別の話です。
イとエは、たとえとは関係がありません。
→ Level 1「机の広さで考える」に戻る
Q2.【オリジナル】長い会話の途中で、最初に伝えたことを無視した返事が返ってきた。いちばん手早い対処はどれか。
- ア 大事な前提を、もう一度伝える
- イ AIに「忘れないで」と強く注意する
- ウ 同じ質問を何度もくり返す
- エ 文字を大きくして入力する
正解:ア
解説:
机から落ちた紙を、もう一度机に置き直す作業です。
同じことを伝えれば、また見えるようになります。
イは、見えていないものを思い出させることはできません。
ウは、会話がさらに長くなり、机がもっと混み合います。
エは、見え方とは関係がありません。
→ Level 1「「忘れた」ように見えるのは、机から落ちたから」に戻る
Q3.【オリジナル】長い文章を渡したのに、AIが後半のことしか答えない。本文の説明として、最も適切なものはどれか。
- ア AIは、文章の後半だけを読むように作られている
- イ 前半が机に載りきらず、見えていない
- ウ 前半に書いてあることが、すべて間違っていた
- エ AIは、前半の内容に興味がない
正解:イ
解説:
机に載りきらない分は、見てもらえません。
「全部読ませたはずなのに後半のことしか答えない」のは、前半が机から落ちたということです。
アは誤りです。後半だけを読む作りになっているわけではありません。
ウとエは、本文の説明とは関係がありません。
→ Level 1「一度に渡せる量にも限りがある」に戻る
Q4.【オリジナル】話題がまったく変わったときにすると、AIの返事がまとまりやすくなる方法はどれか。
- ア 同じ会話の中で、話題を変えて続ける
- イ 前の話題のやり取りを、すべてコピーして貼り直す
- ウ 返事が来るまで、少し時間をおく
- エ 新しい会話を始める
正解:エ
解説:
新しい会話を始めるのは、机をきれいに片付けてから始めるのと同じです。
アは、前の話題が机に残ったままになります。
イは、関係のない紙で机をいっぱいにすることになります。
ウは、机の状態は変わりません。
→ Level 1「どうすればいいか」に戻る
Q5.【オリジナル】新しい会話を始めたとき、前の会話の内容について正しいものはどれか。会話をまたいで覚える機能は使っていないものとする。
- ア 前の会話の内容は、新しい会話には持ち込まれない
- イ 前の会話の内容は、自動的に新しい会話にもすべて引き継がれる
- ウ 前の会話の内容は、AIの頭の中に永久に残る
- エ 前の会話で話した相手の名前だけは、必ず覚えている
正解:ア
解説:
別々の会話は、別々の机です。
新しい会話には、前の会話の紙は置かれていません。
イは誤りです。引き継ぐ機能がない場合は、引き継がれません。
ウとエは誤りです。会話をまたいで覚える機能を持つサービスもありますが、その場合は覚えている内容を確認できる画面があるはずです。
→ Level 1「つまずきポイント」に戻る
ここまで読めば言えるようになること
- コンテキストを机の広さで説明できる
- 忘れたように見える理由を説明できる
- 2つの対処を実践できる
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(机の広さのたとえ、範囲から外れると見えなくなること)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:上限の中身を理解し、入力の組み立て方を工夫できる
上限はトークン数で決まる
コンテキストウィンドウの上限は、文字数ではなくトークン数で決まっています。
トークンは、単語や単語のかけらにあたる単位です。
→ トークンとは|AIの料金と文字数制限を決める単位
日本語では、おおむね1文字から2文字で1トークンです。
上限が20万トークンなら、日本語で10万文字から20万文字くらいが目安になります。
何が上限を消費しているか
上限を消費しているのは、質問文だけではありません。
- サービスが毎回付けている指示文(利用者には見えないことが多い)
- 渡した資料
- これまでの会話のやり取り全部
- これから作る答えの分
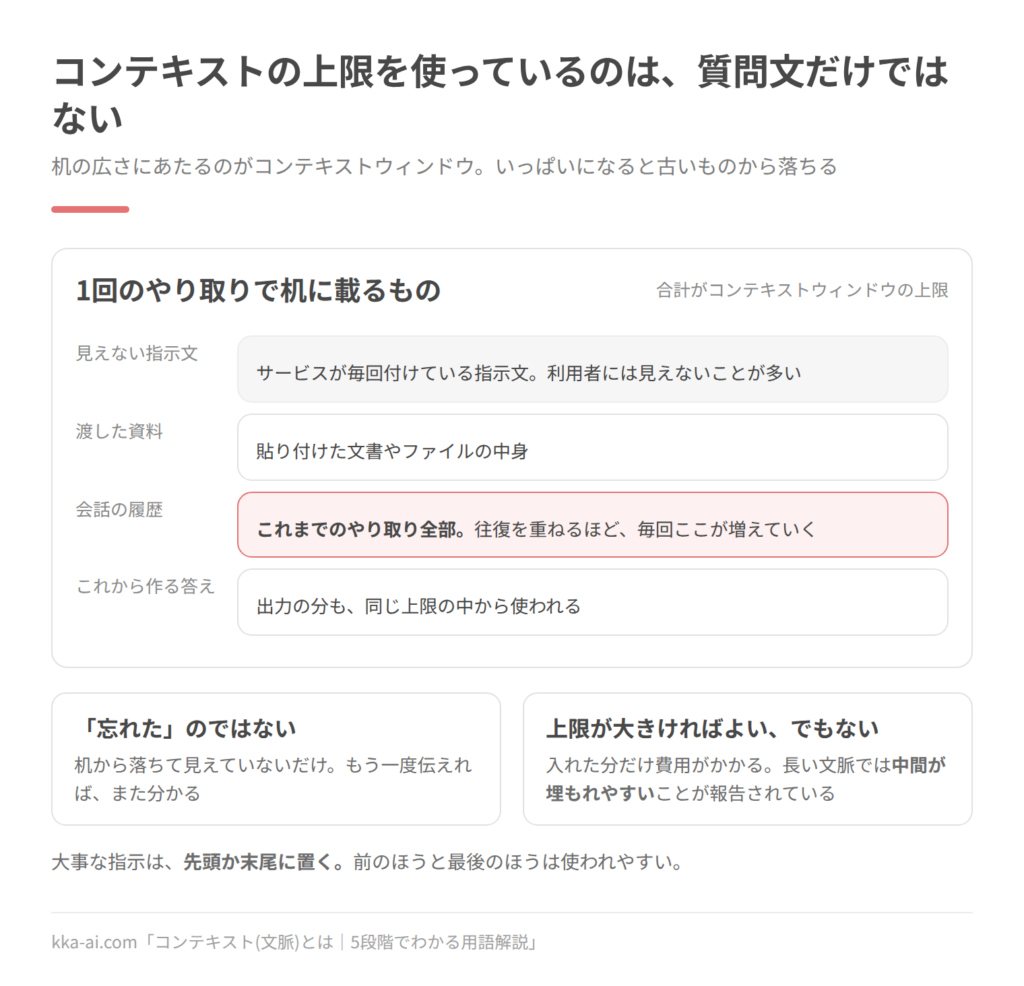
会話を続けるたびに、過去のやり取り全部が毎回入力に含まれます。
往復を重ねるほど、消費が増えていきます。
上限が大きければよい、わけではない
上限の大きなモデルなら全部入れればよい、とはなりません。
一つは、入れた分だけ費用がかかるためです。
もう一つは、長い文脈の中間に置かれた情報が使われにくくなる傾向が報告されているためです。
前のほうと最後のほうは効果的で中間は埋もれやすい。
そのため、大事な指示は先頭か末尾に置くのが実務的なコツです。
上手な渡し方
長い資料を扱うときは、次の順で考えます。
- 必要な部分だけを抜き出して渡す
- 章ごとに分けて処理し、最後にまとめる
- 大事な指示は先頭か末尾に置く
- 話題が変わったら新しい会話にする
「全部渡してから聞く」より「必要な部分を渡して聞く」ほうが、精度も費用も改善します。
つまずきポイント
「途中から答えの質が落ちた気がする」
会話が長くなり、初期の前提が外れている可能性があります。
また、それまでのやり取りの中に、うまくいかなかった試行が蓄積している場合もあります。
方向性を変えたいときは、いま必要な前提だけをまとめて新しい会話を始めるほうが早くなります。
理解度チェック
Q1.【オリジナル】コンテキストウィンドウの上限は、何の数で決まっているか。
- ア 文字数
- イ 単語数
- ウ トークン数
- エ 会話の往復の回数
正解:ウ
解説:
トークンは、単語や単語のかけらにあたる単位です。
アは誤りです。同じ文字数でも、言語や文字の種類によってトークン数は変わります。
イは誤りです。単語そのものではなく、単語のかけらも1単位になります。
エは誤りです。往復の回数ではなく、往復で積み上がったトークンの合計で決まります。
→ Level 2「上限はトークン数で決まる」に戻る
Q2.【オリジナル】同じ会話で往復を重ねるほど、1回あたりの消費が増えていく理由として、最も適切なものはどれか。
- ア AIの答えが、往復ごとに必ず長くなるから
- イ 会話を続けるたびに、過去のやり取り全部が毎回入力に含まれるから
- ウ 往復の回数に応じて、サービスが追加の料金を上乗せするから
- エ AIが、往復のたびに新しい知識を学習するから
正解:イ
解説:
2回目の入力には1回目のやり取りが、10回目の入力には9回分のやり取りが含まれます。
アは誤りです。答えの長さは往復ごとに増えるとは限りません。
ウは、仕組みの説明ではありません。
エは誤りです。会話の中でモデルが学習するわけではありません(Level 3で扱います)。
→ Level 2「何が上限を消費しているか」に戻る
Q3.【オリジナル】長い資料と一緒に大事な指示を渡すとき、指示を置く位置として、最も適切なものはどれか。
- ア 資料のちょうど真ん中
- イ どこに置いても結果は変わらない
- ウ 資料を細かく区切り、区切りごとに毎回同じ指示を挟む
- エ 先頭か末尾
正解:エ
解説:
長い文脈では、前のほうと最後のほうは使われやすく、中間に置いた情報は埋もれやすい傾向が報告されています。
アは、いちばん埋もれやすい位置です。
イは誤りです。置く位置で扱われ方が変わる傾向が報告されています。
ウは、本文で勧めている方法ではありません。入力が増えて費用がかかるうえ、中間に置いた指示は埋もれやすいままです。
→ Level 2「上限が大きければよい、わけではない」に戻る
Q4.【オリジナル】200ページの社内資料について、AIに質問したい。進め方として、最も適切なものはどれか。
- ア 必要な部分だけを抜き出して渡し、話題が変わったら新しい会話にする
- イ 上限の大きなモデルなら、全部を渡すのが最も精度が高く、費用も変わらない
- ウ 途中で答えの質が落ちてきても、前提を共有している同じ会話で続ける
- エ 大事な指示は、資料の真ん中あたりに埋め込んでおく
正解:ア
解説:
「全部渡してから聞く」より「必要な部分を渡して聞く」ほうが、精度も費用も改善します。
イは誤りです。入れた分だけ費用がかかり、中間の情報は使われにくくなります。
ウは、初期の前提が外れていることがあります。方向を変えたいときは、必要な前提をまとめて新しい会話を始めるほうが早くなります。
エは、中間はいちばん埋もれやすい位置です。
→ Level 2「上手な渡し方」に戻る
Q5.【オリジナル】上限の大きなモデルについて、本文の説明として最も適切なものはどれか。
- ア 上限が大きければ、資料は全部入れるのがいちばんよい
- イ 上限が大きいモデルでは、中間に置いた情報も必ず使われる
- ウ 入れた分だけ費用がかかり、中間の情報は埋もれやすいので、全部入れればよいとは限らない
- エ 上限が大きいモデルは、入力の量に関係なく料金が一定である
正解:ウ
解説:
上限の大きさと、全部入れるべきかどうかは別の話です。
アは誤りです。費用と精度の両面で、全部入れるのが最適とは限りません。
イは誤りです。上限が大きくなっても、中間が埋もれる傾向はなくなりません。
エは誤りです。入力したトークン数に応じて費用がかかります。
→ Level 2「上限が大きければよい、わけではない」に戻る
ここまで読めば言えるようになること
- 上限がトークン数で決まると説明できる
- 何が上限を消費しているか挙げられる
- 長い資料の渡し方を工夫できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(トークン数で決まる上限、何が上限を消費するか)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:上限が存在する理由を仕組みから説明できる
なぜ上限があるのか
上限がある理由は2つあります。
一つは、計算量です。
トランスフォーマーの自己注意は、文章の中のすべての位置どうしの関係を扱います。
このため、計算量は系列の長さに対して二乗のオーダーで増えます。
長さが2倍になると、計算はおよそ4倍になります。
もう一つは、メモリです。
生成のたびに過去の中間結果を保持する必要があり、その量は長さに比例します。
→ AIの「推論」とは|5段階でわかる用語解説
計算量とメモリの両面から、長さには実用上の制約がかかります。
学習した長さを超えると弱くなる
もう一つの制約が、学習時の長さです。
モデルは、ある長さまでの文章で学習されます。
その長さを超える入力を与えると、位置の情報の扱いが学習時の範囲を外れ、性能が落ちる傾向があります。
上限を伸ばす技術は進んでいますが、「上限まで入れられる」ことと「上限まで有効に使える」ことは別です。
公表された上限の数字と、実際に性能が保たれる長さは一致しないことがあります。
中間が埋もれる現象
長い文脈の中間に置かれた情報が使われにくくなる傾向は、複数の報告で示されています。
先頭と末尾に置かれた情報は使われやすく、中間は取りこぼされやすい、という形です。
実務では、これを前提に入力を組み立てます。
- 指示は先頭に置く
- 参照させたい資料はその後に置く
- 最も重要な指示や質問は末尾で繰り返す
末尾での繰り返しは冗長に見えますが、長い入力では有効です。
会話の記憶とは違う
ここは混同しやすい部分です。
コンテキストは、モデルの中身が変わることではありません。毎回、それまでのやり取りを入力として送り直しているだけです。モデルのパラメータは変わらないため、会話の内容が学習されるわけではありません。
AIの学習については以下の記事で解説しています。
→ AIの「学習」とは|5段階でわかる用語解説
会話をまたいで覚えている機能を持つサービスは、別の仕組みを持っています。
過去の会話から要点を抽出して保存し、次の会話の入力に差し込む方式です。
これも学習ではなく、入力の組み立ての話です。
つまずきポイント
「上限に達したら、どうなる?」
サービスによって挙動が異なります。
古い部分から自動的に落とす、要約して圧縮する、エラーを返す、のいずれかです。
自動で落とす方式では、落ちたことが利用者に見えないため、前提が外れていることに気付きにくくなります。
理解度チェック
Q1.【オリジナル】トランスフォーマーの自己注意で、入力の長さが2倍になると、計算量はおよそ何倍になるか。
- ア 変わらない
- イ 2倍
- ウ 4倍
- エ 8倍
正解:ウ
解説:
自己注意は、文章の中のすべての位置どうしの関係を扱うので、計算量は長さの二乗のオーダーで増えます。
2の二乗で4倍です。
アは誤りです。長さに関係なく一定になるわけではありません。
イは、長さに比例する場合の答えです。
エは、長さの三乗で増える場合の答えです。
→ Level 3「なぜ上限があるのか」に戻る
Q2.【オリジナル】公表されているコンテキストの上限と、実際の性能の関係について、最も適切なものはどれか。
- ア 公表された上限までは、どの長さでも性能は変わらない
- イ 学習時の長さを超えると性能が落ちる傾向があり、上限まで入れられることと、上限まで有効に使えることは別である
- ウ 上限を超えた入力も、モデルがすべて自動的に要約して正しく扱う
- エ 上限が大きいモデルほど、中間に置いた情報も確実に使われる
正解:イ
解説:
学習時の長さを超えると、位置の情報の扱いが学習時の範囲を外れ、性能が落ちる傾向があります。
アは誤りです。長さによって性能は変わります。
ウは誤りです。上限に達したときの挙動はサービスによって違います。要約する方式でも、情報は失われます。
エは誤りです。上限が大きくなっても、中間が埋もれる傾向はなくなりません。
→ Level 3「学習した長さを超えると弱くなる」に戻る
Q3.【オリジナル】長い入力を組み立てるときの配置として、本文で勧めているものはどれか。
- ア 資料を先頭に置き、指示は資料の真ん中に入れる
- イ 指示は最後に一度だけ書き、資料はその前に置く
- ウ 資料と指示を交互に細かく並べる
- エ 指示を先頭に置き、資料をその後に置き、最も重要な指示や質問を末尾で繰り返す
正解:エ
解説:
先頭と末尾は使われやすく、中間は取りこぼされやすい、という性質を前提にした配置です。
末尾での繰り返しは冗長に見えますが、長い入力では役に立ちます。
アは、指示をいちばん埋もれやすい位置に置いています。
イは、先頭に指示がありません。
ウは、本文で勧めている形ではありません。
→ Level 3「中間が埋もれる現象」に戻る
Q4.【オリジナル】コンテキストと学習の関係について、最も適切なものはどれか。
- ア 毎回それまでのやり取りを入力として送り直しているだけで、モデルのパラメータは変わらない
- イ 会話を続けると、その内容でモデルのパラメータが少しずつ更新される
- ウ 会話をまたいで覚える機能は、会話の内容でモデルを追加学習する仕組みである
- エ 新しい会話を始めると、前の会話で学習した内容がモデルから削除される
正解:ア
解説:
コンテキストは、モデルの中身が変わることではありません。
イは誤りです。会話の内容が学習されるわけではありません。
ウは誤りです。過去の会話から要点を取り出して保存し、次の会話の入力に差し込む方式です。これも学習ではなく、入力の組み立ての話です。
エは誤りです。そもそも前の会話で学習していないので、削除されるものもありません。
→ Level 3「会話の記憶とは違う」に戻る
Q5.【オリジナル】会話が上限に達したときの挙動のうち、前提が外れたことに利用者が最も気付きにくいものはどれか。
- ア エラーを返して、それ以上の入力を受け付けない
- イ 古い部分から自動的に落として、そのまま会話を続ける
- ウ 要約して圧縮したうえで、要約したことを画面に表示する
- エ 新しい会話を始めるよう、利用者に促す
正解:イ
解説:
自動で落とす方式では、落ちたことが利用者に見えないため、前提が外れていることに気付きにくくなります。
アは、止まるので、上限に達したことがすぐ分かります。
ウは、表示があるので、圧縮されたことは分かります(細部が失われる危険は残ります)。
エは、切り替えを明示的に促すので、挙動が予測しやすい方式です。
→ Level 3「つまずきポイント」に戻る
ここまで読めば言えるようになること
- 上限がある理由を計算量とメモリで説明できる
- 有効長と公称上限の違いを説明できる
- 中間が埋もれる現象を前提に入力を組める
- コンテキストと学習を区別できる
仕事で判断する立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(計算量とメモリの制約、中間が埋もれる現象)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:コンテキストの配分を設計し、費用と精度の両方を管理できる
上限の配分を先に決める
コンテキストウィンドウの上限はモデルごとに公開されています。
システムに組み込む場合、上限をどう配分するかを先に決めます。
- 固定の指示文:全体の1割程度に収める
- 参照文書:必要な範囲に絞る
- 会話履歴:保持する往復数の上限を決める
- 出力の予約:全体の2割程度を残す
出力の予約を確保しないと、答えの途中で打ち切られます。
このとき、途中で切れた出力が後段の処理に渡ると、形式の崩れとして表面化します。
【参考】: Anthropic「Context windows」(公式ドキュメント)
履歴の扱いを決めておく
会話が続く用途では、履歴が上限に近づいたときの扱いを決めておく必要があります。
選択肢は3つです。
古い順に落とす方式は、実装が簡単です。
ただし、最初に伝えた重要な前提が落ちる危険があります。
これを避けるため、先頭の指示だけは常に残す構成にします。
要約して圧縮する方式は、情報を保ちながら量を減らせます。
要約の生成に費用と時間がかかり、要約の過程で情報が失われる危険もあります。
新しい会話に切り替える方式は、利用者に明示的に切り替えを促します。
挙動が予測しやすく、費用も抑えられます。
用途によりますが、業務システムでは3番目が最も事故が少なくなります。
長い文書を扱う設計
長い文書を扱う要件では、全文を入力する設計は避けます。
文書を分割して検索し、関連する部分だけを入力に含める方式のほうが、精度も費用も優れます。
分割の設計では、次が要点になります。
- 意味のまとまりで分ける(段落や節の境界を使う)
- 分割の境界をまたぐ情報を失わないよう、少し重ねる
- 各断片に、出典と位置の情報を付ける
出典と位置を付けておくと、回答に根拠を併記でき、確認の工数が下がります。
実際に長い文章を扱ってみました。
試したこと(2026年9月8日)
- 使ったもの:Claude Pro
- やったこと:1万5千字の原稿を渡し、文体のルールを最初に指示してから、章ごとに直させた
- 結果:最初の4章までは指示どおりだったが、6章目あたりから一文の長さの指定が崩れた
- つまずいた点:上限に達したわけではないので、警告は出ない。
気付かずに進めると、後半だけ文体が違う原稿ができる。
いまは章ごとに会話を分けて、そのつど文体のルールを貼り直している
費用への影響
コンテキストの長さはそのまま費用に影響します。
- 入力トークン数として直接課金される
- 会話を続けるほど、過去分が毎回課金される
- 長い文脈は、同時に処理できる要求数を減らす
対話を10往復する用途では、最後の1回の入力に最初の9往復分が含まれます。
往復数の上限を決めるだけで、費用の上限が定まります。
キャッシュを活かす設計
共通の先頭部分について、割引や高速化を提供する事業者があります。
これを活かすには、入力の先頭を固定する設計が要ります。
- 固定の指示文を先頭に置く
- 利用者ごとの情報や質問は後方に置く
先頭に変動する情報を置くと、共有できる範囲がなくなり、この利点を失います。
つまずきポイント
「上限を大きいモデルに変えたのに、精度が上がらない」
入力量が増えたことで、中間の情報が使われにくくなっている可能性があります。
入れられる量が増えたことは、全部入れるべきという意味ではありません。
必要な部分に絞ったほうが、精度も費用も改善する場面のほうが多くなります。
理解度チェック
Q1.【オリジナル】社内向けのAIの問い合わせ窓口を作る。条件は次のとおりである。10回目の問い合わせで、AIに送られる入力はおよそ何トークンか。
固定の指示文は1,000トークンで、毎回先頭に付ける。
利用者の質問は毎回500トークン、AIの回答は毎回500トークンとする。
それまでの質問と回答は、すべて入力に含めて送り直す。
- ア 6,000トークン
- イ 10,000トークン
- ウ 10,500トークン
- エ 60,000トークン
正解:ウ
解説:
固定の指示文1,000+過去9往復分の質問と回答(9×1,000=9,000)+10回目の質問500=10,500トークンです。
アは、過去の回答の分を数え忘れた数です(1,000+9×500+500)。
イは、10回目の質問そのものを数え忘れた数です。
エは、1回目から10回目までの入力を合計した数で、1回分の入力ではありません。
往復数の上限を決めれば、費用の上限も決まります。
→ Level 4「費用への影響」に戻る
Q2.【オリジナル】コンテキストの上限の配分で、出力の分を確保しなかった場合に起きることとして、最も適切なものはどれか。
- ア AIが自動的に入力を削って、答えを最後まで出す
- イ 固定の指示文が無視され、代わりに会話の履歴が優先される
- ウ 何も起きない。出力の分は上限に含まれない
- エ 答えが途中で打ち切られ、その出力を受け取る後の処理で形式の崩れとして表に出る
正解:エ
解説:
本文では、出力の予約として全体の2割程度を残す配分を目安にしています。
アは、そういう挙動を前提にはできません。
イは、出力の分の不足とは関係のない話です。
ウは誤りです。出力の分も上限に含まれます(Level 2)。
→ Level 4「上限の配分を先に決める」に戻る
Q3.【オリジナル】履歴を古い順に落とす方式を選ぶとき、本文で勧めている工夫はどれか。
- ア 落とす量を毎回ばらばらにする
- イ 先頭の指示だけは常に残す構成にする
- ウ 落としたことを記録に残さない
- エ 新しいやり取りから先に落とす
正解:イ
解説:
古い順に落とす方式は実装が簡単ですが、最初に伝えた重要な前提が落ちる危険があります。
先頭の指示を常に残せば、その危険を避けられます。
アとウは、挙動が予測しにくくなるだけです。
エは、直前の話が見えなくなるので、会話が成り立ちません。
→ Level 4「履歴の扱いを決めておく」に戻る
Q4.【オリジナル】300ページの社内規程について質問に答える仕組みを作るため、文書を分割して検索し、関連する部分だけを入力に含める。分割の設計として、最も適切なものはどれか。
- ア 文字数だけで機械的に区切り、断片どうしは重ねず、出典の情報も付けない
- イ 分割はせず、300ページの全文を毎回入力に含める
- ウ 段落や節の境界で分け、境界をまたぐ情報を失わないよう少し重ね、各断片に出典と位置の情報を付ける
- エ 1文ずつに分けて、文の順番の情報は捨てる
正解:ウ
解説:
出典と位置を付けておくと、回答に根拠を添えられ、確認の手間が下がります。
アは、意味のまとまりが途中で切れ、境界をまたぐ情報を失い、根拠も示せません。
イは、本文で避けるとした設計です。費用がかかり、中間の情報は埋もれやすくなります。
エは、細かすぎて前後の文脈が失われ、位置の情報もなくなります。
→ Level 4「長い文書を扱う設計」に戻る
Q5.【オリジナル】事業者が提供する、共通の先頭部分への割引や高速化(キャッシュ)を活かすための入力の組み立てとして、最も適切なものはどれか。
- ア 固定の指示文を先頭に置き、利用者ごとの情報や質問は後ろに置く
- イ 利用者の名前と日時を先頭に置き、固定の指示文をその後に置く
- ウ 毎回、固定の指示文の言い回しを少しずつ変える
- エ 固定の指示文を、質問の後ろに置く
正解:ア
解説:
先頭が毎回同じであるほど、共有できる範囲が長くなります。
イは、先頭に毎回変わる情報を置いているので、共有できる範囲がなくなります。
ウは、言い回しが変わると、先頭が同じではなくなります。
エは、先頭に来るのが毎回変わる質問になります。
→ Level 4「キャッシュを活かす設計」に戻る
ここまで読めば言えるようになること
- 上限の配分を設計できる
- 履歴の扱いを方式で選べる
- 長い文書の分割方針を決められる
- キャッシュを活かす入力構成にできる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:長文脈を支える技術と、その限界を説明できる
計算量とメモリの構造
自己注意は、系列内の全対の関係を計算するため、計算量は系列長の二乗に比例します。
入力処理の段階では、この項が支配的になります。
生成の段階では、KVキャッシュによって過去分の再計算を避けます。
このとき1トークンあたりの計算量は系列長に線形ですが、メモリ消費は系列長とバッチサイズの積に比例します。
長い文脈と高い同時実行数は、このメモリで衝突します。
キャッシュ量を削る構成として、複数の注意ヘッドで鍵と値を共有する方式が広く採られています。
キャッシュ自体の量子化も併用されます。
位置表現と外挿
トランスフォーマーは、位置の情報を明示的に与える必要があります。
現在広く使われているのは、回転による位置表現です。
相対的な位置関係を表現でき、ある程度の外挿が可能である点が利点です。
学習時より長い系列へ伸ばす手法として、位置の刻みを圧縮する補間や、周波数帯ごとに扱いを変える方式があります。
いずれも、少量の長文データでの追加学習と併用されることが一般的です。
外挿には限界があります。
学習時の長さを大きく超えると、注意の分布が崩れ、性能が落ちます。
公称の上限と、実際に性能が保たれる長さの乖離は、この点に起因します。
注意の近似
系列長の二乗という計算量を下げる方向として、注意の範囲を制限する方式があります。
局所的な窓に限定する、一定間隔で疎に接続する、少数の大域的なトークンを併用する、といった構成です。
一方、近似を導入すると、長距離の依存関係を取りこぼす危険があります。
実装としては、近似ではなくメモリアクセスの最適化によって、正確な注意のまま高速化する方向も広く使われています。
タイル単位で計算し、中間結果を高帯域メモリに書き戻さない方式が代表的です。
有効長の評価
長文脈の性能評価には、専用の設計が要ります。
特定の情報を長い文脈の中に埋め込み、それを取り出せるかを測る方式は、位置による差を可視化できます。
ただし、単一の情報を取り出す課題は比較的易しく、これに合格することが実務での性能を保証しません。
より厳しい評価としては、複数の箇所の情報を統合する必要がある課題、文脈全体にわたる集約が必要な課題があります。
自社の用途に近い形で評価セットを作るのが確実です。
長い入力では、中ほどに置いた情報が使われにくくなる傾向が報告されています。
【参考】: Nelson F. Liu ほか「Lost in the Middle: How Language Models Use Long Contexts」(arXiv:2307.03172・2023年)
文脈の設計
長い文脈を有効に使うには、入力の構成そのものが設計対象になります。
- 固定部分を先頭に置き、キャッシュの再利用を可能にする
- 参照文書を関連度順に並べる(先頭と末尾が効果的である性質を利用する)
- 各断片に出典と位置の識別子を付け、出力での参照を可能にする
- 重要な指示を末尾で再掲する
また、文脈に入れる情報を検索で絞る設計は、精度の面でも有利です。
関連しない情報が多く含まれると、注意が分散し、性能が落ちる傾向があります。
入れられるからといって入れるのは、精度の観点からも最適ではありません。
理解度チェック
Q1.【オリジナル】長い入力を扱うとき、入力を読み込む段階と、答えを1トークンずつ生成する段階で、それぞれ支配的になる制約の組み合わせとして、最も適切なものはどれか。
- ア 読み込み:KVキャッシュのメモリ/生成:系列長の二乗に比例する計算量
- イ 読み込み:ディスクの読み出し速度/生成:通信の帯域
- ウ どちらも系列長の三乗に比例する計算量
- エ 読み込み:系列長の二乗に比例する計算量/生成:KVキャッシュのメモリ
正解:エ
解説:
生成の段階では、KVキャッシュで過去分の再計算を避けるので、1トークンあたりの計算量は系列長に比例する程度に収まります。
そのかわり、メモリの消費が系列長とバッチサイズの積に比例して増えます。
アは、組み合わせが逆です。
イは、本文で扱う制約ではありません。
ウは誤りです。三乗ではありません。
→ Level 5「計算量とメモリの構造」に戻る
Q2.【オリジナル】計算量を大きく増やさずにKVキャッシュの量を減らす構成として、広く採られているものはどれか。
- ア 生成のたびに過去分をすべて計算し直し、キャッシュを持たない
- イ 複数の注意ヘッドで、鍵と値を共有する
- ウ 同時に処理する要求の数(バッチサイズ)を増やす
- エ 自己注意をやめて、すべての層を畳み込みに置き換える
正解:イ
解説:
鍵と値を共有するヘッドを増やすほど、保持するキャッシュの量が減ります。
キャッシュ自体の量子化も併用されます。
アは、メモリは減りますが、計算量が大きく増えます。KVキャッシュは、この再計算を避けるための仕組みです。
ウは、キャッシュの量が系列長とバッチサイズの積に比例するので、逆に増えます。
エは、構造そのものを変える話で、本文で扱う方法ではありません。
→ Level 5「計算量とメモリの構造」に戻る
Q3.【オリジナル】回転による位置表現の説明として、最も適切なものはどれか。
- ア トランスフォーマーは位置の情報を必要としないため、位置表現は補助的な飾りにすぎない
- イ 学習時の何倍の長さでも、追加の学習なしに性能が落ちない
- ウ 相対的な位置関係を表現でき、ある程度の外挿が可能である
- エ 位置ごとの値を表として覚える方式なので、学習時より長い系列にはまったく使えない
正解:ウ
解説:
相対的な位置関係を表現できる点が利点です。
アは誤りです。トランスフォーマーは、位置の情報を明示的に与える必要があります。
イは誤りです。学習時の長さを大きく超えると、注意の分布が崩れて性能が落ちます。長さを伸ばす手法も、少量の長文データでの追加学習と併用するのが一般的です。
エは誤りです。回転による位置表現は、表として覚える方式ではありません。
→ Level 5「位置表現と外挿」に戻る
Q4.【オリジナル】「タイル単位で計算し、中間結果を高帯域メモリに書き戻さない」方式の説明として、最も適切なものはどれか。
- ア 注意を向ける範囲を、近くの局所的な窓に限定する近似である
- イ 一定の間隔ごとに疎に接続して、計算量を下げる近似である
- ウ 少数の大域的なトークンだけに、すべての位置から注意を向ける近似である
- エ 近似を入れず、正確な注意のまま、メモリへのアクセスを減らして高速化する
正解:エ
解説:
計算量を下げる近似とは別の方向で、計算の結果は正確な注意と同じです。
ア、イ、ウは、いずれも注意の範囲を制限する近似の構成です。長距離の依存関係を取りこぼす危険があります。
→ Level 5「注意の近似」に戻る
Q5.【オリジナル】あるモデルが、長い文脈の中に埋め込んだ1つの情報を取り出す評価で、どの位置でも高い得点を出した。この結果の読み方として、最も適切なものはどれか。
- ア 位置による差は見えるが、複数の箇所の統合や全体の集約が必要な課題での性能は保証しない
- イ 長い文脈での性能は十分に確かめられたので、実務にそのまま使える
- ウ 公称の上限までの有効な長さが、この評価で確定した
- エ 中間に置いた情報が埋もれる傾向は、すべてのモデルで解消された
正解:ア
解説:
1つの情報を取り出す課題は、比較的易しい課題です。
より厳しい評価として、複数の箇所の情報を統合する課題や、文脈全体の集約が必要な課題があります。
イは誤りです。この評価だけでは、実務での性能は保証されません。
ウは誤りです。易しい課題に合格しただけでは、有効な長さは決まりません。
エは誤りです。1つのモデルの結果から、すべてのモデルについては言えません。
→ Level 5「有効長の評価」に戻る
ここまで読めば言えるようになること
- 計算量とメモリの構造を段階別に説明できる
- 位置表現と外挿の限界を説明できる
- 有効長の評価を設計できる
- 文脈の構成を精度と費用の両面から設計できる
まとめ
コンテキストは、AIが一度に見ていられる範囲です。
Level 1では、机の広さ。
Level 2では、トークン数で決まる上限と、その消費先。
Level 3では、計算量とメモリの制約から生じる限界。
Level 4では、配分と履歴の扱いを設計する対象。
Level 5では、位置表現と注意の実装が規定する有効長。
上限が大きくなっても、「全部入れる」が最適になるわけではありません。
必要な部分に絞るという原則は、どのレベルでも変わりません。
次に読む記事
→ トークンとは|AIの料金と文字数制限を決める単位
→ RAGとは|5段階でわかる用語解説
→ AIの「推論」とは|5段階でわかる用語解説
→ 今さら聞けないAI用語30選
よくある質問(FAQ)
Q. コンテキストとは何ですか?
A. AIが1回の処理で見ていられる範囲のことです。その上限をコンテキストウィンドウと呼び、トークン数で表されます。
Q. 会話が長くなると前提を忘れるのはなぜですか?
A. 上限を超えて古い部分が入力から外れるためです。モデルが忘れたのではなく、そもそも渡されていない状態になっています。
Q. 上限が大きいモデルなら、資料を全部入れればよいですか?
A. 入れた分だけ費用がかかるうえ、長い文脈の中間に置かれた情報は使われにくくなる傾向があります。必要な部分に絞るほうが精度も費用も改善する場面が多くなります。
Q. コンテキストとAIの記憶は同じものですか?
A. 違います。コンテキストは毎回入力として送り直しているもので、モデルの中身は変わりません。会話をまたいで覚える機能は、要点を保存して次の入力に差し込む別の仕組みです。
Q. 長い文書を扱うにはどうすればよいですか?
A. 全文を入力するのではなく、文書を分割して検索し、関連する部分だけを入力に含める方式(RAG)が精度と費用の両面で優れます。
用語の全体像はこちらで確認できます。 → 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報