ディープラーニングは、2010年代以降のAIの精度向上をほぼ一手に担ってきた手法です。
機械学習の一種でありながら、それ以前の機械学習とは決定的に違う点が一つあります。
この記事では、その違いを軸に、説明を5つのレベルに分けて並べました。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(8分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(10分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(10分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で読み終えられます。
1分で腕試し
理解度から決めたい場合は、次の4問を試してください。
Q1〜Q4は、Level 1〜4の内容に1問ずつ対応しています。
最初にまちがえた問題のLevelが、あなたのスタート地点です。
4問とも正解なら、Level 5から読んでください。
各レベルの終わりにも、4択の理解度チェックがあります。
ITパスポート試験の過去問題も入れています。
機械学習という言葉で止まる場合は、先にこちらを読むと入りやすくなります。
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
Q1.【オリジナル】ディープラーニングが、それまでの機械学習と最も大きく違う点はどれか。
- ア 答えのついた例を見せなくても、自然に賢くなる
- イ 人間が書いたルールを、そのまま速く実行する
- ウ どこに注目すれば見分けられるかまで、コンピュータが自分で見つける
- エ 一度覚えたことを、二度と間違えない
正解:ウ
解説:
それまでは「耳の形を見なさい」のように、注目する場所を人間が教えていました。
ディープラーニングは、その注目する場所まで自分で見つけます。
アは誤りです。たくさんの例を見せることは、ディープラーニングでも必要です。
イは、ルールを書くこれまでのプログラムの説明です。
エは誤りです。ディープラーニングも間違えます。
→ まちがえたら Level 1から
Q2.【オリジナル】機械学習で「特徴量」と呼ばれるものの説明として、最も適切なものはどれか。
- ア 学習に使ったデータの件数
- イ データのどの項目に注目させるかを決めたもの
- ウ 学習にかかった計算の時間
- エ 学習したモデルの正解率
正解:イ
解説:
ディープラーニング以前は、この特徴量を人間が設計していました。
画像なら、輪郭の強さや色の分布といった数値です。
ア、ウ、エは、どれも学習の規模や結果を表す数字で、特徴量ではありません。
→ まちがえたら Level 2から
Q3.【オリジナル】誤差逆伝播法は、学習のどの場面で使われるか。
- ア 正解と出力のずれを、層をさかのぼって分配し、重みをどちらへ動かせばよいかを求める場面
- イ 学習に使う写真を、インターネットから集める場面
- ウ 学習が終わったモデルを、利用者に配る場面
- エ データに正解のラベルを付ける場面
正解:ア
解説:
出力側で生じたずれを、入力側へ向かって層ごとに分配する計算です。
この計算方法があるので、層を深くしても学習が進みます。
イとエは学習の前の準備で、ウは学習の後の話です。
→ まちがえたら Level 3から
Q4.【オリジナル】顧客の属性と取引履歴からなる表形式のデータで、解約しそうな顧客を予測したい。最初の進め方として、最も適切なものはどれか。
- ア 最新のディープラーニングを前提に、開発を発注する
- イ 層をできるだけ深くしたモデルを作る
- ウ 表形式のデータはAIでは扱えないので、人手の集計を続ける
- エ 勾配ブースティング決定木で基準線を作り、それを上回れるかでディープラーニングの採否を決める
正解:エ
解説:
表形式のデータでは、勾配ブースティング決定木がディープラーニングと同等以上になることがよくあります。
アは、要否を確かめずに前提にすると、費用も期間も過剰になります。
イは誤りです。深さは目的ではなく手段です。
ウは誤りです。表形式のデータは、機械学習が得意とする形です。
→ まちがえたら Level 4から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
機械学習という言葉で止まる場合は、先にこちらを読むと入りやすくなります。
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:ディープラーニングを「どこに注目すればいいかまで、自分で見つける学び方」だと言える
何に注目するかを、自分で見つける
機械学習の解説で、ネコの写真をたくさん見せると当てられるようになる、という話をしました。
そのとき、人間が「耳の形を見なさい」「ひげの数を数えなさい」と教える方法もあります。
でも、人間が教えられることには限りがあります。
自分でもうまく説明できないものは、教えようがありません。
ディープラーニングは、そこを自分でやります。
「どこに注目すれば見分けられるか」まで、コンピュータが自分で見つけられるようになるのです。
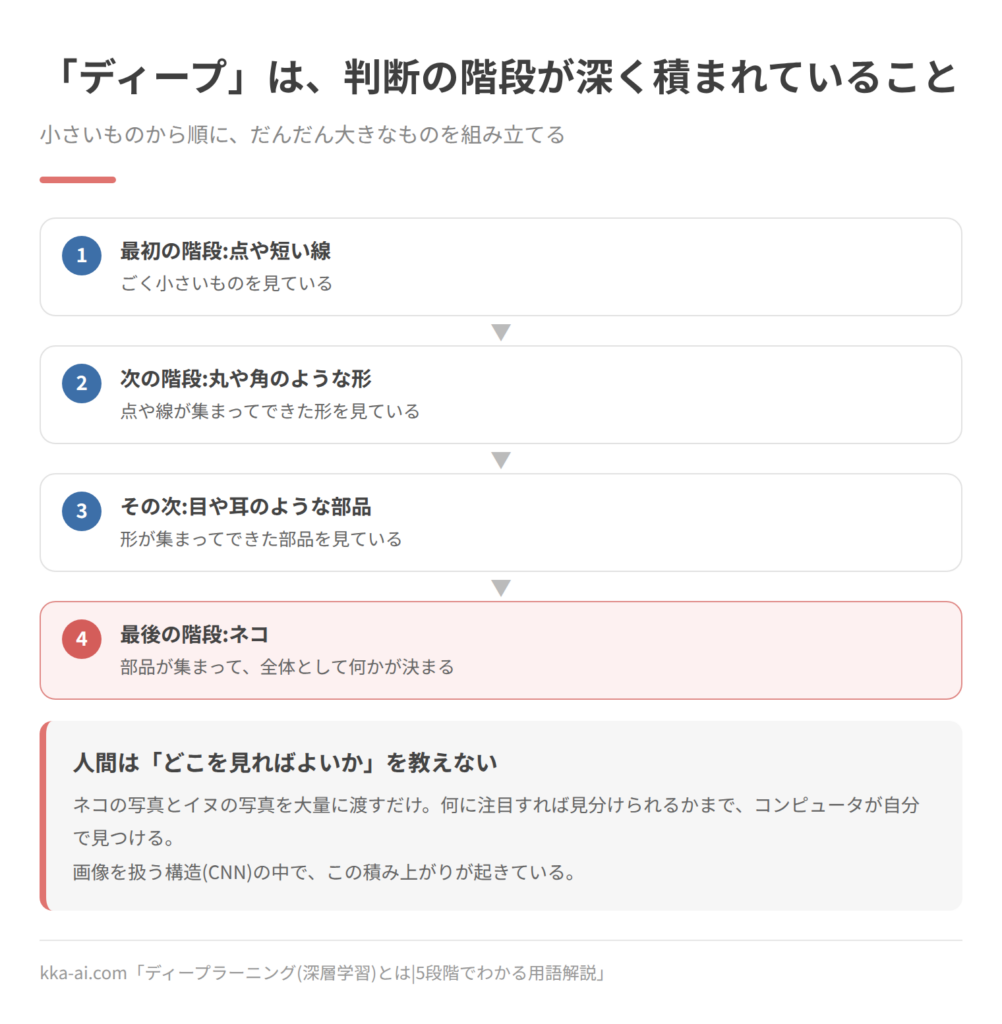
人間はただ、ネコの写真とイヌの写真を大量に渡すだけです。
少しずつ、細かいものから大きいものへ
ディープラーニングという名前は、「深い」という意味の英語から来ています。
何が深いのかというと、判断のための階段がたくさん重なっているところです。
写真を見分けるとき、最初の階段では、点や短い線のようなごく小さいものを見ています。
次の階段では、それが集まってできた丸や角のような形を見ています。
その次では、目や耳のような部品を見ています。
そして最後の階段で、それが集まってネコになります。
小さいものから順に、だんだん大きなものを組み立てていく。
この階段が深く積まれているから、ディープと呼ばれています。
できるようになったこと
この方法が使えるようになって、それまで難しかったことが一気にできるようになりました。
- スマホが顔を見てロックを解除する
- 話しかけた言葉を文字にする
- 外国語をその場で訳す
- 車が人や標識を見つける
どれも、何に注目すればよいかを人間が説明しにくいものばかりです。
つまずきポイント
「機械学習とはちがうもの?」
ちがいません。
ディープラーニングは、機械学習の中の一つのやり方です。
機械学習という大きな箱の中に、ディープラーニングが入っています。
ここがあやふやなら、機械学習の記事のLevel 1に戻ってください。
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
理解度チェック
Q1.【オリジナル】ディープラーニングの学び方の説明として、最も適切なものはどれか。
- ア 人間が「耳の形を見なさい」と注目する場所を一つずつ教える
- イ ネコとイヌの写真を大量に渡すと、どこに注目すれば見分けられるかを自分で見つける
- ウ 1枚の写真をじっくり見るだけで、すべてのネコを見分けられるようになる
- エ インターネットで「ネコ」と検索して、答えをそのまま持ってくる
正解:イ
解説:
人間がするのは、写真を大量に渡すことだけです。
注目する場所は、コンピュータが自分で見つけます。
アは、ディープラーニングより前のやり方です。
ウは誤りです。たくさんの例が必要です。
エは、検索の説明です。
→ Level 1「何に注目するかを、自分で見つける」に戻る
Q2.【オリジナル】ディープラーニングの「ディープ(深い)」は、何が深いことを指しているか。
- ア 学習に使った写真の枚数がとても多いこと
- イ 動かしているコンピュータが、地下の深い場所にあること
- ウ 考えている時間がとても長いこと
- エ 判断のための階段が、何段も重なっていること
正解:エ
解説:
小さいものから大きいものへ、判断の階段が深く積まれているので「ディープ」と呼ばれます。
アの写真の多さは大事ですが、名前の由来ではありません。
イとウは、名前とは関係がありません。
→ Level 1「少しずつ、細かいものから大きいものへ」に戻る
Q3.【オリジナル】写真を見分けるときの階段の順番として、最も適切なものはどれか。
- ア 点や短い線 → 丸や角のような形 → 目や耳のような部品 → ネコ
- イ ネコ → 目や耳のような部品 → 丸や角のような形 → 点や短い線
- ウ 目や耳のような部品 → 点や短い線 → ネコ → 丸や角のような形
- エ どの階段も、最初から写真全体だけを見ている
正解:ア
解説:
最初の階段では、点や線のようなごく小さいものを見ています。
上の階段にいくほど、それが集まった大きなものを見るようになります。
イは順番が逆です。
ウは順番がばらばらです。
エは誤りです。階段ごとに見ているものの大きさが違います。
→ Level 1「少しずつ、細かいものから大きいものへ」に戻る
Q4.【オリジナル】ディープラーニングと機械学習の関係として、最も適切なものはどれか。
- ア ディープラーニングは、機械学習とはまったく別の技術である
- イ 機械学習は、ディープラーニングの中の一つのやり方である
- ウ ディープラーニングは、機械学習の中の一つのやり方である
- エ ディープラーニングが登場したので、機械学習はもう使われていない
正解:ウ
解説:
機械学習という大きな箱の中に、ディープラーニングが入っています。
アは誤りです。別のものではありません。
イは、箱の内と外が逆です。
エは誤りです。ディープラーニング以外の機械学習も、今も広く使われています。
→ Level 1「つまずきポイント」に戻る
Q5.【オリジナル】本文で、ディープラーニングでできるようになったことの例として挙げていないものはどれか。
- ア スマホが顔を見てロックを解除する
- イ 話しかけた言葉を文字にする
- ウ 車が人や標識を見つける
- エ 電卓が足し算をする
正解:エ
解説:
本文の例は、どれも「何に注目すればよいかを人間が説明しにくいもの」です。
電卓の足し算は、決まった計算の手順をそのまま実行するもので、ディープラーニングは使っていません。
ア、イ、ウは、本文で挙げた例です(ほかに、外国語をその場で訳す)。
→ Level 1「できるようになったこと」に戻る
ここまで読めば言えるようになること
- ディープラーニングは注目する場所まで自分で見つける手法だと説明できる
- 「深い」が階段の多さを指すと説明できる
- 身の回りの例を2つ挙げられる
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(注目する場所を自分で見つける手法)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:ニューラルネットワークという言葉を使って、ディープラーニングの位置づけを説明できる
脳をヒントにした仕組み
ディープラーニングの土台にあるのが、ニューラルネットワークです。
人間の脳にある神経細胞のつながり方をヒントにした計算の仕組みで、名前もそこから来ています。
仕組みは意外と単純です。
数値を受け取り、それぞれに重みを掛けて足し合わせ、その結果を次に渡す。
この単純な計算をする個々の部品である素子を大量に並べ、層状につないだものがニューラルネットワークです。
層の数を増やして深くしたものが、ディープラーニングです。
つまりディープラーニングは、まったく新しい発明というより、以前からあった仕組みを深くできるようになったものだと言えます。
深くできるようになった理由
ニューラルネットワーク自体は、1980年代にはすでに研究されていました。
それが2010年代まで主役になれなかったのは、深くすると学習がうまくいかなかったからです。
これが変わったのには、3つの理由があります。
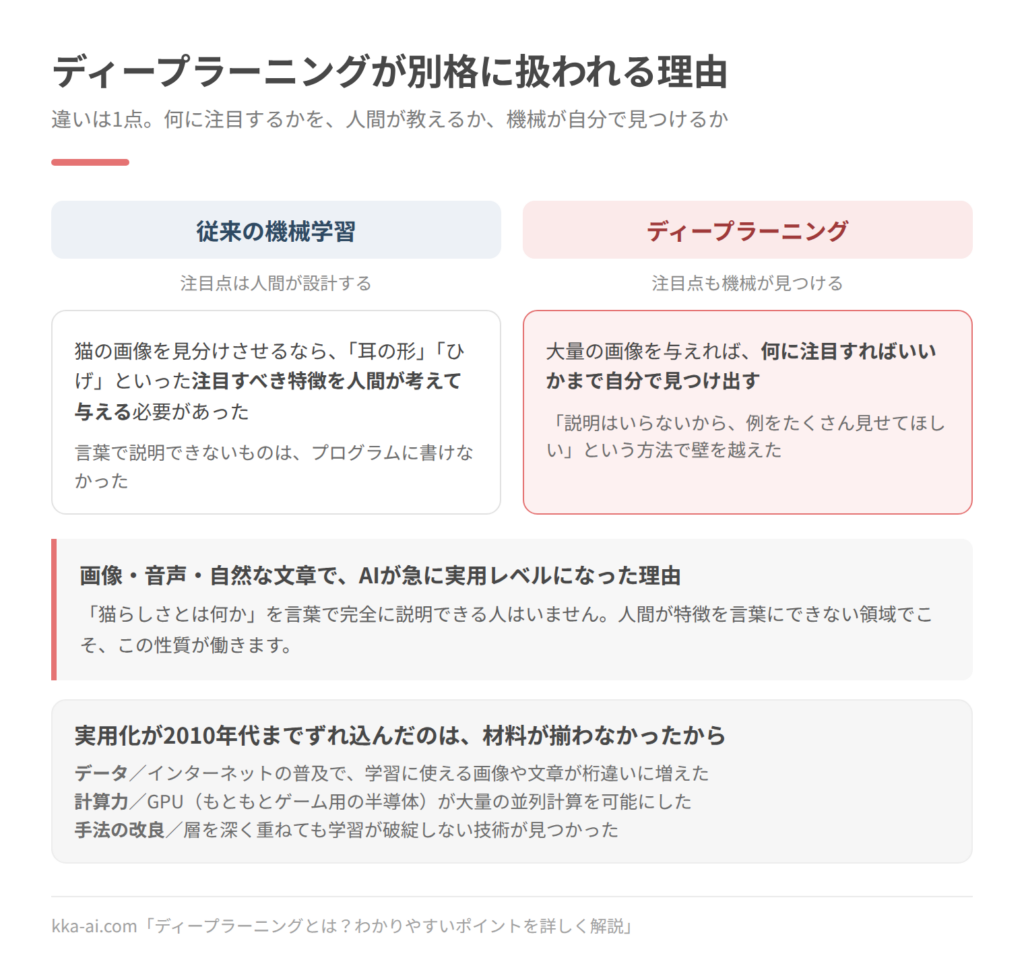
一つ目は、学習に使えるデータがインターネットの普及で桁違いに増えたこと。
二つ目は、GPUという画像処理用の計算装置が、大量の計算を安くこなせると分かったこと。
そして、三つ目は、深い層でも学習が進むようにする技術的な工夫が積み重なったことです。
2012年、画像認識の国際的なコンテストでディープラーニングを使ったチームが圧勝したことが、流れが変わった象徴的な出来事としてよく挙げられます。
このチームの一人、ジェフリー・ヒントンは、2024年にノーベル物理学賞を受けています(→ AIとノーベル賞)。
特徴量を人間が決めなくてよくなった
Level 1で「注目する場所を自分で見つける」と書いた部分を、正確な言葉にしておきます。
機械学習では、データのどの項目に注目させるかを決める必要があり、この項目を特徴量と呼びます。
ディープラーニング以前は、この特徴量の設計が人間の仕事でした。
画像なら、輪郭の強さや色の分布といった数値を人間が設計して与えていたのです。
ディープラーニングは、この特徴量の設計までを学習の中に取り込みました。
生の画像や音声をそのまま入力すれば、有効な特徴を層の中で自動的に作り出します。
この違いが、画像、音声、言語という、人間が特徴を言語化しにくい領域での圧倒的な性能差につながりました。
生成AIとの関係
ChatGPTのような生成AIも、ディープラーニングで作られています。関係は入れ子です。
AIという総称の中に機械学習があり、その中にディープラーニングがあり、その技術で作られたものの一つが生成AIです。
→ AIとは何か|子供向けから専門的な話まで5段階でわかる用語解説
理解度チェック
Q1.【IPA過去問】ディープラーニングに関する記述として,最も適切なものはどれか。
- ア インターネット上に提示された教材を使って,距離や時間の制約を受けることなく,習熟度に応じて学習をする方法である。
- イ コンピュータが大量のデータを分析し,ニューラルネットワークを用いて自ら規則性を見つけ出し,推論や判断を行う。
- ウ 体系的に分類された特定分野の専門的な知識から,適切な回答を提供する。
- エ 一人一人の習熟度,理解に応じて,問題の難易度や必要とする知識,スキルを推定する。
出典:令和4年度 ITパスポート試験 公開問題 問67
正解:イ
解説:
ディープラーニングは、ニューラルネットワークを使って、データから規則性を自分で見つけ出す手法です。
アは、インターネットを使った学習(eラーニング)の説明です。
ウは、専門家の知識をルールとして書き込む仕組み(エキスパートシステム)の説明です。
エは、学習者ごとに内容を合わせる仕組み(アダプティブラーニング)の説明です。
「ラーニング」という言葉が入っていても、人が学ぶ話と機械が学ぶ話は別です。
→ Level 2「脳をヒントにした仕組み」に戻る
Q2.【オリジナル】ニューラルネットワークが2010年代に主役になった理由として、本文で挙げた3つに含まれないものはどれか。
- ア 学習に使えるデータが、インターネットの普及で大きく増えた
- イ GPUで、大量の計算を安くこなせると分かった
- ウ 深い層でも学習が進むようにする技術的な工夫が積み重なった
- エ 特徴量を人間が細かく設計する手法が確立した
正解:エ
解説:
エは逆です。ディープラーニングは、特徴量の設計を人間の手から学習の中へ移しました。
ア、イ、ウは、本文で挙げた3つの理由です。
データ、計算装置、学習の工夫の3つがそろって、深くしても学習が進むようになりました。
→ Level 2「深くできるようになった理由」に戻る
Q3.【オリジナル】特徴量について、ディープラーニングとそれ以前の機械学習の違いを説明したものとして、最も適切なものはどれか。
- ア 以前は人間が特徴量を設計していたが、ディープラーニングは有効な特徴を層の中で自動的に作り出す
- イ 以前は特徴量が不要だったが、ディープラーニングでは人間が設計しなければならなくなった
- ウ ディープラーニングは特徴量を使わず、学習データを丸ごと記憶して答える
- エ 特徴量は画像だけの考え方で、音声や文章には当てはまらない
正解:ア
解説:
画像なら、輪郭の強さや色の分布を人間が数値として設計していました。
ディープラーニングは、その設計を学習の中に取り込みました。
イは、向きが逆です。
ウは誤りです。丸ごと記憶するだけでは、未知のデータに答えられません。
エは誤りです。人間が特徴を言葉にしにくい音声や文章ほど、差が大きく出ました。
→ Level 2「特徴量を人間が決めなくてよくなった」に戻る
Q4.【オリジナル】AI、機械学習、ディープラーニング、生成AIの関係として、最も適切なものはどれか。
- ア 4つは互いに独立した別の技術で、目的に応じてどれか1つを選ぶ
- イ 生成AIの中に機械学習があり、機械学習の中にディープラーニングがある
- ウ AIの中に機械学習があり、その中にディープラーニングがあり、その技術で作られたものの一つが生成AIである
- エ ディープラーニングの中にAIがあり、AIの中に生成AIと機械学習がある
正解:ウ
解説:
入れ子の関係です。
ディープラーニングは学習の手法の名前で、生成AIは「作り出す」という目的の名前なので、対立しません。
アは誤りです。生成AIもディープラーニングで作られています。
イは、内と外が逆です。いちばん外側はAIです。
エは誤りです。いちばん外側がAIなので、ディープラーニングの中にAIは入りません。
→ Level 2「生成AIとの関係」に戻る
Q5.【オリジナル】ニューラルネットワークの1つの素子が行っている計算として、最も適切なものはどれか。
- ア 数値を受け取り、それぞれに重みを掛けて足し合わせ、その結果を次に渡す
- イ 受け取った数値をそのまま記録し、計算はしない
- ウ 受け取った文章の意味を理解して、要約を作る
- エ 正解のラベルを自分で考えて、データに付ける
正解:ア
解説:
1つの素子の計算は、意外と単純です。
この単純な素子を大量に並べ、層状につないだものがニューラルネットワークです。
イは誤りです。重みを掛けて足し合わせる計算をしています。
ウは、ネットワーク全体として見たときの働きで、1つの素子の計算ではありません。
エは、人間が行うラベル付けの説明です(Level 4で扱います)。
→ Level 2「脳をヒントにした仕組み」に戻る
つまずきポイント
「ディープラーニングと生成AIの違いは?」
種類の違いではなく、指しているものの違いです。
ディープラーニングは学習の手法の名前で、生成AIは作り出すという目的の名前です。
「ディーゼルエンジン」と「トラック」を比べるようなもので、対立しません。
ここまで読めば言えるようになること
- ニューラルネットワークの仕組みを説明できる
- 2010年代に主役になれた理由を3つ挙げられる
- 特徴量という言葉で、それ以前の機械学習との違いを説明できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(ニューラルネットワーク、特徴量)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:学習の進み方を説明でき、データの種類に応じた代表的な構造を区別できる
どうやって学習が進むのか
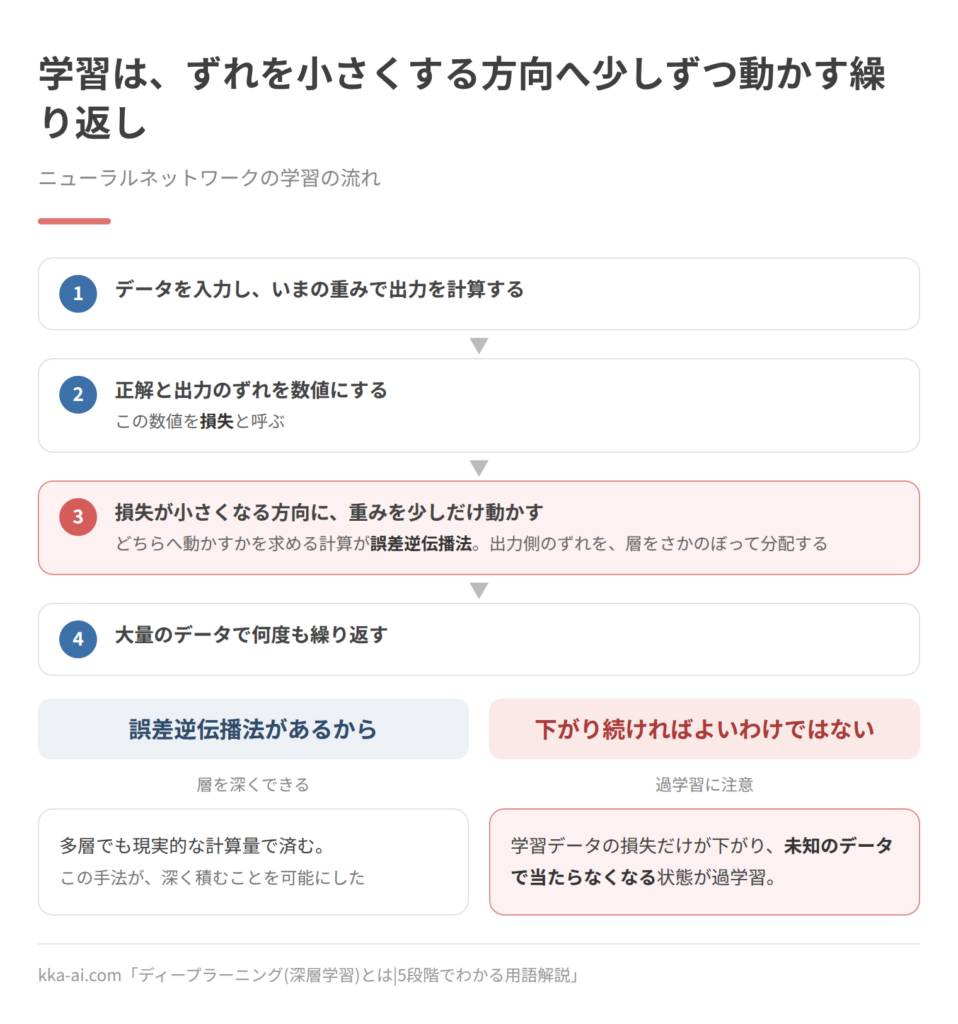
ニューラルネットワークの学習は、次の繰り返しです。
- データを入力し、現在の重みで出力を計算する
- 正解と出力のずれを数値にする(この数値を損失と呼びます)
- 損失が小さくなる方向に、重みを少しだけ動かす
- これを大量のデータで何度も繰り返す
3の「どちらへ動かせば損失が小さくなるか」を求める計算が、誤差逆伝播法です。
出力側で生じたずれを、入力側へ向かって層をさかのぼりながら分配していく方法で、多層でも現実的な計算量で済みます。
この手法があるから、層を深くできます。
学習が進むにつれて損失は下がっていきますが、下がり続ければよいというものではありません。
学習データの損失だけが下がり、未知のデータで当たらなくなる状態が過学習です。
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
データの種類に応じた構造がある
ディープラーニングには、扱うデータに合わせた代表的な構造があります。
畳み込みニューラルネットワーク(CNN)は、画像を扱うための構造です。
画像の小さな領域ごとに同じフィルタを滑らせて特徴を取り出すため、位置が少しずれても同じものだと捉えられます。
Level 1で書いた「点や線から、形、部品、全体へ」という積み上がりは、この構造の中で起きています。
再帰型ニューラルネットワーク(RNN)は、時系列や文章のように順序のあるデータを扱う構造です。
前の時点の状態を次に渡しながら順番に処理します。
長い系列で情報が薄れる弱点があり、それを緩和したLSTMなどが使われてきました。
トランスフォーマーは、2017年に登場した構造です。
順番に処理する代わりに、系列内のどの位置とどの位置が関係しているかを直接扱います。
並列に処理できるため大規模化と相性がよく、現在のLLMの土台になっています。
→ LLM(大規模言語モデル)とは|5段階でわかる用語解説
大量のデータが要る、という制約への対処
ディープラーニングは、一般に大量の学習データを必要とします。
自社で数万件のラベル付きデータを用意するのは、多くの場合現実的ではありません。
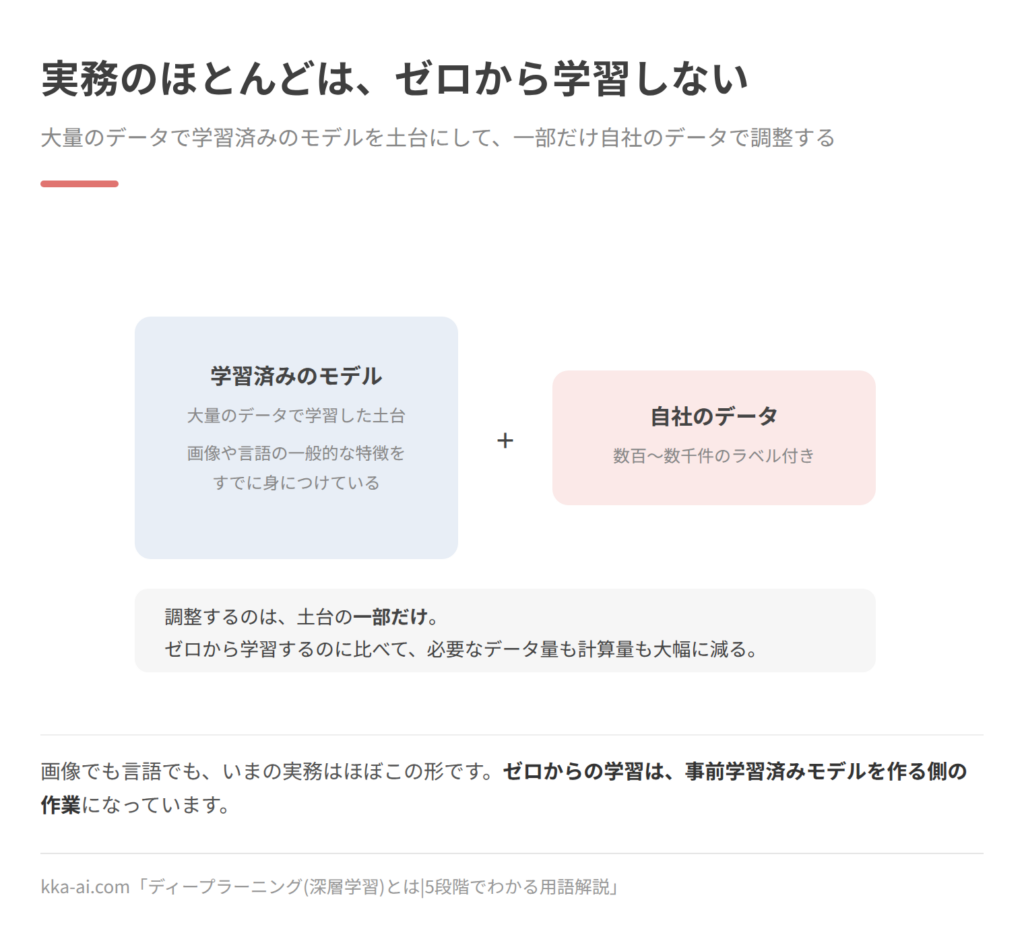
そこで実務で使われるのが転移学習です。
大量のデータで学習済みのモデルを土台にし、その一部だけを自社のデータで調整します。
ゼロから学習するのに比べて、必要なデータ量も計算量も大幅に減ります。
画像でも言語でも、現在の実務はほぼこの形です。
ゼロから学習するのは、事前学習済みモデルを作る側の作業になっています。
中身が説明しにくいという性質
ディープラーニングのモデルは、なぜその答えを出したのかを人間が追いにくい構造をしています。
数億の重みが相互に作用した結果なので、特定の判断の理由を一つの規則として取り出せません。
この性質はブラックボックス問題と呼ばれ、判断の理由を説明する義務がある業務では制約になります。
判断に影響した入力の箇所を可視化する手法などが研究されていますが、規則として説明できるわけではありません。
つまずきポイント
「層を深くすれば精度は上がるのでは?」
上がりません。
深くすると学習が不安定になり、必要なデータ量と計算量も増えます。
また、表形式のデータでは、そもそも勾配ブースティング決定木のほうが強いことがよくあります。
深さは目的ではなく、扱うデータの性質に対する手段です。
理解度チェック
Q1.【IPA過去問】画像認識システムにおける機械学習の事例として,適切なものはどれか。
- ア オフィスのドアの解錠に虹彩の画像による認証の仕組みを導入することによって,セキュリティが強化できるようになった。
- イ 果物の写真をコンピュータに大量に入力することで,コンピュータ自身が果物の特徴を自動的に抽出することができるようになった。
- ウ スマートフォンが他人に利用されるのを防止するために,指紋の画像認識でロック解除できるようになった。
- エ ヘルプデスクの画面に,システムの使い方についての問合せを文字で入力すると,会話形式で応答を得ることができるようになった。
出典:令和3年度 ITパスポート試験 公開問題 問20
正解:イ
解説:
「大量に入力」「特徴を自動的に抽出」が、機械学習、とくにディープラーニングの考え方そのものです。
アとウは、画像を使った本人確認(生体認証)の事例で、機械学習を使っているかは問題文から読み取れません。
エは、文章でやり取りするチャットボットの事例で、画像認識ではありません。
選択肢に「画像」が出てくるかではなく、「データから特徴を自分で取り出しているか」で選びます。
→ Level 2「特徴量を人間が決めなくてよくなった」に戻る
Q2.【オリジナル】ニューラルネットワークの学習で、正解と出力のずれを表す数値を何と呼ぶか。
- ア 重み
- イ 特徴量
- ウ 損失
- エ ラベル
正解:ウ
解説:
学習は、この損失が小さくなる方向に、重みを少しずつ動かす作業の繰り返しです。
アの重みは、損失を小さくするために動かす側の数値です。
イの特徴量は、データのどこに注目するかを表したものです。
エのラベルは、学習データに付けた正解そのものです。損失は、ラベルと出力のずれを数値にしたものです。
→ Level 3「どうやって学習が進むのか」に戻る
Q3.【オリジナル】誤差逆伝播法の説明として、最も適切なものはどれか。
- ア 入力側から出力側へ順に計算し、現在の重みで出力を求める方法
- イ 学習データに回転や切り出しを加えて、データの量を増やす方法
- ウ 学習済みのモデルを土台にして、一部だけを自社のデータで調整する方法
- エ 出力側で生じたずれを、層をさかのぼりながら入力側へ分配し、各重みをどちらへ動かせばよいかを求める方法
正解:エ
解説:
この方法があるので、層を深くしても現実的な計算量で学習できます。
アは、出力を計算する手順です。誤差逆伝播法は、その後で重みの動かし方を求める手順です。
イは、データ拡張の説明です(Level 5で扱います)。
ウは、転移学習の説明です。
→ Level 3「どうやって学習が進むのか」に戻る
Q4.【オリジナル】扱うデータと、ディープラーニングの代表的な構造の組み合わせとして、最も適切なものはどれか。
- ア 画像はCNN、順序のあるデータはRNN、現在のLLMの土台はトランスフォーマーである
- イ 画像はRNN、文章はCNNが向いている
- ウ トランスフォーマーは1つずつ順番に処理するため、並列に計算できない
- エ CNNは、対象の位置が少しずれると別のものと判断しやすい
正解:ア
解説:
画像はCNN、時系列や文章のように順序のあるデータはRNN、そして現在のLLMはトランスフォーマーで作られています。
イは、組み合わせが逆です。
ウは誤りです。順番に処理するのはRNNで、トランスフォーマーは並列に処理できるため、大規模化と相性がよい構造です。
エは誤りです。CNNは小さな領域ごとに同じフィルタを滑らせるので、位置が少しずれても同じものだと捉えられます。
→ Level 3「データの種類に応じた構造がある」に戻る
Q5.【オリジナル】転移学習の説明として、最も適切なものはどれか。
- ア 学習したモデルを、別の会社のサーバーへ移して動かすこと
- イ 使いながら、利用者との会話の内容で少しずつ学習を続けること
- ウ 大量のデータで学習済みのモデルを土台にし、その一部だけを自社のデータで調整すること
- エ 学習したモデルから判断の規則を取り出し、人間が読める形にすること
正解:ウ
解説:
ゼロから学習するのに比べて、必要なデータ量も計算量も大きく減ります。
画像でも言語でも、いまの実務はほぼこの形です。
アは、置き場所を移す話で、学習とは関係ありません。
イは誤りです。転移学習は、利用中の会話で学び続ける仕組みではありません。
エは誤りです。ディープラーニングのモデルからは、判断の理由を規則として取り出せません。これがブラックボックス問題です。
→ Level 3「大量のデータが要る、という制約への対処」に戻る
ここまで読めば言えるようになること
- 損失と誤差逆伝播法で学習の進み方を説明できる
- CNN、RNN、トランスフォーマーの使い分けを言える
- 転移学習が必要な理由を説明できる
- ブラックボックス問題が制約になる場面を挙げられる
仕事で導入判断をする立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(学習の進み方、CNNとトランスフォーマー、転移学習)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:自社の課題にディープラーニングが要るかどうかを判断できる
まず、要らない可能性を検討する
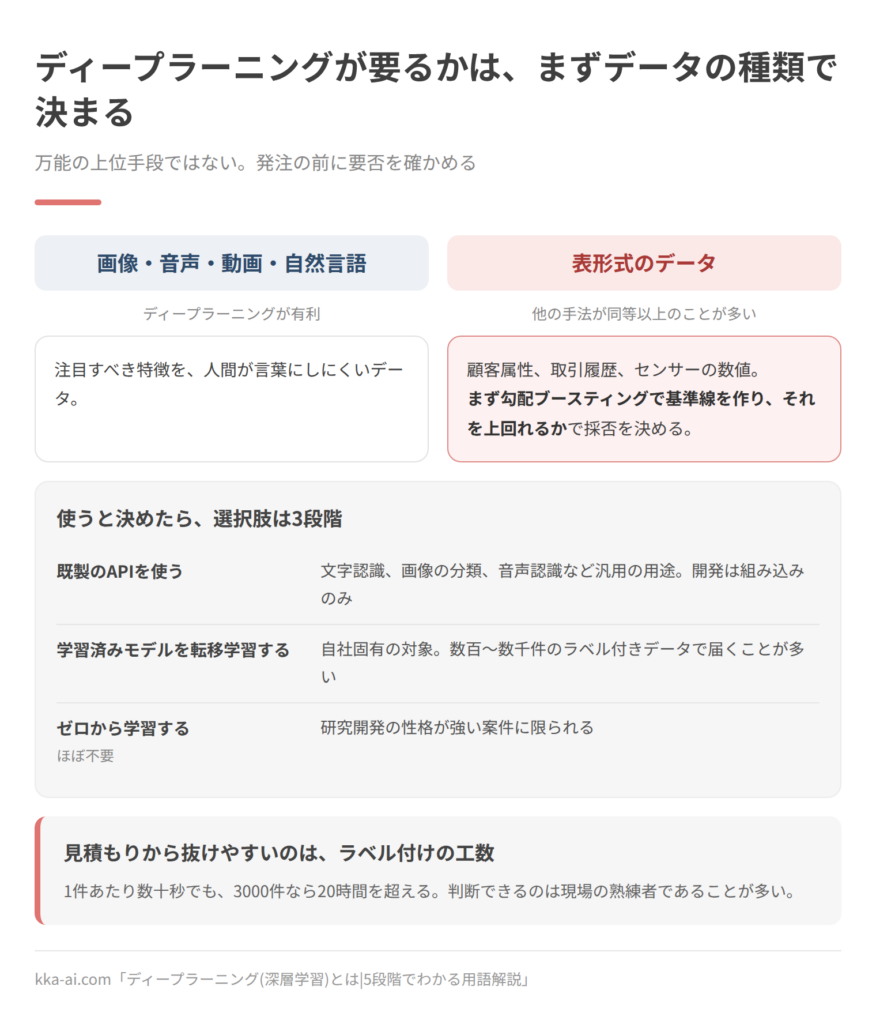
ディープラーニングは万能の上位手段ではありません。
発注や企画の場面で最初にすべきなのは、それが本当に必要かの確認です。
判断の目安は、データの種類です。
- 画像、音声、動画、自然言語:ディープラーニングが有利
- 表形式のデータ(顧客属性、取引履歴、センサーの数値):勾配ブースティング決定木が同等以上のことが多い
表形式で件数が数千から数万件なら、まず勾配ブースティングで基準線を作り、それを上回れるかで採否を決める進め方が堅実です。
この確認をせずにディープラーニングを前提に発注すると、費用も期間も過剰になります。
自前で学習するか、既製のものを使うか
画像や言語を扱う場合でも、選択肢は段階的です。
- 既製のAPIを使う:文字認識、画像の分類、音声認識など、汎用の用途は各社のAPIで済みます。従量課金で、開発は組み込みのみ
- 学習済みモデルを転移学習する:自社固有の対象(自社製品の欠陥、業界特有の帳票)を扱う場合。数百から数千件のラベル付きデータで届くことが多い
- ゼロから学習する:ほぼ不要です。研究開発の性格が強い案件に限られます
多くの案件は上の2つで足ります。
発注時に、どの段階を前提とした見積もりかを確認してください。
ラベル付けの工数を見落とさない
転移学習でも、自社のデータにラベルを付ける作業は必要です。
画像に欠陥の位置を囲む、文書の項目を指定する、といった作業を、判断できる人が行います。
この工数は、しばしば見積もりから抜け落ちます。
1件あたり数十秒でも、3000件なら20時間を超えます。
しかも判断できるのは現場の熟練者であることが多く、その人の時間が最も貴重です。
ラベル付けの基準を先に文書にしておくと、作業のばらつきが減り、後の精度も安定します。
複数人で付ける場合は、同じデータを重複して付けて一致率を測るのが定石です。
精度は業務の指標に翻訳する
モデルの精度は、そのままでは判断材料になりません。
検査の自動化なら、次のように翻訳します。
- 見逃し率がいくつなら、現在の目視検査と同等か
- 過検出がいくつなら、再確認の工数が許容範囲に収まるか
- 全件を自動化するのか、判断が微妙なものだけ人に回すのか
3つ目の設計、つまり自信のない判定を人に回す形にすると、導入の難度が大きく下がります。
全件の自動化を前提にすると、要求される精度が跳ね上がるためです。
説明義務がある業務では設計が変わる
融資、採用、保険の引受、医療の判断など、結果の理由を示す必要がある業務では、ブラックボックス問題が直接の制約になります。
この場合の設計は2つです。
一つは、説明しやすい手法を選ぶこと。
もう一つは、ディープラーニングを候補の絞り込みに使い、最終判断は人が既存の基準で行う形にすることです。
総務省と経済産業省のAI事業者ガイドライン(第1.2版、令和8年3月31日)は、透明性やアカウンタビリティを含む論点を整理しており、社内規程の骨子として使えます。
別添には、判断のブラックボックス化が実際に問題になった事例も載っています。
つまずきポイント
「学習済みモデルの精度が公開値より低い」
公開されている精度は、そのモデルが学習した領域のデータで測ったものです。
自社の対象は、撮影条件、対象物、業界の言い回しが違います。
自社データで測り直したうえで、転移学習で調整するのが前提の流れになります。
理解度チェック
Q1.【オリジナル】自社製品の外観検査で傷を見つけたい。汎用の画像認識APIを試したところ、自社製品に特有の傷は拾えなかった。次に検討する方法として、最も適切なものはどれか。
- ア 大量の画像を集めて、ゼロからモデルを学習する
- イ 学習済みの画像モデルを土台に、ラベルを付けた自社データ(数百〜数千件)で転移学習する
- ウ 汎用APIの結果をそのまま使い、拾えなかった傷は仕様外として扱う
- エ 文章を作る生成AIに、傷の特徴を文章で説明して判定させる
正解:イ
解説:
自社固有の対象を扱う場合は、既製のAPIの次の段階として転移学習を検討します。
アは、研究開発の性格が強い案件に限られます。ほとんどの案件では不要です。
ウは、課題そのものを諦めることになります。
エは、画像の傷の判定を文章の説明だけに頼るもので、筋がよくありません。
→ Level 4「自前で学習するか、既製のものを使うか」に戻る
Q2.【オリジナル】転移学習のために、自社の画像4,500件にラベルを付ける。1件あたり40秒かかり、判断できるのは現場の熟練者だけである。ラベル付けに必要な時間はおよそ何時間か。
- ア 5時間
- イ 30時間
- ウ 50時間
- エ 75時間
正解:ウ
解説:
4,500件×40秒=180,000秒=3,000分=50時間です。
この工数は見積もりから抜け落ちやすく、しかも熟練者の時間を使います。
アは、分と時間を取り違えると出る数字です。
イは、1件あたり24秒で計算した数字です。
エは、1件あたり60秒で計算した数字です。
→ Level 4「ラベル付けの工数を見落とさない」に戻る
Q3.【オリジナル】画像による検査を自動化するとき、導入の難しさを下げる設計として、最も適切なものはどれか。
- ア すべての判定を自動にし、精度99.9%以上を導入の条件にする
- イ 「精度」という1つの数字だけで、導入するかどうかを決める
- ウ 過検出を出さないように、傷と判定する基準をできるだけ厳しくする
- エ 自信のない判定だけを人に回し、自信の高い判定は自動で処理する
正解:エ
解説:
全件の自動化を前提にすると、要求される精度が跳ね上がります。
判断が微妙なものを人に回す形にすると、導入の難しさが大きく下がります。
アは、全件の自動化を前提にした、いちばん難しい条件の置き方です。
イは誤りです。精度は、見逃し率と過検出に分けて、業務の指標に翻訳してから判断します。
ウは、過検出を減らす代わりに見逃しが増えます。片方だけを見て決めることはできません。
→ Level 4「精度は業務の指標に翻訳する」に戻る
Q4.【オリジナル】融資の審査のように、結果の理由を示す必要がある業務でディープラーニングを使う場合の設計として、最も適切なものはどれか。
- ア ディープラーニングは候補の絞り込みに使い、最終判断は人が既存の基準で行う
- イ 精度がもっとも高いので、ディープラーニングの判定をそのまま結果として通知する
- ウ 判断に影響した入力の箇所を可視化すれば、判断の理由を規則として説明できる
- エ 判断の理由は社外に開示しないので、説明の義務は問題にならない
正解:ア
解説:
説明の義務がある業務での設計は、説明しやすい手法を選ぶか、この選択肢のように役割を分けるかの2つです。
イは、理由を示せないまま結果を出すことになり、ブラックボックス問題がそのまま制約になります。
ウは誤りです。可視化の手法は研究されていますが、規則として説明できるわけではありません。
エは誤りです。理由を示す必要がある業務を前提にした問題です。開示の範囲で義務がなくなるわけではありません。
→ Level 4「説明義務がある業務では設計が変わる」に戻る
Q5.【オリジナル】公開されている学習済みモデルを自社の画像で試したところ、公開値より精度が低かった。この結果の受け止め方として、最も適切なものはどれか。
- ア 公開値はそのモデルが学習した領域で測ったものなので、自社データで測り直し、転移学習で調整する前提で進める
- イ 公開値が誤っているので、そのモデルは使わない
- ウ 撮影する機材を公開値と同じものに替えれば、必ず同じ精度になる
- エ ディープラーニングは自社の画像には向かないと判断して、検討をやめる
正解:ア
解説:
自社の対象は、撮影条件、対象物、業界の言い回しなどが、公開値を測ったデータと違います。
低く出るのは、よくあることです。
イは誤りです。公開値が誤っているわけではありません。測った条件が違うだけです。
ウは誤りです。機材だけでなく、対象物そのものが違います。
エは早すぎる判断です。転移学習で自社データに合わせるのが、前提の流れです。
→ Level 4「つまずきポイント」に戻る
ここまで読めば言えるようになること
- データの種類から手法の要否を判断できる
- 既製API、転移学習、ゼロ学習の3段階を説明できる
- ラベル付け工数を見積もりに含められる
- 精度を業務の指標に翻訳できる
実装や資格に進むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:深層学習が深くできるようになった技術的経緯を、学習の安定化という観点で整理できる
深さを可能にした要素
深いネットワークの学習を妨げていたのは、主に勾配の伝わり方の問題です。
層をさかのぼるほど勾配が小さくなって学習が止まる勾配消失と、逆に発散する勾配爆発が起きます。
これを緩和した要素が積み重なりました。
活性化関数では、飽和領域で勾配がほぼ消えるシグモイドから、正の領域で勾配が一定になるReLUおよびその派生への移行が大きな効果を上げました。
初期化では、層を通るごとに信号の分散が保たれるよう設計されたXavier初期化やHe初期化が使われます。
正規化では、層の入力の分布を揃えるバッチ正規化や、系列長に依存しない層正規化が学習を安定させます。
構造では、層をまたぐ恒等写像の経路を作る残差接続によって、勾配が浅い層まで届くようになり、100層規模の学習が現実的になりました。
トランスフォーマーは、層正規化と残差接続を前提に自己注意を積む構造であり、これらの蓄積の上に成立しています。
最適化
学習は、損失関数を目的とした確率的最適化として扱われます。
ミニバッチごとに勾配を推定し、更新するのが確率的勾配降下法です。
実務では、勾配の一次と二次のモーメントを用いて学習率を要素ごとに調整するAdam系が既定の選択になります。
一方、汎化性能の観点から、モーメンタム付きSGDに重み減衰を組み合わせた設定が好まれる場面もあります。
重み減衰の実装位置を修正したAdamWは、この文脈で広く使われています。
学習率の設定は結果を大きく左右します。
序盤に徐々に上げるウォームアップと、その後の余弦減衰を組み合わせる形が定番です。
正則化と汎化
深層モデルはパラメータ数が学習データ数を上回ることが多く、古典的な理論では過学習して当然の設定にあります。
それでも汎化する現象は、暗黙的正則化として説明が試みられていますが、決着していません。
実務で使われる正則化は次の通りです。
確率的に素子を無効化するドロップアウト、重みの大きさに罰則を課す重み減衰、学習を検証損失の悪化時点で止める早期終了、そしてデータ拡張です。
画像では回転や切り出し、色調変換が、音声では雑音の重畳が使われます。
データ拡張は、事実上のデータ量増加として最も効果が大きい場合が多くなります。
自己教師あり学習という転換
ラベル付けの費用が制約になるため、ラベルなしデータから学習する枠組みが主流になりました。
言語では、文章の続きを予測する、あるいは伏せた語を当てるという課題を立てることで、ラベルなしのテキストから学習できます。
画像では、同じ画像の異なる変換どうしを近づける対照学習や、伏せた領域を復元する課題が使われます。
事前学習と下流タスクへの適応という現在の枠組みは、この自己教師あり学習によって成立しました。
転移学習が実務の標準になったのも、この流れの帰結です。
効率化
推論の費用を下げる手段は、量子化、枝刈り、蒸留の3つです。
量子化は重みと活性を低ビット幅で表現する手法で、8ビットは多くの用途で精度の低下が小さく、4ビットも用途によって実用に耐えます。
枝刈りは寄与の小さい重みを削る手法で、構造化された単位で削らないと実行速度には反映されにくい点に注意が要ります。
蒸留は、大きなモデルの出力分布を教師として小さなモデルを学習させる手法です。
学習側の効率化では、混合精度学習が標準です。
勾配のスケーリングと併用して、メモリと計算時間を削減します。
進み方
E資格は実装を含む範囲を扱い、この章の内容と対応します。
実装はPyTorchが標準的な入口で、原典はarXivのcs.LGとcs.CVが主な発表先です。
理解度チェック
Q1.【IPA過去問】AIに利用されるニューラルネットワークにおける活性化関数に関する記述として,適切なものはどれか。
- ア ニューラルネットワークから得られた結果を基に計算し,結果の信頼度を出力する。
- イ 入力層と出力層のニューロンの数を基に計算し,中間層に必要なニューロンの数を出力する。
- ウ ニューロンの接続構成を基に計算し,最適なニューロンの数を出力する。
- エ 一つのニューロンにおいて,入力された値を基に計算し,次のニューロンに渡す値を出力する。
出典:令和5年度 ITパスポート試験 公開問題 問91
正解:エ
解説:
活性化関数は、1つのニューロン(素子)の中で、重みを掛けて足し合わせた値を変換し、次に渡す値を決める関数です。
Level 5で扱ったシグモイドやReLUが、その例です。
アは、ネットワーク全体の結果の扱いの話で、1つのニューロンの計算ではありません。
イとウは、ネットワークの形(ニューロンの数)を決める話で、活性化関数の役割ではありません。
→ Level 5「深さを可能にした要素」に戻る
Q2.【オリジナル】活性化関数をシグモイドからReLUに変えたことが、深いネットワークの学習を助けた理由として、最も適切なものはどれか。
- ア シグモイドは0か1のどちらかしか出力しないため、細かい違いを表せないから
- イ ReLUは正の領域で勾配が一定なので、層をさかのぼっても勾配が小さくなりにくいから
- ウ ReLUは負の入力に対しても大きな勾配を持つので、すべての素子が常に学習されるから
- エ シグモイドの微分の最大値は1なので、勾配爆発を起こしやすいから
正解:イ
解説:
シグモイドは、入力の絶対値が大きい領域(飽和領域)で勾配がほぼ0になり、層をさかのぼるほど勾配が小さくなります(勾配消失)。
アは誤りです。シグモイドの出力は、0と1のあいだの連続した値です。
ウは誤りです。ReLUは負の入力に対して、出力も勾配も0です。この弱点を補う派生が作られています。
エは誤りです。シグモイドの微分の最大値は0.25です。問題は勾配爆発ではなく、勾配消失の側です。
→ Level 5「深さを可能にした要素」に戻る
Q3.【オリジナル】残差接続の説明として、最も適切なものはどれか。
- ア 層への入力の分布を、ミニバッチ単位でそろえる
- イ 学習中に、確率的に一部の素子を無効にする
- ウ 大きなモデルの出力分布を教師にして、小さなモデルを学習させる
- エ 層をまたぐ恒等写像の経路を作り、勾配が浅い層まで届くようにする
正解:エ
解説:
残差接続によって、100層規模のネットワークの学習が現実的になりました。
トランスフォーマーも、残差接続と層正規化を前提に自己注意を積む構造です。
アは、バッチ正規化の説明です。
イは、ドロップアウトの説明です。
ウは、蒸留の説明です。
→ Level 5「深さを可能にした要素」に戻る
Q4.【オリジナル】過学習を抑えるための正則化の手段として、適切でないものはどれか。
- ア ドロップアウト
- イ 重み減衰
- ウ 混合精度学習
- エ 早期終了
正解:ウ
解説:
混合精度学習は、メモリと計算時間を減らすための、学習の効率化の手段です。
過学習を抑える目的のものではありません。
アは、学習中に素子を確率的に無効にし、特定の素子への依存を減らします。
イは、重みの大きさに罰則を課します。
エは、検証データでの損失が悪化し始めた時点で学習を止めます。
本文では、このほかにデータ拡張を挙げています。
→ Level 5「正則化と汎化」に戻る
Q5.【オリジナル】推論の費用を下げる手法の説明として、誤っているものはどれか。
- ア 量子化は、重みと活性を低いビット幅で表す手法で、8ビットは多くの用途で精度の低下が小さい
- イ 蒸留は、大きなモデルの出力分布を教師として、小さなモデルを学習させる手法である
- ウ 枝刈りは、個々の重みをばらばらに削れば、削った割合に応じて必ず実行速度が上がる
- エ 量子化は、4ビットでも用途によっては実用に耐える
正解:ウ
解説:
枝刈りは、構造化された単位(まとまった単位)で削らないと、実行速度に反映されにくい点に注意が要ります。
ばらばらに削っても、計算の形が変わらなければ速くなりません。
ア、イ、エは、本文の説明どおりです。
→ Level 5「効率化」に戻る
ここまで読めば言えるようになること
- 勾配消失を軸に、深層化を可能にした要素を並べられる
- Adam系とSGDの使い分けの論点を説明できる
- 正則化の手段を4つ以上挙げられる
- 自己教師あり学習と転移学習の関係を説明できる
説明する側で、つまずいてきたところ
私は前職のシステムエンジニアでの経験を生かして、AI分野の記事を書く仕事をしています。
その経験をもとに、このサイトを個人で立ち上げました。
前職では仕様書を書く側にいたので、正確だが読まれない説明を何度も何度も書きました。
現在の仕事はその逆で、正確さを落とさずにどこまで短くできるかを考えています。
この記事でいちばん伝えるのが大変だと感じたところは、Level 2の「層を重ねると何がよくなるのか」です。
5回書き直して、いまの形になりました。
まとめ
ディープラーニングは、機械学習の中でも、注目すべき特徴の設計まで学習に含めた手法です。
Level 1では、どこを見ればよいかを自分で見つける学び方。
Level 2では、ニューラルネットワークを深く積めるようになったもの。
Level 3では、データの種類に応じた構造を持ち、転移学習を前提に使う手法。
Level 4では、データの種類から要否を判断し、ラベル付け工数まで含めて見積もる対象。
Level 5では、勾配の伝わり方をめぐる工夫の積み重ねの上に成立した技術。
画像、音声、言語で圧倒的に強い一方、表形式のデータでは他の手法に譲る場面が多い。
この見極めが、実務では最も効果があります。
次に読む記事
→ AIとは何か|子供向けから専門的な話まで5段階でわかる用語解説
→ 機械学習とは|仕組みと3つの種類を5段階でわかりやすく解説
→ LLM(大規模言語モデル)とは|5段階でわかる用語解説
→ AIとノーベル賞|2024年に物理学賞と化学賞の2つを受けた研究は何だったのか【2026年版】
→ AIで天気予報はどう変わる?|気象庁と海外のAI気象モデル、ゲリラ雷雨の捉え方、AIに天気を聞くときの注意
→ 今さら聞けないAI用語30選
よくある質問(FAQ)
Q. ディープラーニングとは何ですか?
A. 機械学習の一種で、ニューラルネットワークの層を深く重ねた手法です。注目すべき特徴の設計まで学習の中で行う点が、それ以前の機械学習と異なります。
Q. 機械学習とディープラーニングの違いは何ですか?
A. ディープラーニングは機械学習の一種です。違いは特徴量の扱いにあり、それ以前は人間が設計していた特徴量を、ディープラーニングは学習の中で自動的に作り出します。
Q. ディープラーニングはどんなデータに向きますか?
A. 画像、音声、動画、自然言語のように、注目すべき特徴を人間が言語化しにくいデータです。表形式のデータでは、勾配ブースティング決定木が同等以上の性能を出すことがよくあります。
Q. 学習にはどのくらいのデータが必要ですか?
A. ゼロから学習する場合は大量に必要ですが、実務では学習済みモデルを土台にする転移学習が標準です。自社固有の対象なら、数百から数千件のラベル付きデータで届くことが多くなります。
Q. ブラックボックス問題とは何ですか?
A. なぜその答えを出したのかを、人間が規則として取り出せない性質です。判断理由を説明する義務がある業務では、手法の選択や運用設計に制約が生じます。
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
※用語の定義や統計は、公表時点の情報です。規格や白書は改訂されるため、記述の時点をあわせて確認してください。
参考
用語の定義
- 日本産業規格 JIS X 22989:2023「情報技術-人工知能-人工知能の概念及び用語」(2023年8月21日制定、国際規格 ISO/IEC 22989:2022 に一致) https://www.meti.go.jp/policy/economy/hyojun-kijun/jiskouji/20230821001.html
- 総務省・経済産業省「AI事業者ガイドライン(第1.2版)」(令和8年3月31日) https://www.meti.go.jp/shingikai/mono_info_service/ai_shakai_jisso/pdf/20260331_1.pdf
- 同 掲載ページ(本編・別添・チェックリスト・用語集) https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html
普及の状況
- 総務省「令和7年版 情報通信白書」第Ⅱ部 第2章 第2節「AI利用の現況」 https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r07/html/nd112210.html
(日本の生成AI利用率は2023年度9.1%→2024年度26.7%。20代は44.7%)
ブラックボックス問題
- 総務省「AI事業者ガイドライン(第1.2版)別添」(令和8年3月31日) https://www.soumu.go.jp/main_content/001064286.pdf
(判断のブラックボックス化が問題になった事例と、透明性・アカウンタビリティの整理)
Level 5で触れた論点の原典
- Alex Krizhevsky, Ilya Sutskever, Geoffrey E. Hinton「ImageNet Classification with Deep Convolutional Neural Networks」(NeurIPS 2012) https://proceedings.neurips.cc/paper/4824-imagenet-classification-with-deep-convolutional-neural-networks.pdf
- Kaiming He, Xiangyu Zhang, Shaoqing Ren, Jian Sun「Deep Residual Learning for Image Recognition」(2015) https://arxiv.org/abs/1512.03385
- Ashish Vaswani ほか「Attention Is All You Need」(2017) https://arxiv.org/abs/1706.03762
表形式データの話の裏づけ
- Léo Grinsztajn, Edouard Oyallon, Gaël Varoquaux「Why do tree-based models still outperform deep learning on typical tabular data?」(NeurIPS 2022 Datasets and Benchmarks Track) https://arxiv.org/abs/2207.08815
(「tree-based models remain state-of-the-art on medium-sized data (~10K samples)」)
資格の範囲を確かめるなら
- 一般社団法人 日本ディープラーニング協会 G検定 https://www.jdla.org/certificate/general/
- 同 E資格 https://www.jdla.org/certificate/engineer/