スマホで写真を撮って「これは何?」と聞ける。
資料のグラフを見せて「要点を教えて」と頼める。
この、種類の違う情報をまとめて扱える性質をマルチモーダルといいます。
本記事では、マルチモーダルの説明を5つのレベルに分けて並べました。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(7分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(9分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(9分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で通り過ぎます。
30秒で腕試し
理解度から決めたい場合は、次の3問を試してください。
答えられなくなったところが、あなたのスタート地点です。
Q1. AIは人と同じように画像が見えていると思いますか
→ 詰まったら Level 1から
Q2. 画像を渡すとトークンを消費する理由を説明できますか
→ 詰まったら Level 3から
Q3. 汎用モデルと専用処理のどちらを使うべきか、判断できますか
→ 詰まったら Level 4から
→ 3問とも答えられるなら Level 5から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
生成AIという言葉があやふやな場合は、先にこちらを読んでください。
→ 生成AIとは?5段階でわかる用語解説
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:マルチモーダルを「文字も絵も音もまとめて分かるAI」だと言える
人は、いろいろな感じ方をまぜて分かっている
友だちが「大丈夫」と言ったとき、言葉だけを聞いているわけではありません。
表情を見て、声の調子を聞いて、それらをまぜて「本当は大丈夫じゃないな」と分かります。
情報の種類のことを、少し難しい言葉でモーダルといいます。
文字、絵、音、動画。
これらが、それぞれ別のモーダルです。
いくつものモーダルをまとめて扱えることを、マルチモーダルといいます。
マルチは「たくさん」という意味です。
昔のAIは、一つのことしかできなかった
少し前まで、AIは一種類のことしかできませんでした。
- 文字だけを読むAI
- 絵だけを見分けるAI
- 音だけを聞き取るAI
それぞれ別のAIで、別々に作られていました。
いまのAIは、一つで全部を扱えます。
写真を見せながら文字で質問する、といったことができます。
何ができるようになったか
マルチモーダルになって、こんなことができます。
- 写真を見せて「これは何?」と聞く
- 料理の写真を見せて「作り方を教えて」と聞く
- 数式が書かれたノートを撮って「解き方を教えて」と聞く
- 声で話しかけて、声で答えてもらう
- グラフを見せて「何が言いたいグラフ?」と聞く
どれも、以前は別々のAIが必要だったことです。
つまずきポイント
「AIは本当に見えているの?」
人と同じように見えているわけではありません。
画像を、AIが扱える形の数値に変えて、それを文字と同じように処理しています。
だから、細かい部分を見落としたり、書いてある文字を読み間違えたりします。
理解度チェック
Q1. マルチモーダルとはどういう意味ですか?
文字、絵、音、動画など、いろいろな種類の情報をまとめて扱えることです。
Q2. 昔のAIと今のAIの違いは何ですか?
昔は種類ごとに別々のAIが必要でしたが、今は一つで複数の種類を扱えます。
Q3. AIは人と同じように見えているのですか?
違います。画像をAIが扱える数値に変えて処理しているため、細かい部分を見落とすことがあります。
ここまで読めば言えるようになること
- マルチモーダルの意味を説明できる
- できるようになったことを3つ挙げられる
- 人の見え方とは違うと説明できる
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(複数の種類の情報を扱うこと、人の見え方とは違うこと)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:得意なことと苦手なことを知り、使い方を工夫できる
入力と出力を分けて考える
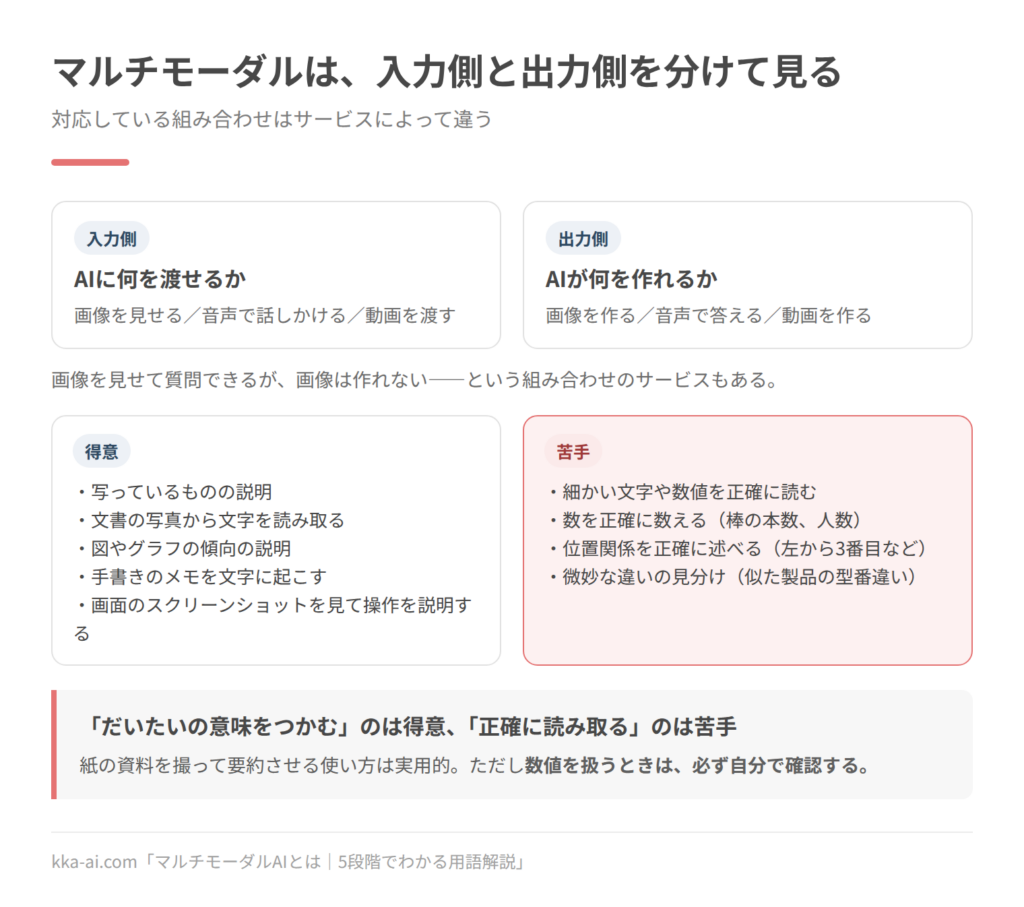
マルチモーダルには、入力側と出力側があります。
入力側は、AIに何を渡せるかです。
画像を見せる、音声で話しかける、動画を渡す、といったことです。
出力側は、AIが何を作れるかです。
画像を作る、音声で答える、動画を作る、といったことです。
サービスによって、対応している組み合わせが違います。
画像を見せて質問できるが画像は作れない、というサービスもあります。
得意なこと
画像を扱う場合、次のようなことが得意です。
- 写っているものの説明
- 文書の写真から文字を読み取る
- 図やグラフの傾向の説明
- 手書きのメモを文字に起こす
- 画面のスクリーンショットを見て操作を説明する
紙の資料を撮って要約させる、という使い方は実用的です。
苦手なこと
一方、次は苦手です。
- 細かい文字や数値を正確に読む
- 数を正確に数える(グラフの棒の本数、写真の人数)
- 位置関係を正確に述べる(左から3番目、など)
- 微妙な違いの見分け(似た製品の型番違いなど)
つまり、「だいたいの意味をつかむ」のは得意で、「正確に読み取る」のは苦手です。
数値を扱うときは、必ず自分で確認してください。
使い方の工夫
精度を上げる工夫がいくつかあります。
- 画像を鮮明に、まっすぐ撮る
- 必要な部分だけを切り出して渡す
- 「この表の3行目の数値を読み取って」のように、対象を指定する
- 読み取った内容を復唱させてから、それをもとに作業させる
最後の工夫は効果が大きく、読み取りの誤りをその場で見つけられます。
つまずきポイント
「同じ画像なのに、聞き方で答えが変わる」
変わります。
何に注目すべきかの指示がないと、AIは目立つ部分に注目します。
細部を扱いたいときは、どこを見てほしいかを明示してください。
理解度チェック
Q1. マルチモーダルの入力側と出力側の違いは何ですか?
入力側はAIに何を渡せるか、出力側はAIが何を作れるかです。サービスによって対応が異なります。Q2. 画像を扱う際に苦手なことを4つ挙げてください。
細かい文字や数値を正確に読む、数を正確に数える、位置関係を正確に述べる、微妙な違いの見分けです。Q3. 読み取りの誤りを見つけるのに効果的な工夫は?
読み取った内容を復唱させてから、それをもとに作業させることです。ここまで読めば言えるようになること
- 入力側と出力側を区別できる
- 得意と苦手を判断できる
- 精度を上げる工夫を実践できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(入力側と出力側、得意なことと苦手なこと)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:異なる種類の情報がどう統合されるかを説明できる
共通の形に変換する
種類の違う情報を一つのモデルで扱うには、共通の形に変える必要があります。
文章はトークンに分割され、数値の並びに変換されます。
→ トークンとは
画像も同じように、小さな領域に分割され、それぞれが数値の並びに変換されます。
音声も、短い区間ごとに数値の並びになります。
こうして共通の形にそろえてしまえば、あとは同じ仕組みで処理できます。
文章のトークン列と、画像から作られた数値列を並べて入力すると、モデルはそれらの関係を扱えます。
意味の空間を共有する
もう一つ重要なのが、意味の対応付けです。
「犬」という単語と、犬の写真が、近い意味を持つものとして扱われる必要があります。
そのために、大量の「画像と、その説明文」の組を使って学習します。
学習の目標は、対応する画像と文章を近づけ、対応しないものを遠ざけることです。
これによって、画像と言語が同じ意味の空間に配置されます。
この対応付けができているから、「写真を見せて言葉で質問する」ことが成立します。
画像はトークンを消費する
実務上、知っておくと役立つ点があります。
画像を入力すると、その画像は複数のトークンとして扱われます。
消費するトークン数は、画像の大きさと詳細さの設定によって変わります。
高解像度で渡すほど、トークン数は増えます。
つまり、画像を渡すことには費用がかかります。
必要な部分を切り出して渡すのは、精度だけでなく費用の面でも効果的です。
また、コンテキストの上限も画像で消費されます。
多数の画像を一度に渡すと、上限に達しやすくなります。
→ コンテキストとは
苦手な理由
Level 2で挙げた苦手なことには、仕組み上の理由があります。
細かい文字の読み取りが苦手なのは、画像を一定の大きさの領域に分割して扱うため、小さな文字が1つの領域に潰れるからです。
高解像度で処理する設定にすると改善しますが、トークン数と費用が増えます。
数を数えるのが苦手なのは、モデルが数を数える処理を明示的に行っていないためです。
分割された領域ごとの特徴から、統計的に答えを組み立てています。
位置関係が苦手なのも、同様の理由です。
位置の情報は保持されていますが、正確な順序として扱う処理は行われていません。
これらを要する用途では、専用の処理(文字認識の専用エンジン、物体検出)を併用するほうが確実です。
つまずきポイント
「マルチモーダルなら、動画もそのまま理解できる?」
多くの場合、動画は一定間隔で切り出した静止画として処理されます。
そのため、切り出しの間隔より短い動きは捉えられません。
音声を併せて処理する構成もありますが、対応はサービスによって異なります。
理解度チェック
Q1. 種類の違う情報を一つのモデルで扱うには、何が必要ですか?
共通の形(数値の並び)に変換することです。画像も音声も、小さな単位に分割して数値化されます。
Q2. 画像と言語の意味の対応付けは、どう学習されますか?
大量の「画像とその説明文」の組を使い、対応するものを近づけ、対応しないものを遠ざけるように学習します。
Q3. 細かい文字の読み取りが苦手な仕組み上の理由は?
画像を一定の大きさの領域に分割して扱うため、小さな文字が1つの領域に潰れるためです。
Q4. 画像を渡すことのコスト上の影響は?
画像は複数のトークンとして扱われ、大きさと詳細さの設定に応じてトークン数と費用が増えます。
ここまで読めば言えるようになること
- 共通の形への変換を説明できる
- 意味の対応付けの学習方法を説明できる
- 画像のトークン消費を意識できる
- 苦手なことを仕組みから説明できる
仕事で判断する立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(共通の形への変換、トークンの消費、苦手の理由)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:用途ごとに、汎用モデルと専用処理のどちらを使うか判断できる
効果的な用途
マルチモーダルが業務で有効であるのは、次のような場面です。
紙や画像の資料を扱う工程です。
紙の資料を撮って要約する、手書きのメモを整形する、ホワイトボードの内容を議事録にする。
これまで人が読んで打ち直していた工程が短縮されます。
画面や図表の説明です。
スクリーンショットから操作手順の説明を作る、グラフから傾向の説明文を作る。
検査や確認の一次選別です。
写真から明らかな問題を拾い、判断が微妙なものだけ人に回す。
全件を自動判定するのではなく、絞り込みに使う設計にすると導入の難度が下がります。
専用処理を選ぶべき場合
汎用のマルチモーダルモデルより、専用の処理を選ぶべき場合があります。
- 帳票から項目を正確に抽出する:専用の文字認識と帳票処理のほうが精度も速度も上
- 製品の欠陥を検出する:自社データで学習した検出モデルのほうが確実
- 大量の画像を高速に分類する:軽量な専用モデルのほうが安価
汎用モデルの利点は、学習なしで多様な指示に対応できることです。
逆に、対象と判断基準が固定されている処理では、専用の処理が上回ります。
費用の見積もり
画像を扱う場合の費用は、次の要素で決まります。
- 画像1枚あたりのトークン数(解像度と詳細さの設定で変わる)
- 1件あたりの画像枚数
- 出力の長さ
- 想定件数
高解像度の設定は、精度が上がる代わりにトークン数が数倍になることがあります。
用途によっては標準の解像度で足りるため、両方で精度を測って決めてください。
精度検証の設計
マルチモーダルの精度検証では、次を評価セットに含めます。
- 鮮明な画像だけでなく、傾いた、暗い、影のある画像
- 手書きと印字の両方
- 想定外の形式(横向き、複数ページが1枚に写っている)
現場で撮影される画像は、担当者が用意したサンプルより崩れています。
崩れた画像を含めない評価は、本番の性能を過大に見積もります。
権利と個人情報
画像を扱う場合、テキストにはない論点が加わります。
写り込んだ個人情報への配慮が要ります。
書類の写真に別人の氏名が写る、背景に人が写る、といった場合の扱いを決めます。
生成した画像の権利も論点です。
既存の作品に類似する可能性があり、外部に出す制作物では確認の工程が要ります。
入力画像の扱いは、テキストと同様に規約で確認します。
つまずきポイント
「試したときは読めたのに、現場では読めない」
撮影条件の差が原因のことがほとんどです。
試したときの画像は、明るい場所でまっすぐ撮ったものです。
現場では、傾き、影、反射、指の写り込みが入ります。
撮影の手順を定めるか、崩れた画像でも動くよう検証してから導入してください。
理解度チェック
Q1. マルチモーダルが業務で有効な工程を3つ挙げてください。
紙や画像の資料を扱う工程、画面や図表の説明、検査や確認の一次選別です。Q2. 汎用モデルより専用処理を選ぶべきなのはどんな場合ですか?
対象と判断基準が固定されている処理です。帳票からの項目抽出や欠陥検出などが該当します。Q3. 評価セットに含めるべき、忘れられやすい画像は?
傾いた、暗い、影のある画像や、想定外の形式の画像です。Q4. 画像を扱う際に加わる権利上の論点は?
写り込んだ個人情報、生成画像の権利、入力画像の規約上の扱いです。ここまで読めば言えるようになること
- 有効な用途を判断できる
- 汎用と専用を使い分けられる
- 解像度設定を含めた費用を見積もれる
- 崩れた画像を含む評価を設計できる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:構成要素と学習方法を理解し、用途に応じた設計ができる
対照学習による対応付け
画像と文章を同じ空間に対応づける方法は、2021年のCLIPの論文で広く知られるようになりました。画像と言語の対応付けは、対照学習によって獲得されます。
画像側と言語側それぞれに符号化器を置き、対応する組を近づけ、対応しない組を遠ざける目的関数で学習します。
大規模な画像と説明文の対から学習することで、明示的なラベルなしに広い範囲の概念を扱えるようになります。
学習なしで新しいクラスに対応できる性質は、この対応付けから生じます。
一方、この方式で得られる表現は、対応関係の粗さに制約されます。
説明文に書かれない細部(小さな文字、正確な数、位置関係)は、対応付けの学習信号に含まれにくく、そのまま弱点になります。
Alec Radford ほか「Learning Transferable Visual Models From Natural Language Supervision (CLIP)」(arXiv:2103.00020・2021年・英語)
言語モデルへの接続
現在の主流は、視覚符号化器の出力を言語モデルの入力空間に射影する構成です。
視覚符号化器は、画像をパッチに分割し、各パッチの表現を得ます。
これを射影層によって言語モデルの埋め込み次元に変換し、テキストのトークン埋め込みと並べて入力します。
学習の段階は、通常次のように分けられます。
まず射影層のみを学習して両者を接続し、次に指示に従う形式のデータで全体または一部を調整します。
視覚符号化器を固定するか更新するかは、資源と目的で決めます。
高解像度への対応は、画像を分割して複数の視点で処理する構成や、解像度に応じてパッチ数を可変にする構成が使われます。
いずれもトークン数の増加を伴い、コンテキストの消費と費用に直結します。
トークン数の設計
画像1枚が消費するトークン数は、パッチの大きさと画像の解像度で決まります。
高解像度で処理する設定では、複数の切り出しを合わせて数千トークンに達することがあります。
トークン数を削る手法として、視覚トークンを圧縮する構成があります。
学習可能な少数のクエリで視覚特徴を要約する方式、隣接するパッチを統合する方式などです。
圧縮率と細部の保持は相反するため、用途に応じた設定が要ります。
音声と動画
音声は、短い区間ごとの特徴量に変換して扱います。
音声認識を経由してテキストに変換する構成と、音声表現を直接言語モデルに接続する構成があります。
後者は、話者の口調や感情など、テキストに落とすと失われる情報を扱えます。
動画は、フレームを一定間隔で抽出して静止画として扱う構成が一般的です。
フレーム数がトークン数に直結するため、抽出間隔の設計が費用を左右します。
時間方向の情報を扱うため、フレーム間の関係を明示的に符号化する構成もあります。
評価と限界
マルチモーダルの評価では、言語側の事前知識だけで答えられてしまう問題に注意が要ります。
画像を見なくても常識から答えられる設問が含まれていると、視覚能力を測れません。
評価セットの設計では、画像を差し替えると答えが変わる設問を用意します。
また、文字認識、計数、空間関係、細部の識別といった弱点の領域を、個別に測ります。
安全性の面では、画像を経路とするプロンプトインジェクションが論点になります。
画像内に指示文を書き込むことでモデルの挙動を変える攻撃が可能であり、外部から取り込んだ画像を扱う構成では対策が要ります。
理解度チェック
Q1. 対照学習で得られる表現の限界は何ですか?
説明文に書かれない細部(小さな文字、正確な数、位置関係)は学習信号に含まれにくく、弱点として残ります。
Q2. 視覚符号化器を言語モデルに接続する一般的な構成は?
視覚符号化器の出力を射影層で言語モデルの埋め込み次元に変換し、テキストのトークン埋め込みと並べて入力します。
Q3. 動画を扱う際、費用を左右する設計項目は?
フレームの抽出間隔です。フレーム数がトークン数に直結します。
Q4. マルチモーダルの評価で注意すべき問題は?
言語側の事前知識だけで答えられる設問が含まれると、視覚能力を測れないことです。
ここまで読めば言えるようになること
- 対照学習による対応付けと、その限界を説明できる
- 視覚と言語の接続構成を説明できる
- トークン数と精度の相反を設計に反映できる
- 評価と安全性の論点を挙げられる
まとめ
マルチモーダルは、種類の異なる情報をまとめて扱える性質です。
Level 1では、文字も絵も音も分かるAI。
Level 2では、だいたいの意味は得意で、正確な読み取りは苦手な道具。
Level 3では、共通の形に変換して統合する仕組み。
Level 4では、汎用と専用を使い分けて組み込む対象。
Level 5では、対応付けの粗さが弱点を規定する設計。
実務での要点は、「意味をつかむのは得意、正確に読むのは苦手」という一線です。
数値や型番を扱う工程では、必ず確認の工程を挟んでください。
次に読む記事
→ 生成AIとは
→ トークンとは
→ プロンプトとは?生成AIで必須の用語の意味と、初心者が最初に覚える「1つの型」を解説
→ 今さら聞けないAI用語30選
よくある質問(FAQ)
Q. マルチモーダルとは何ですか?
A. 文章、画像、音声、動画など、複数の種類の情報をまとめて扱えることです。画像を見せて言葉で質問する、といった使い方が可能になります。
Q. AIは画像をどう理解しているのですか?
A. 画像を小さな領域に分割し、それぞれを数値の並びに変換して、文章のトークンと同じように処理しています。人と同じ見え方をしているわけではありません。
Q. 画像から文字を読み取らせても大丈夫ですか?
A. だいたいの内容をつかむには使えますが、細かい文字や数値の正確な読み取りは苦手です。数値を扱う場合は確認の工程が必要で、帳票処理では専用の文字認識のほうが確実です。
Q. 画像を渡すと料金は変わりますか?
A. 変わります。画像は複数のトークンとして扱われ、解像度と詳細さの設定に応じてトークン数が増えます。必要な部分を切り出して渡すと、精度と費用の両方が改善します。
Q. 動画もそのまま扱えますか?
A. 多くの場合、一定間隔で切り出した静止画として処理されます。そのため、切り出し間隔より短い動きは捉えられません。対応の範囲はサービスによって異なります。姿勢は変わりません。
用語の全体像はこちらで確認できます。
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
参考
内容は2026年10月3日に、以下の資料で確認しました。
- Alec Radford ほか「Learning Transferable Visual Models From Natural Language Supervision (CLIP)」(arXiv:2103.00020・2021年・英語)