この記事は、2026年10月11日時点で重みが公開されている主なモデルと、そのライセンスを記録したものです。
2026年8月28日時点の版を、四半期の点検を前倒しして書き直しました。
オープンウェイトとは、学習してできあがった重み(パラメータ)が公開され、ダウンロードして自分の環境で動かせるモデルのことです。
オープンソースとの違いや、配布ページでの見分け方は、5段階に分けた解説記事にまとめています。
→ オープンソースとオープンウェイトとは|AIの「公開」の違いを5段階でわかる用語解説
2026年10月時点の流れは、3つにまとめられます。
- 標準ライセンスでの公開が続いている。Gemma 4(4月)、Inkling(7月)、Muse Glimmer(8月)がApache 2.0、DeepSeekのモデルはMITで公開されています
- 最大規模のモデルでは、独自ライセンスの条件が細かくなっている。Kimi K3、Qwen3.8-Max、GLM-5.3は、売上の規模に応じて別の契約や審査を求めます。GLM-5.3は、前の版のMITから独自ライセンスに移りました
- 大手が重みの公開を予告している。MetaはMuse Sparkの重みを、Mistral AIはMistral Large 4の重みを出すと発表していますが、10月11日時点で公開は確認できていません
「オープン」という一語では、もう区別がつきません。
この記事でわかること
| 知りたいこと | 要点 | 詳しくは |
|---|---|---|
| どのモデルがどのライセンスか | 標準ライセンスはApache 2.0とMIT。兆単位のモデルは独自ライセンスが多い | 主なモデルとライセンス一覧 |
| 8月から何が変わったか | GLM-5.3が独自ライセンスへ。Inkling、DeepSeek-V4.1-Flash、LLM-jp-4.1が出た | 8月から変わったこと |
| 独自ライセンスは何を求めるか | 売上や利用者数が一定を超えると、表示、別の契約、審査が要る | 収益の条件 |
| 「オープンソース」と呼べるのか | OSIの定義では、重みだけの公開は該当しない | OSIの定義 |
| 国産モデルはどうなっているか | 楽天とNIIがApache 2.0で公開 | 国産モデル |
| 手元で動かすには何が必要か | 8Bクラスの4bit量子化で約4.6GB | 動かすときの目安 |
2026年10月時点の主なモデルとライセンス一覧
重みが公開されている主なモデルを、ライセンスの種類ごとに並べます。
規模は配布元の公表値で、括弧内は1回の処理で動かす分(混合エキスパートの場合)です。
標準ライセンス(Apache 2.0、MIT)
| モデル(開発元) | 公開時期 | 規模 | ライセンス |
|---|---|---|---|
| Gemma 4(Google) | 2026年4月2日 | 約31B ほか | Apache 2.0 |
| Muse Glimmer(Meta) | 2026年8月10日 | 約29.6B | Apache 2.0 |
| Inkling(Thinking Machines Lab) | 2026年7月15日 | 975B(41B) | Apache 2.0 |
| Qwen3.8-27B(Alibaba) | 2026年8月 | 27B | Apache 2.0 |
| Mistral Large 3(Mistral AI) | 2025年12月 | 675B(41B) | Apache 2.0 |
| Mistral Small 4(Mistral AI) | 2026年3月 | 119B | Apache 2.0 |
| gpt-oss-120b、gpt-oss-20b(OpenAI) | 2025年8月 | 117B、21B | Apache 2.0 |
| DeepSeek-V4-Pro(DeepSeek) | 2026年4月 | 1.6T(49B) | MIT |
| DeepSeek-V4.1-Flash(DeepSeek) | 2026年9月 | 552B(8B〜16B) | MIT |
| GLM-5.2(Z.ai) | 2026年 | 753B | MIT |
独自ライセンス
| モデル(開発元) | 公開時期 | 規模 | ライセンス |
|---|---|---|---|
| Kimi K3(Moonshot AI) | 2026年7月 | 2.8T(104B) | Kimi K3 License |
| Qwen3.8-2.4T-A95B(Alibaba) | 2026年8月 | 2.4T(95B) | Qwen3.8-Max License |
| GLM-5.3(Z.ai) | 2026年8月28日(重み) | 753B | GLM-5.3 License |
| Nemotron 3(NVIDIA) | 2026年 | Nano、Super、Ultra | NVIDIA Open Model License |
| Nemotron 3.5 Lightning(NVIDIA) | 2026年8月11日 | 30B(アクティブ3B) | OpenMDW-1.1 |
| Llama 4 Scout、Maverick(Meta) | 2025年4月 | 109B、400B(17B) | Llama 4 Community License |
表のパラメータ数の読み方については、AIモデルのパラメータとは|「〇億パラメータ」の意味と読み方で解説しています。
2026年に出た数百億パラメータまでのモデルは、ほぼ標準ライセンスです。
条件の細かい独自ライセンスが付いているのは、Kimi K3、Qwen3.8-Max、GLM-5.3のような最大規模のモデルです。
ただし規模だけでは決まらず、兆単位のDeepSeek-V4-ProはMITです。NVIDIAは、規模にかかわらず自社のライセンスを使っています。
2024年から2025年にかけては、Llama Community LicenseやGemma Terms of Useのような開発元ごとの独自ライセンスが主流でした。
Gemma 4の公式発表は「Gemma 4 models are the first in the Gemmaverse to be released under the OSI-approved Apache 2.0 license.」と書いています。
MetaもMuse Glimmerで、Llamaの独自ライセンスを離れてApache 2.0を選びました。
NVIDIAのNemotron 3.5 Lightningは、モデルカードにライセンスが「OpenMDW License Agreement, version 1.1」と書かれています。
Apache 2.0やMITとは別の名前なので、商用で使う前に条文を読んでください。
8月から変わったこと
8月28日時点の版から、次の点が変わりました。
| 時期 | できごと |
|---|---|
| 2026年7月15日 | Thinking Machines Labが最初のモデルInklingを、Apache 2.0で公開(8月版で載せ漏れ) |
| 2026年8月13日 | Linux Foundationが、AIモデル向けのライセンスOpenMDW-1.1の承認をOSIに申請 |
| 2026年8月 | AlibabaがQwen3.8-2.4T-A95Bの重みを、独自ライセンスで公開 |
| 2026年8月28日 | Z.aiがGLM-5.3の重みを公開。APIの提供開始から約2週間後で、ライセンスは前の版のMITから独自のGLM-5.3 Licenseに |
| 2026年9月 | DeepSeekがDeepSeek-V4.1-FlashをMITで公開 |
| 2026年9月28日 | 国立情報学研究所(NII)がLLM-jp-4.1をApache 2.0で公開。追加学習に使ったデータも公開 |
| 2026年10月6日 | Mistral AIがMistral Large 4をプレビュー提供。重みは「coming soon」 |
GLM-5.3は、標準ライセンスから独自ライセンスへ移った例です。
同じ開発元の続きの版でも、ライセンスは変わります。
前の版の条件で判断せず、使う版の条文を確かめてください。
公開を予告しているモデル
2社が、上位のモデルの重みを出すと発表しています。
Muse Spark(Meta)
2026年8月10日、Muse Glimmerの公開と同時に、上位のMuse Spark 1.2の重みを公開すると発表しました。
9月2日には後継のMuse Spark 1.3を出しましたが、こちらは重みを公開していません。
10月11日時点で、Muse Sparkの重みの公開とライセンスは確認できていません。
Mistral Large 4(Mistral AI)
2026年10月6日にプレビューの提供が始まり、開発元の更新履歴には「Open weights are coming soon.」とあります。
ライセンスは書かれていません。
どちらも、出た時点でこの一覧に足します。
収益の条件は、大規模モデルほど細かい
独自ライセンスの3本について、条件をライセンス本文で確かめました。
狙いはどれも、「小規模な利用者には制限をかけず、大きな商用利用にだけ条件をつける」ことです。
| モデル | 画面への表示 | 別の契約や審査 | 対象外になる使い方 |
|---|---|---|---|
| Kimi K3 | 月間アクティブユーザー1億人超、または月の売上2,000万ドル超のサービスで使うとき、「Kimi K3」を画面に表示 | モデルを外部に提供する事業で、12か月の売上が2,000万ドル超なら、Moonshot AIと別の契約 | 社内だけの利用、公式製品や認定パートナー経由の利用 |
| Qwen3.8-Max | 月間アクティブユーザー1億人超、または月の売上2,000万ドル超で、モデル名を画面に表示 | モデルを外部に提供する事業、またはAIの業務アシスタント事業で、12か月の売上が5,000万ドル超なら、別の商用ライセンス | 社内だけの利用(モデルや出力を第三者に提供しない場合) |
| GLM-5.3 | なし | モデルを外部に提供する事業者で、12か月の売上が100億ドル超なら、Z.aiの安全審査を通ってから使う | 製品の機能に組み込むだけの使い方、他社のモデルへの中継 |
「モデルを外部に提供する事業」は、どのライセンスも、APIなどで第三者に推論や追加学習をさせる事業を指しています。
自社の製品に機能として組み込むだけの使い方は、Kimi K3とGLM-5.3では明記して対象から外しています。
8月版では、Qwen3.8-Maxの条件を第三者の解説で確認したと書いていました。
今回、配布元のライセンス本文で同じ内容を確かめました。
Llamaのライセンスでよく誤解される点
Llama 3.1 Community Licenseには、次の条項があります。
If, on the Llama 3.1 version release date, the monthly active users … is greater than 700 million monthly active users in the preceding calendar month, you must request a license from Meta
you shall also include “Llama” at the beginning of any such AI model name.
前者は月間7億ユーザー超の企業に別途ライセンス取得を求めるもの、後者は派生モデルの名前の先頭に「Llama」を付ける義務です。
後者を「出力を他のモデルの学習に使ってはいけない条項」と説明している記事を見かけますが、条文が求めているのは命名です。
ライセンスの話は、要約ではなく本文を読んでください。
なお、Gemmaの利用規約には「Google claims no rights in Outputs you generate using Gemma.」という一文があります。
生成物についての権利は主張しない、という書き方です。
開発元は3つの路線に分かれている
公開の仕方で見ると、主な開発元は3つに分かれます。
分け方は、主要LLMの最新動向2026|海外勢と国産モデル、政府の取り組みと同じです。
| 路線 | 開発元 | 2026年10月時点の公開状況 |
|---|---|---|
| 最上位を公開しない | OpenAI、Anthropic、xAI | OpenAIは2025年8月にgpt-ossを公開。Anthropicは重みを公開していない |
| オープンウェイトが主軸 | DeepSeek、Alibaba、Moonshot AI | いずれも兆単位のモデルの重みを公開 |
| 併用 | Google、Meta、Mistral AI | 上位は非公開、軽量から中型を公開。MetaとMistral AIは上位の重みの公開を予告 |
規模と性能で上位のオープンウェイトは、ほとんどが中国の開発元のものです。
@ITは2026年10月9日、米調査会社RedMonkの分析を紹介する記事で、例外としてThinking Machines LabのInklingやNVIDIAのNemotronを挙げています。
OSIの定義では「オープンソース」と呼べない
Open Source Initiative(OSI)は2024年10月に「Open Source AI Definition(OSAID)1.0」を公開しました。
2026年10月11日時点でも、版は1.0のままです。
これを満たすには、次の3つが必要とされています。
- 学習に使ったデータについての、十分に詳細な情報
- 学習と実行に使用した完全なソースコード
- モデルのパラメータ(重み)
上に並べたモデルの多くは、3番目の重みだけを公開しています。
OSIの定義に照らすと、本記事の一覧は、正確にはすべて「オープンウェイト」の一覧です。
この定義の読み方は、5段階版のLevel 3で扱っています。
→ オープンソースとオープンウェイトとは|AIの「公開」の違いを5段階でわかる用語解説
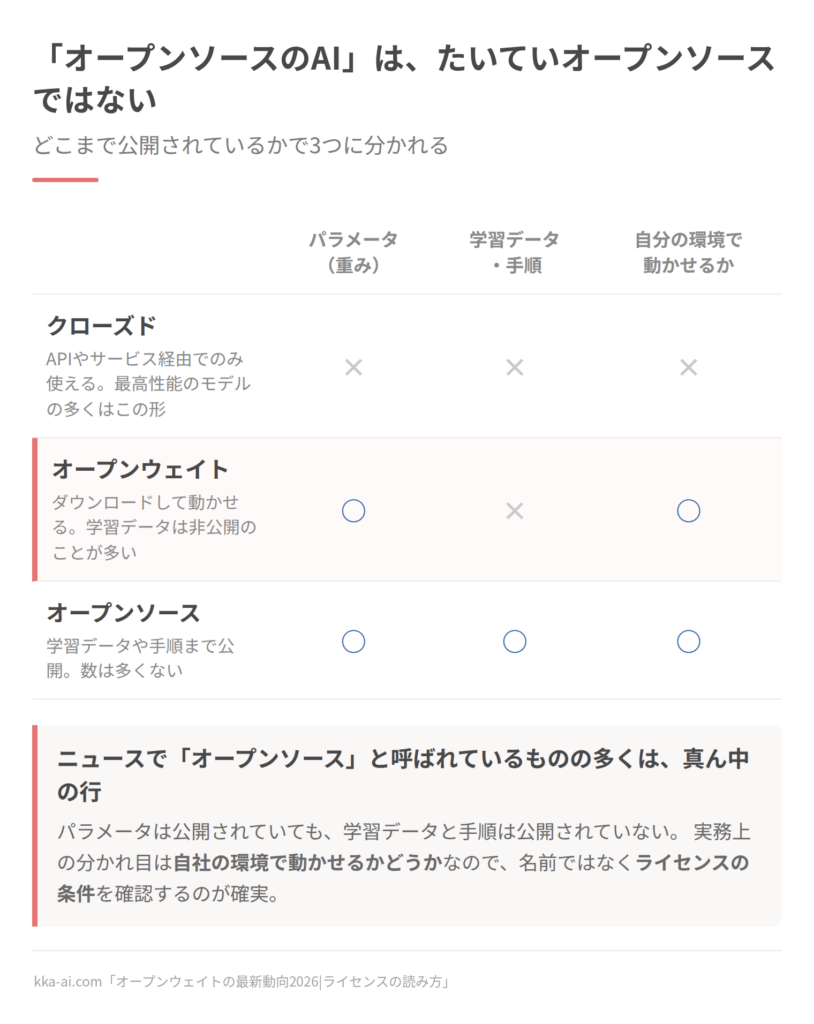
一覧のモデルは、ほぼすべて真ん中の行。OSIの定義に照らすと「オープンソースのAI」とは呼べない。
AIモデル向けのライセンスの審査が始まった
もう1つの動きが、ライセンスの側にあります。
Linux Foundationは2026年8月13日、AIモデルの配布向けに作ったライセンス「OpenMDW-1.1」を、OSIのライセンス審査に申請しました。
重み、データ、コード、文書をまとめて1つのライセンスで扱い、再配布のときにライセンス文と表示を残すことだけを求める、という作りです。
審査のメーリングリストでは、8月末の時点でも議論が続いていました。
10月11日時点で、OSIの承認の発表は確認できていません。
国産モデルの状況
日本の開発元が公開しているモデルを、確認できた範囲で挙げます。
| モデル | 公開時期 | 規模 | ライセンス |
|---|---|---|---|
| Rakuten AI 3.0(楽天グループ) | 2026年3月17日 | 約7,000億(MoE) | Apache 2.0 |
| LLM-jp-4.1(国立情報学研究所) | 2026年9月28日 | 8B、32B-A3B、33B | Apache 2.0 |
| CyberAgentLM v3(サイバーエージェント) | 2024年7月9日 | 225億 | Apache 2.0 |
| Stockmark-2-100B-Instruct-beta(ストックマーク) | 2025年3月18日 | 1,000億 | MIT |
| Llama-3.1-ELYZA-JP-70B(ELYZA) | 2024年 | 70B | Llama Community License準拠 |
| ELYZA-LLM-Diffusion(ELYZA) | 2026年1月16日 | 非公表 | 商用利用可能な形式 |
LLM-jp-4.1は、国立情報学研究所(NII)が2026年9月28日に公開しました。
8B、32B-A3B、33Bの3つで、ライセンスはApache 2.0です。
NIIは、LLM-jp-4の事後学習を改善したものと説明しています。
変更点は、理工系の分野の性能向上、ツール呼び出しへの新規対応、回答の詳細さの調整です。
モデル名は「llm-jp-4.1-8b-thinking」のように、末尾に「thinking」が付きます。
「32B-A3B」の読み方は、AIモデルのパラメータとはで扱っています。
総数が約320億で、一度に使うのはその一部、という構造を表す書き方です。
NIIのページには、事後学習に使ったSFTデータとDPOデータも公開されていると書かれています。
重みだけを公開するモデルが多いなかで、一歩進んだ公開のしかたです。
ただし、OSIの定義(学習データの詳細な情報など)を満たすかどうかは、この記事では判定していません。
Rakuten AI 3.0は、公表されているベンチマークで日本語の指標が並んでいます。
JamC-QA 76.9、MMLU-ProX日本語 71.7、MATH-100日本語 86.9、M-IFEval日本語 72.1。
約7,000億パラメータのモデルがApache 2.0で出た点が、国内では大きな出来事です。
LLM-jp-4.1は、LLM-jp-4の追加学習を改善した版で、ツール呼び出しに対応しました。
重みに加えて、追加学習(教師ありの微調整と、選好の最適化)に使ったデータも公開しています。
OSIの定義が求める「データの情報」に、国内のモデルで近づいている例です。
ELYZA-LLM-Diffusionは商用利用可能な形式で公開されたと発表されていますが、パラメータ数とライセンス名は公式資料で確認できませんでした。
Preferred NetworksのPLaMo 3.0 Primeは、APIとオンプレミスでの提供で、重みが公開されているかは確認できていません。
政府調達との関係で注意したいこと
デジタル庁の「源内」で選定されたのはPLaMo翻訳です。
選定理由に「オープンウェイトだから」という記述はありませんし、PLaMo翻訳の重みは公開されていません。
「政府が機密性を理由にオープンウェイトのモデルを選んでいる」という書き方をしている記事がありますが、この事例はその根拠になりません。国産モデルの採用とオープンウェイトは、別の論点として扱ってください。
手元で動かすときの容量の目安
オープンウェイトの実用的な大きな特徴は、自分のパソコンで動かせることです。
必要な容量は量子化(ファイルを圧縮して軽くする処理)の設定で変わります。
llama.cppの公式資料に載っているLlama-3.1-8Bの実測値です。
| 量子化設定 | ファイルサイズ |
|---|---|
| IQ1_S | 1.87GiB |
| IQ2_XXS | 2.23GiB |
| IQ3_XXS | 3.04GiB |
| Q4_K_M | 4.58GiB |
| Q5_K_M | 5.33GiB |
| Q8_0 | 7.95GiB |
| F16(無圧縮) | 14.96GiB |
Q4_K_Mが公式に「標準的な選択肢」とされています。
8Bクラスなら4.6GB前後、というのが目安です。
Muse Glimmerの公式発表は、4bit量子化で「under 20 GB」、単一のコンシューマ向けGPUやMacで動作すると書いています。
約30Bクラスで20GB弱、という感覚です。
兆単位のモデルは、量子化しても手元のパソコンには載りません。
4bit(1パラメータあたり0.5バイト)で計算すると、重みだけでKimi K3の2.8Tは約1.4TB、Qwen3.8-2.4T-A95Bの2.4Tは約1.2TBになります。
一覧の上のほうにある大きなモデルは、データセンター向けです。
LM Studioの推奨は、RAM 16GB以上、8GBでは小規模モデルのみ、WindowsのGPUを使う場合はVRAM 4GB以上とされています。
手元のメモリ容量から逆算して、載るサイズのモデルを選ぶというのが実際の手順になります。
ニュースの読み方
オープンウェイト関連の記事を読むときの問いを3つに絞ります。
1. ライセンス名は何か
Apache 2.0やMITなら、標準的な条件です。開発元の名前がついたライセンスなら、条文を読む必要があります。
前の版と同じライセンスとは限りません。
2. 何が公開されているか
重みだけか、学習データの情報やコードもあるか。ほとんどは重みだけです。
「公開予定」と「公開済み」も分けて読みます。
3. 規模と量子化後のサイズはいくつか
自分の環境で動くかどうかは、この2つで決まります。
ライセンスと公開範囲という考え方そのものは、5段階版で扱っています。
→ オープンソースとオープンウェイトとは|AIの「公開」の違いを5段階でわかる用語解説
よくある質問(FAQ)
Q. 2026年10月時点で、どんなオープンウェイトのモデルがありますか?
A. 標準ライセンスでは、Gemma 4、Muse Glimmer、Inkling、Qwen3.8-27B、Mistral Large 3、gpt-oss(Apache 2.0)と、DeepSeek-V4-Pro、DeepSeek-V4.1-Flash(MIT)などがあります。兆単位の最大規模では、Kimi K3、Qwen3.8-2.4T-A95B、GLM-5.3が独自ライセンスで公開されています。
Q. オープンウェイトのモデルは商用利用できますか?
A. Apache 2.0やMITのモデルは、商用利用を認めています。著作権表示やライセンス文の同梱といった義務はあります。独自ライセンスのモデルも商用利用はできますが、売上や利用者数が一定を超えると、画面への表示、別の契約、審査が必要になります。配布ページの利用規約もあわせて確認してください。
Q. 大企業でなければライセンスの条件は気にしなくていいですか?
A. 収益の条件は、月間1億人規模の利用者や、年に数千万ドルから100億ドル規模の売上を基準にしているため、個人や中小規模の利用では該当しないことがほとんどです。ただし著作権表示や、再配布するときの条件は、規模に関係なくかかります。
Q. オープンソースとオープンウェイトは何が違うのですか?
A. 何が公開されているかの違いです。OSIの定義は、学習データの詳細な情報、学習と実行のコード一式、モデルの重みの3つを求めています。重みだけが公開されている状態がオープンウェイトです。詳しくは5段階版で解説しています。
Q. Llamaのライセンスは出力を他のモデルの学習に使うことを禁止していますか?
A. Llama 3.1 Community Licenseが求めているのは、派生モデルの名前の先頭に「Llama」を付けることと、月間7億ユーザーを超える企業が別途ライセンスを取得することです。命名義務を学習利用の禁止と説明している記事がありますが、条文の内容は異なります。
Q. 日本語が得意なオープンウェイトのモデルはありますか?
A. 2026年3月に公開されたRakuten AI 3.0が、日本語のベンチマークで数値を公表しています。JamC-QA 76.9、MMLU-ProX日本語 71.7などです。国立情報学研究所のLLM-jp-4.1(2026年9月28日公開、Apache 2.0)もあります。ほかにCyberAgentLM v3、ELYZAのモデルがあります。
Q. 手元のパソコンで動かすには何GB必要ですか?
A. 8Bクラスのモデルを標準的なQ4_K_Mで量子化した場合、llama.cppの実測でファイルサイズは4.58GiBです。約30BクラスのMuse Glimmerは4bit量子化で20GB弱とされています。兆単位のモデルは、4bitでも重みだけで1TBを超えます。
Q. なぜ開発元は重みを公開するのですか?
A. 公開の理由は開発元によって異なり、公式に説明されていない場合も多くあります。この記事は公開されている事実の記録に絞っているため、動機については扱っていません。考え方の整理は5段階版のLevel 2にあります。
まとめ
2026年10月時点のオープンウェイトをめぐる動きは、3つです。
ひとつは標準ライセンスでの公開です。
Gemma 4、Inkling、Muse GlimmerがApache 2.0で、DeepSeekのモデルがMITで公開されています。
国内では、楽天が約7,000億パラメータのモデルをApache 2.0で公開しました。
国立情報学研究所も、9月にLLM-jp-4.1をApache 2.0で公開しています。
手元で動かす場合は、8Bクラスなら4.6GB前後が目安になります。
もうひとつは、最大規模のモデルでの条件の細分化です。
Kimi K3、Qwen3.8-Max、GLM-5.3は、売上の規模に応じて別の契約や審査を求めます。
GLM-5.3は、前の版のMITから独自ライセンスに移りました。
そして、MetaとMistral AIが上位モデルの重みの公開を予告しています。
どの場合も、公開されているのは重みが中心です。
OSIの定義に照らすと「オープンソースのAI」と呼べるモデルはほとんどなく、AIモデル向けのライセンスの審査も続いています。
記事を読むときは、ライセンス名、公開範囲、量子化後のサイズの3つを確かめてください。
動向は変わりますが、土台にある考え方は変わりません。
体系的に理解しておくと、次に新しいモデルが公開されたときに自分で判断できるようになります。
→ オープンソースとオープンウェイトとは|AIの「公開」の違いを5段階でわかる用語解説
用語の全体像はこちらで確認できます。
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
参考
内容は2026年10月11日に、以下の資料で確認しました。国産モデル(LLM-jp-4.1を除く)、Llamaのライセンス、llama.cpp、LM Studio、デジタル庁は、2026年8月28日に確認した内容です。
モデルの公開ページは更新のたびにURLが変わるため、個別のライセンスは配布ページから辿ってください。
定義とライセンスの審査
- Open Source Initiative「The Open Source AI Definition – 1.0」(2024年10月28日公開・英語)
- Open Source Initiative「For Approval: OpenMDW License Agreement, versions 1.1 (OpenMDW-1.1)」(ライセンス審査のメーリングリスト、2026年8月13日・英語)
ライセンス本文(配布ページ)
- Moonshot AI「Kimi K3 License」(Hugging Face・英語)
- Qwen「Qwen3.8-2.4T-A95B LICENSE」(Hugging Face・英語)
- Z.ai「GLM-5.3 LICENSE」(Hugging Face・英語)
- DeepSeek「DeepSeek-V4.1-Flash」(Hugging Face、モデルカード・英語)
- Thinking Machines Lab「Inkling」(Hugging Face、モデルカード・英語)
- Meta「Llama 3.1 Community License」(英語)
- Google「Gemma Terms of Use」(英語)
開発元の発表
- Google Open Source Blog「Gemma 4: Expanding the Gemmaverse with Apache 2.0」(2026年4月2日・英語)
- Mistral AI「Changelog」(2026年10月6日の項・英語)
- 国立情報学研究所 大規模言語モデル研究開発センター「LLM-jp」
- 楽天グループ「Rakuten AI」
- サイバーエージェント「ニュース」
- ELYZA「ELYZA」
- NVIDIA「Nemotron」(英語)
報道(発表の内容と時期の確認に使ったもの)
- PC Watch「NII、ツール呼び出し対応・STEM強化の「LLM-jp-4.1」公開」(2026年9月29日)
- The New Stack「Z.ai GLM weights license」(2026年8月28日・英語。GLM-5.3の重みの公開日と、GLM-5.3-FlashがMITのままであること)
- VentureBeat「Meta says Muse Spark 1.3 has frontier performance」(2026年9月3日・英語。Muse Sparkの重みが未公開であること)
- VentureBeat「Meta returns to open source with Muse Glimmer」(2026年8月10日・英語)
- SiliconANGLE「Mira Murati’s Thinking Machines drops Inkling open-weights model」(2026年7月15日・英語)
- @IT「企業が使うAIモデル、1年半で6割超が「中国製」に 「最高性能のオープンモデルはほぼ中国発」の理由」(2026年10月9日)
手元で動かす目安と国内の事例
- llama.cpp「GitHub」(英語)
- LM Studio「ドキュメント」(英語)
- デジタル庁「デジタル庁」
- 国立情報学研究所 大規模言語モデル研究開発センター「LLM-jp-4.1」 https://llmc.nii.ac.jp/topics/llm-jp-4-1/
- NVIDIA「NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4」(Hugging Face) https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報