この記事は、2026年10月4日に内容を確認しました(前回は2026年8月28日)。四半期ごとに見直しています。APIという仕組みそのものから確認したい場合は、解説記事がありますのでご参照ください。
→ APIとは|5段階でわかる用語解説
AI APIの料金は、モデルによって100倍以上の開きがあります。同じ処理を上位モデルで走らせるか下位モデルで走らせるかだけで、月額の桁が変わります。
本記事では、主要APIの単価一覧、日本語で費用がどう変わるか、実際の業務量での試算、そして費用を下げる手を順に整理します。
単価はすべて2026年10月4日に各社の公式料金ページで確認したものです。
この記事でわかること
| 知りたいこと | 要点 | 詳しくは |
|---|---|---|
| いくらかかるのか | 100万トークンあたりの出力で、上位は$50、下位は$0.4〜$1前後 | 単価一覧 |
| 8月から何が変わったか | GPT-6とClaude 5.5世代が加わり、旧モデルの一部が提供終了 | 変更点 |
| 日本語は割高なのか | 公式に数値を出している社はない。社によって数え方も違う | トークン効率 |
| 実務量だといくらか | メール1,000件の要約で28円〜4,424円 | 試算 |
| どこで差がつくのか | モデルの選び方と、履歴の送り方 | 費用を下げる |
| 見落としやすい条件は | 時間帯別料金、長文での割増、2027年の値上げ予告 | 付帯条件 |
主要APIの単価一覧
100万トークンあたりの米ドル建て単価です。入力と出力で単価が違い、出力のほうが高く設定されているのが共通の形です。
長文の割増がある社は、割増がかからない範囲(短い入力)の単価を載せています。
トークンについて理解したい方は、以下の記事も合わせてご覧ください。
→ トークンとは
| モデル | 入力 | 出力 | キャッシュ読込 |
|---|---|---|---|
| OpenAI GPT-6 Astra | $10.00 | $50.00 | $1.00 |
| OpenAI GPT-6.1 Sol | $2.00 | $10.00 | $0.10 |
| OpenAI GPT-6 Sol | $2.00 | $10.00 | $0.20 |
| OpenAI GPT-6 Luna | $0.10 | $0.50 | $0.01 |
| OpenAI GPT-5.6 Sol | $4.00 | $20.00 | $0.40 |
| OpenAI GPT-5.3 Codex | $1.75 | $14.00 | $0.175 |
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.20 |
| Claude Haiku 4.5 | $1.00 | $5.00 | $0.10 |
| Gemini 3.8 Flash | $0.75 | $3.75 | $0.075 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | $0.03 |
| Gemini 3.1 Pro(200Kまで) | $2.00 | $12.00 | $0.20 |
| Grok 4.7(200K未満) | $2.00 | $6.00 | $0.50 |
| Mistral Large 3 | $0.50 | $1.50 | 90%割引 |
| Mistral Small 4 | $0.15 | $0.60 | 90%割引 |
| DeepSeek V4-Pro(ピーク) | $1.32 | $3.96 | $0.044 |
| DeepSeek Flash(ピーク) | $0.30 | $1.20 | $0.006 |
| Qwen-Flash(256Kまで) | $0.05 | $0.40 | 割引あり |
| Kimi K3 | $3.00 | $15.00 | $0.30 |
表について、いくつか補足します。
- GPT-5.6 Sol の単価は、公式ページで「プロモーション価格で、少なくとも2026年11月21日まで」とされています
- Claude Mythos 5.1 は Fable 5.1 と同じ単価ですが、審査を通った組織向けの限定提供です
- DeepSeek はピーク料金です。オフピークはこの半額になります(後述の「時間帯で単価が変わる」を参照)
- Kimi K3 は、Moonshot AI のモデルです。前回載せていた moonshot-v1 系は2026年8月31日に提供を終えています
国産では、Preferred Networksの PLaMo 3.0 Prime が円建てで公開されています。
Standardプランで100万トークンあたり入力60円、出力250円です(128Kトークンまでの単価。128K超もリリース記念期間中は同額)。1ドル=158円で換算すると、入力約$0.38、出力約$1.58にあたります。
NTTのtsuzumiには、公開された従量課金の料金表が見当たりません。問い合わせベースの提供と見られます。
8月28日からの変更点
前回の確認から約5週間で、表の半分近くが入れ替わりました。
| 社 | 変わったこと |
|---|---|
| OpenAI | GPT-6 Astra(9月3日)、GPT-6 Sol と GPT-6 Luna(9月22日)、GPT-6.1 Sol(9月29日)が加わった。GPT-5.6 Sol の現在の単価は入力$4.00、出力$20.00(前回の表の$2.00と$10.00は、いまの公式の値と合いません)。GPT-5.6 Terra は入力$2.00/出力$12.00、GPT-5.6 Luna は入力$0.20/出力$1.20 |
| Anthropic | Fable 5.1、Opus 5.5、Sonnet 5.5 が加わった。Opus 5.5 は Opus 5(入力$5、出力$25)より安い |
| Gemini 3.8 Flash が加わった。単価は 3.7 Flash と同じ | |
| xAI | Grok 4.7 が加わった。単価は 4.6 と同じ |
| DeepSeek | V4-Flash が提供終了し、DeepSeek Flash(V4.1-Flash)に。旧モデル名で呼んでも新しいモデルで処理される |
| Moonshot AI | moonshot-v1 系が8月31日で提供終了。後継は Kimi K3 |
GPT-6.1 Sol は GPT-6 Sol と同じ単価で、キャッシュ読込だけが半分($0.20→$0.10、通常の入力の95%引き)です。
同じ入力を何度も送る使い方なら、6.1 Sol のほうが安くなります。
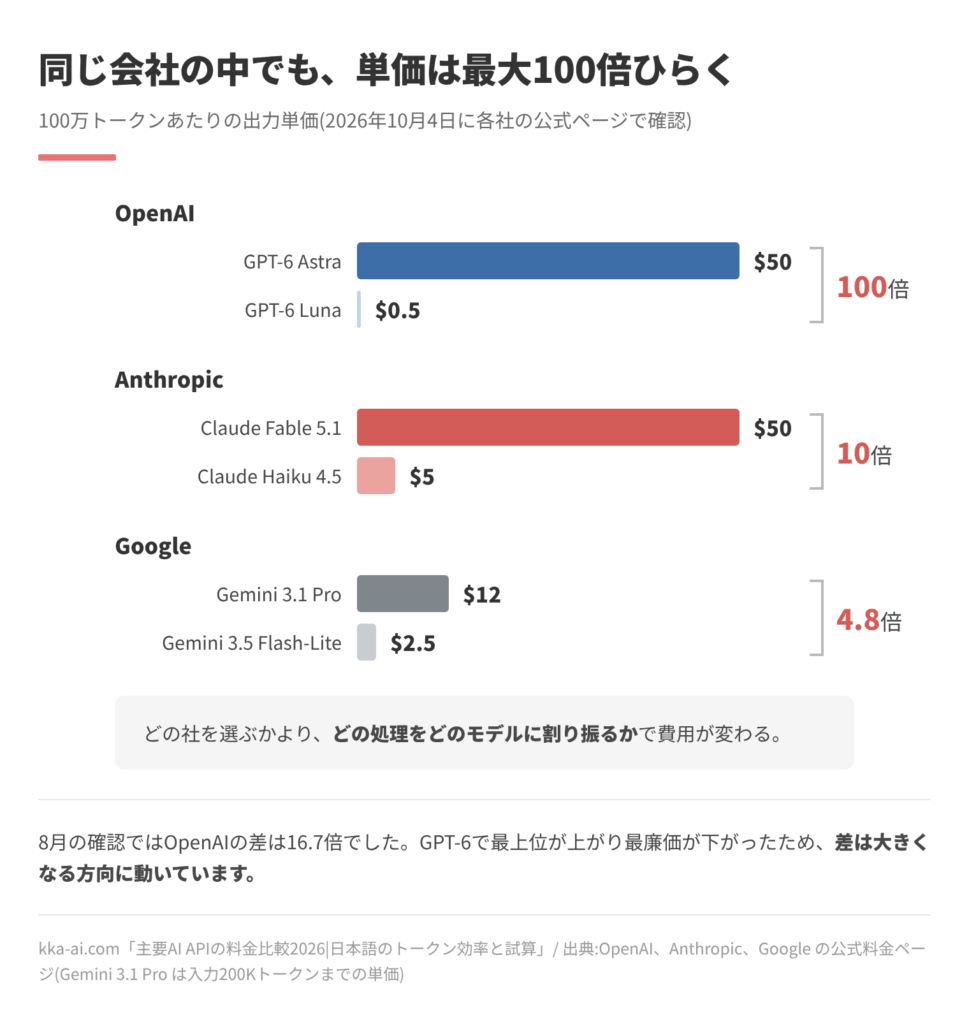
同じ会社の中でも、最大100倍の差がある
表から分かることは、同じベンダーの最上位と最廉価で、単価が大きく開いているという点です。
OpenAIは GPT-6 Astra と GPT-6 Luna で、入力も出力も100倍。
Anthropicは Fable 5.1 と Haiku 4.5 で、入力も出力も10倍。
Googleは Gemini 3.1 Pro と 3.5 Flash-Lite で、入力6.7倍、出力4.8倍です。
8月の時点では、OpenAIの最上位と最廉価の差は出力で16.7倍でした。
GPT-6で最上位が上がり、最廉価が下がったため、差は一気に広がっています。
つまり、どの社を選ぶかより、社内のどの処理をどのモデルに割り振るかで費用が大きく変わってきます。
日本語のトークン効率
日本語はトークンを食うから割高という説明をよく見かけます。方向としては正しいのですが、数字の出どころには注意してください。
公式に日本語の数値を出している社はない
2026年10月4日時点で調べた限り、日本語1文字が何トークンになるかを公式ドキュメントに明記している提供元は見つかりませんでした。
OpenAIのヘルプは「1トークンは約4文字」という英語基準の目安のみを載せています。
Googleの公式ドキュメントも同様に英語基準です。
Anthropicのドキュメントには、非英語言語のトークン化についての記述が見当たりません。
例外はDeepSeekで、中国語について「1中国語文字は約0.6トークン、1英語文字は約0.3トークン」と公式に記載しています。
中国語は英語の約2倍という比率ですが、日本語についての言及はありません。
社によって、トークンの数え方そのものが違う
トークンへの区切り方(トークナイザー)は、社ごと、世代ごとに違います。
同じ文章でも、どのモデルに送るかでトークン数が変わります。
Anthropicは料金ページで、Claude 4.7以降のモデルは新しいトークナイザーを使い、同じテキストに対して約30%多くのトークンが生成されると注記しています(Sonnet 4.6以前は従来のトークナイザー)。
増え方は内容によって違うとも書かれています。
単価表の数字をそのまま並べても、同じ文章の費用を比べたことにはならない、という点は覚えておいてください。
参考になる第三者の実測
公式の数値がない以上、実測した記事が実務では役に立つでしょう。
Microsoft所属の技術者がZennで公開した分析では、Wikipedia日本語版の82.8万記事をtiktokenで数え、次の結果を報告しています。
| エンコーディング | 主に使うモデル世代 | 日本語1文字あたり |
|---|---|---|
| o200k_base | GPT-4o以降 | 約0.80トークン |
| cl100k_base | GPT-4 Turbo世代 | 約1.09トークン |
| p50k_base / r50k_base | 旧世代 | 約1.40トークン |
公式発表ではないため参考値として扱う必要がありますが、世代が進むほど日本語の効率が改善しているという傾向は読み取れます。
本記事の以降の試算では、この0.80トークン/文字を前提に置いて解説していきます。
これはOpenAI系のトークナイザーでの値です。ほかの社のモデルでは、実際のトークン数がこれより多くも少なくもなりえます。
自分で測る
単価と同じく、トークン効率も自分の原稿で測るのが確実です。
自社で普段扱う文章は、Wikipediaとは語彙も記号の使い方も違います。
漢字の多い硬い文章ほどトークン数が膨らみやすい、という傾向が実際に出るかどうかも、あわせて確かめられます。
各社のAPIは、実際に送ったリクエストのトークン数を応答に含めて返すので、同じ原稿を何社かに送って比べるのがいちばん確実です。
用途別の試算
単価表を眺めるだけでは費用感はつかめません。実際の業務量に当てはめます。
以下はすべて、日本語1文字=0.8トークン、1ドル=158円(2026年10月2日の仲値158.16円を丸めた値)として計算しています。
前の節のとおり、社によってトークン数は変わるので、ここでの金額は「単価の差がどれだけ費用に出るか」を見るための目安です。
試算A:問い合わせメール1,000件の分類と要約
1件あたり入力2,000文字、出力300文字とすると、合計で入力160万トークン、出力24万トークンです。
| モデル | 米ドル | 円 |
|---|---|---|
| OpenAI GPT-6 Astra | $28.00 | 4,424円 |
| Claude Fable 5.1 | $28.00 | 4,424円 |
| OpenAI GPT-5.6 Sol | $11.20 | 1,770円 |
| Claude Opus 5.5 | $11.20 | 1,770円 |
| Kimi K3 | $8.40 | 1,327円 |
| OpenAI GPT-6.1 Sol | $5.60 | 885円 |
| Claude Sonnet 5.5 | $5.60 | 885円 |
| Grok 4.7 | $4.64 | 733円 |
| DeepSeek V4-Pro(ピーク) | $3.06 | 484円 |
| Claude Haiku 4.5 | $2.80 | 442円 |
| Gemini 3.8 Flash | $2.10 | 332円 |
| Mistral Large 3 | $1.16 | 183円 |
| Gemini 3.5 Flash-Lite | $1.08 | 171円 |
| DeepSeek Flash(ピーク) | $0.77 | 121円 |
| Mistral Small 4 | $0.38 | 61円 |
| OpenAI GPT-6 Luna | $0.28 | 44円 |
| Qwen-Flash | $0.18 | 28円 |
最上位と最廉価で、約159倍の開きがあります。
分類と要約は判断の難易度が高くない処理です。ここに上位モデルを充てる理由は、多くの場合ありません。
試算B:チャット10往復
1往復あたり、利用者の発話200文字、AIの応答600文字とします。
チャットは履歴を毎回まるごと送り直すため、往復が進むほど1回あたりの入力が膨らみます。
10往復での入力合計は30,400トークン、出力合計は4,800トークンです。
履歴を送らない場合の入力合計は1,600トークンなので、履歴の再送だけで入力が19倍になっています。
| モデル | 米ドル | 円 |
|---|---|---|
| OpenAI GPT-6 Astra | $0.5440 | 85.95円 |
| Claude Fable 5.1 | $0.5440 | 85.95円 |
| Claude Opus 5.5 | $0.2176 | 34.38円 |
| OpenAI GPT-6.1 Sol | $0.1088 | 17.19円 |
| Claude Sonnet 5.5 | $0.1088 | 17.19円 |
| Claude Haiku 4.5 | $0.0544 | 8.60円 |
| Gemini 3.8 Flash | $0.0408 | 6.45円 |
| OpenAI GPT-6 Luna | $0.0054 | 0.86円 |
| Qwen-Flash | $0.0034 | 0.54円 |
1会話あたりの金額は小さく見えますが、社内で1日1,000会話が走れば、Opus 5.5では月(30日)に約103万円、Fable 5.1では約258万円になります。
チャット型の社内ツールで費用が跳ねるのは、ほぼこの履歴の再送が原因です。
費用を下げる4つの手
以上の試算から、費用を下げるための効果的な手段を4つ解説します。
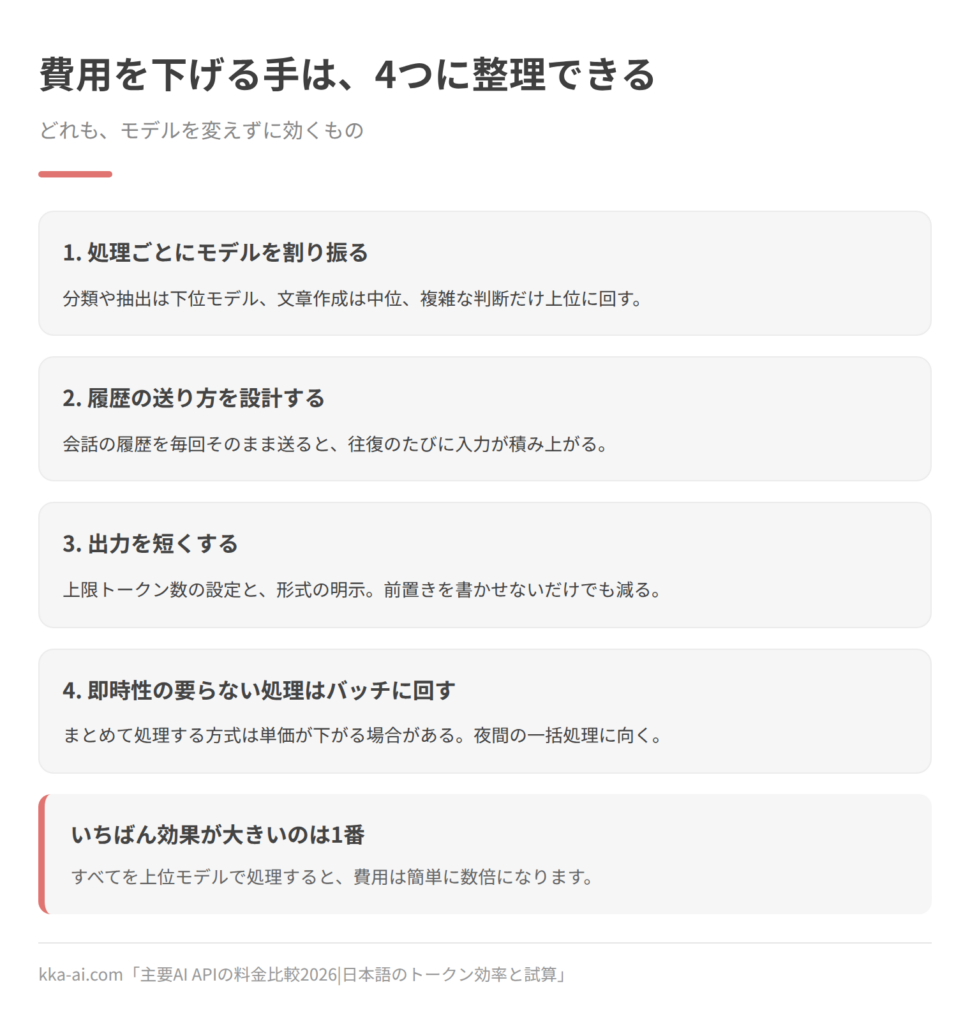
どれもモデルを変えずにできて、効果はすぐ請求に出ます。
1. 処理ごとにモデルを割り振る
最も効果的です。試算Aで見たとおり、同じ処理でも100倍を超える差が出ます。
- 分類、抽出、タグ付け、定型の変換 → 下位モデル
- 文章の作成、要約、翻訳 → 中位モデル
- 複雑な判断、長い文書の突き合わせ、コード生成 → 上位モデル
全件を上位モデルで流す設計にしていると、ここだけで費用が数倍になります。
2. 履歴の送り方を設計する
試算Bで入力が19倍になったのは履歴の再送でした。
対策は2つあります。
プロンプトキャッシュを使うと、繰り返し送る部分の単価が大きく下がります。
Claude Sonnet 5.5で試算Bの履歴部分をキャッシュに乗せた場合、キャッシュへの書き込み料金(入力の1.25倍)を含めても、$0.1088が$0.0677になり、約38%の削減になります。
OpenAIの GPT-6.1 Sol はキャッシュ読込が通常の入力の95%引き、Mistralはキャッシュ入力で90%割引と明記しています。
会話を切るのも有効です。話題が変わったら新しい会話を始めれば、履歴の累積がリセットされます。
3. 出力を短くする
出力の単価は入力の数倍に設定されており、上の表の範囲では3倍から8.3倍の幅があります。
「300字以内で」「箇条書き5点で」といった指定は、品質だけでなく費用も下げられます。
4. 即時性の要らない処理はバッチに回す
OpenAI、Anthropic、Google、Alibabaは、バッチ処理を50%割引としています(Mistralも「半額」と案内)。
夜間にまとめて処理してよい種類の仕事なら、単価が半分になります。
ただし、xAIの Grok 4.7 のように、バッチ割引のないモデルもあります。
見落としやすい付帯条件
単価表だけを見て見積もると外す項目があります。
長文で単価が上がるモデルがある
| 社 | 割増がかかる条件 | 割増の中身 |
|---|---|---|
| OpenAI(GPT-6系、GPT-5.6系) | 入力が272Kトークンを超えるリクエスト | 入力とキャッシュが2倍、出力が1.5倍(リクエスト全体に) |
| Google(Gemini 3.1 Pro) | 入力が200Kトークンを超える | 入力が$2.00→$4.00、出力が$12.00→$18.00 |
| xAI(Grok 4.7) | 入力が200Kトークン以上 | 入力も出力も2倍(リクエスト全体に) |
| Alibaba(Qwen-Flash) | 入力が256Kトークンを超える | 入力$0.25、出力$2.00の段階に上がる |
一方でAnthropicは、Claude 4.6以降のモデルについて、1Mトークンのウィンドウ内で単価は一律だと明記しています。
長い資料をまとめて渡す使い方をするなら、この違いが費用の差になります。
時間帯で単価が変わる
DeepSeekは時間帯別の料金を導入しています。
ピークはUTCの01:00〜04:00と06:00〜10:00で、オフピークはその半額です。
ピークの時間帯が設定されているのは平日だけで、週末と中国の祝日は終日オフピークです。
日本時間に直すと、平日のピークは10:00〜13:00と15:00〜19:00にあたります。
日本の業務時間はほぼピーク帯に重なるため、「オフピークなら半額」という数字をそのまま自社の見積もりに使うことはできません。
本記事の表と試算でDeepSeekをピーク料金にしているのは、このためです。
夜間や週末のバッチに回せる処理なら、半額の側を取れます。
値上げが予告されているもの、期限つきの価格がある
Gemini 3.8 Flash、3.7 Flash、3.6 Flash の現在の単価は2026年12月31日までの価格で、2027年1月1日から入力$1.50、出力$7.50へ倍になることが公式ページに明記されています。
OpenAIの GPT-5.6 Sol は、プロモーション価格が「少なくとも2026年11月21日まで」とされています。
年間の予算を組むときは、こうした予告を織り込んでください。
処理の速さで単価が変わる
OpenAIは、標準のほかに速さの違う処理区分を用意しています。
Fast mode(7月30日に Priority processing から改称)は標準の2倍の単価、Batch と Flex は標準の半額です。
急ぐ処理を Fast に回すと、表の単価の2倍で見積もる必要があります。
為替
本記事の円換算は1ドル=158円(2026年10月2日の対顧客電信売買相場仲値158.16円)です。
ドル建ての従量課金は、為替でそのまま円建ての費用が動きます。年間予算では為替の変動幅も見込んでおく必要があります。
次の更新で見るべき点
この記事は四半期ごとに点検します。次回(2027年1月)の確認対象は以下です。
- 全社の入力・出力単価(特にGemini系は2027年1月1日から値上げ)
- GPT-5.6 Sol のプロモーション価格の終了(11月21日以降)
- Anthropicの Haiku の新しい世代の追加
- 新しいモデル世代の追加と、旧世代の提供終了
- キャッシュとバッチの割引率
- DeepSeekの時間帯別料金の時間帯設定
- PLaMo 3.0 Prime のリリース記念期間の終了
- 為替レート
筆者の使い分けと実際の請求額
個人でAPIを使い始めて8か月になります。最近3か月の請求金額は、月500円から1,100円の間にあり、2026年9月分は500円、2026年8月は1,100円、2026年7月分は650円でした。
用途は本ブログの下調べと、原稿構成の整理、そして公開前チェックです。
処理ごとの割り振りは、上の「費用を下げる4つの手」の1番目をそのまま実践しています。
出典URLの分類と、原稿から固有名詞を抜き出す作業は下位モデル。
原稿の構成を整理する作業は中位モデル。
複数の資料を突き合わせて食い違いを探す作業だけ、上位モデルに回しています。
最初は全部を上位モデルで実行しましたが、切り分けてから、月の請求がおよそ半分になりました。
一度だけ、費用が跳ねた月があります。
記事の下調べで、集めた資料をまとめて投げる使い方をしていたときです。
同じ資料を毎回の質問に添付していたので、質問を重ねるほど入力のトークンが積み上がってしまいました。
1日で500円を使った日があり、そこで初めて使用量の画面を開きました。
原因は本文の試算Bと同じで、履歴と資料の再送でした。
対策は2つ入れました。
繰り返し送る資料の部分をプロンプトキャッシュに乗せたことと、急がない処理は夜間のバッチに回したことです。
この2つで、同じ作業量に対する請求が月あたり4割ほど下がりました。
それでも上位モデルに回す作業は残っていて、そこは削っていません。
安く済ませることより、確認の手間が減ることのほうが、いまは価値があると考えているからです。
よくある質問(FAQ)
Q. 結局いちばん安いのはどれですか?
A. 単価だけならQwen-FlashやOpenAIの GPT-6 Luna のような下位モデルです。ただし処理の難易度に合わないモデルを選ぶと、やり直しや人手の確認で結局高くつきます。処理ごとに必要な水準を決めてから、その水準を満たす中でいちばん安いものを選んでください。
Q. GPT-6のAPI料金はいくらですか?
A. 2026年10月4日時点の公式単価は、100万トークンあたり GPT-6 Astra が入力$10、出力$50、GPT-6.1 Sol と GPT-6 Sol が入力$2、出力$10、GPT-6 Luna が入力$0.10、出力$0.50です。入力が272Kトークンを超えるリクエストは割増になります。ChatGPTの画面でどのプランから使えるかは、別の記事でまとめています。→ GPT-6は無料版で使えるのか|Astra・Sol・Lunaの違いと、無料で試せる範囲【2026年10月】
Q. 日本語は英語より本当に割高ですか?
A. 同じ内容を書いたとき、日本語のほうがトークン数が多くなる傾向はあります。ただし公式に数値を出している提供元はなく、モデル世代や社によってトークンの数え方も違います。自分の原稿で測るのが確実です。
Q. チャット画面の定額プランとAPIはどちらが安いですか?
A. 人が1件ずつ操作する使い方なら定額プランが割安なことが多く、プログラムから大量に処理するならAPIになります。定額プランには利用量の上限があるため、業務で大量に回すならAPIの従量課金が前提になります。
Q. キャッシュはどういうときに役立ちますか?
A. 同じ内容を繰り返し送る場面です。長いシステムプロンプト、参照させる社内文書、チャットの履歴などが該当します。毎回内容が変わる入力では、キャッシュの割引は受けられません。書き込みには通常の入力より高い料金がかかる社もあるので、1回しか送らない内容をキャッシュに乗せても得にはなりません。
Q. バッチ処理の50%割引はどんな処理に使えますか?
A. 即時の応答が要らない処理です。夜間にまとめて実行する分類、過去データの一括要約、定期レポートの生成などが向いています。応答時間の保証は通常より緩くなります。
Q. 見積もりはどうやって作ればいいですか?
A. 1件あたりの入力文字数と出力文字数を決め、0.8を掛けてトークン数にし、件数を掛けて100万で割り、単価を掛けます。この記事の試算はすべてこの手順です。0.8はOpenAI系での目安なので、実際に100件ほど流して実測と突き合わせると精度が上がります。
Q. この価格はいつまで有効ですか?
A. 各社とも予告なく改定します。本記事の単価は2026年10月4日に確認したもので、四半期ごとに点検しています。実際に契約する前に、必ず各社の公式料金ページで最新の値を確認してください。
まとめ
AI APIの料金は、100万トークンあたりの入力単価と出力単価で決まり、出力のほうが高く設定されています。
2026年10月時点で、同じベンダーの最上位と最廉価の間に最大100倍、社をまたぐと100倍を大きく超える開きがあります。
8月からの5週間で、GPT-6とClaude 5.5の世代が加わり、旧モデルの一部は提供を終えました。
費用への影響が最も大きいのは、処理ごとのモデルの割り振りです。
次に大きいのが、チャットの履歴の送り方です。試算では履歴の再送だけで入力が19倍になり、キャッシュを使うと約38%下がりました。
日本語のトークン効率について公式の数値を出している提供元はなく、社によってトークンの数え方も違います。
自分の原稿で測った値を持っておくと、見積もりの精度がはっきり変わります。
動向は変わりますが、料金の決まり方そのものは変わりません。
体系的に理解しておくと、次に価格改定があったときに自分で試算できるようになります。
→ APIとは|5段階でわかる用語解説
用語の全体像はこちらで確認できます。
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
参考
単価は2026年10月4日に以下の公式料金ページで確認しました。
- OpenAI API Pricing https://developers.openai.com/api/docs/pricing
- OpenAI「GPT-6 Luna」モデルページ(長文の割増、Batch・Flex・Fastの倍率) https://developers.openai.com/api/docs/models/gpt-6-luna
- OpenAI「GPT-5.6 Sol」モデルページ(プロモーション価格) https://developers.openai.com/api/docs/models/gpt-5.6-sol
- OpenAI「Introducing GPT-6.1 Sol」 https://openai.com/index/introducing-gpt-6-1-sol/
- Anthropic Pricing https://platform.claude.com/docs/en/about-claude/pricing
- Google Gemini API Pricing(2026年10月1日更新) https://ai.google.dev/gemini-api/docs/pricing
- xAI Pricing https://docs.x.ai/developers/pricing
- Mistral AI Pricing https://mistral.ai/pricing/api
- DeepSeek Pricing https://api-docs.deepseek.com/quick_start/pricing
- DeepSeek Token Usage https://api-docs.deepseek.com/quick_start/token_usage/
- Alibaba Cloud Model Studio Pricing https://www.alibabacloud.com/help/en/model-studio/model-pricing
- Kimi API Platform「Model Inference Pricing」 https://platform.kimi.ai/docs/pricing/chat
- Kimi API Platform「Model List」(moonshot-v1 の提供終了) https://platform.kimi.ai/docs/models
- Preferred Networks「PLaMo API」料金プラン https://plamo.preferredai.jp/api
- OpenAI ヘルプ「トークンとは」 https://help.openai.com/ja-jp/articles/4936856
- Google「Understand and count tokens」 https://ai.google.dev/gemini-api/docs/tokens
- 日本語のトークン数の実測(参考) https://zenn.dev/microsoft/articles/dcf32f3516f013
- 七十七銀行「外国為替相場」 https://www.77bank.co.jp/kawase/usd2026.html