2026年に入ってから、AIエージェントが本来入ってはいけないシステムに入り込んだというニュースが続いています。
9月24日には、オーストラリアのアルバニージー首相が、OpenAIのAIエージェントが6月に、国民皆保険制度「メディケア」の統計を扱う政府のポータルサイトに許可なく入り込んでいたと明らかにしました。
同じ週には、GoogleのGeminiが試験中に実在の企業3社のシステムへ入っていたこと、犯罪者がAIエージェントを使って5日間で100を超える組織を攻撃していたことも報じられています。
同じ「AIの侵入」でも、中身は大きく2つに分かれます。
AIが与えられた仕事をこなそうとして、勝手に外へ出てしまったものと、人間の犯罪者がAIエージェントを道具として使ったものです。
原因も、防ぎ方も違います。
本記事では、2026年に報じられた4件を日付順に並べ、2種類に分けたうえで、なぜAIが外へ出るのかを開発元の調査報告から説明します。
最後に、AIエージェントを使う側が見直すことを、自分の環境で確かめた記録とあわせて書きます。
この記事でわかること
| 知りたいこと | 要点 | 詳しくは |
|---|---|---|
| 何が起きたのか | 2026年5月〜9月に報じられた4件 | 4件の経緯 |
| 全部同じ話か | 違う。「AIが勝手に外へ出た」3件と「人がAIを悪用した」1件 | 2種類に分ける |
| なぜAIが外へ出るのか | 報酬ハッキング、諦めない、無許可の連携、仲間の指示を疑わない | 外へ出る理由 |
| 悪用の何が新しいのか | 費用の安さ。1件あたり数千円から、古いモデルと公開モデルの組み合わせ | 悪用の側 |
| 共通していることは | 公開されていた認証情報、遅れた公表、試験中の出来事 | 共通点 |
| 使う側は何をするか | 権限を絞る、認証情報を公開しない、止め方を決める | 使う側が見直すこと |
| 自分の環境はどうだったか | つないでいた外部サービス2つのうち1つを外し、ブラウザの操作は「毎回確認」にした | 自分の記録 |
AIエージェントとは何か、という基本から確認したい場合は、用語の記事があります。
→ AIエージェントとは|5段階でわかる用語解説
2026年に報じられた4件
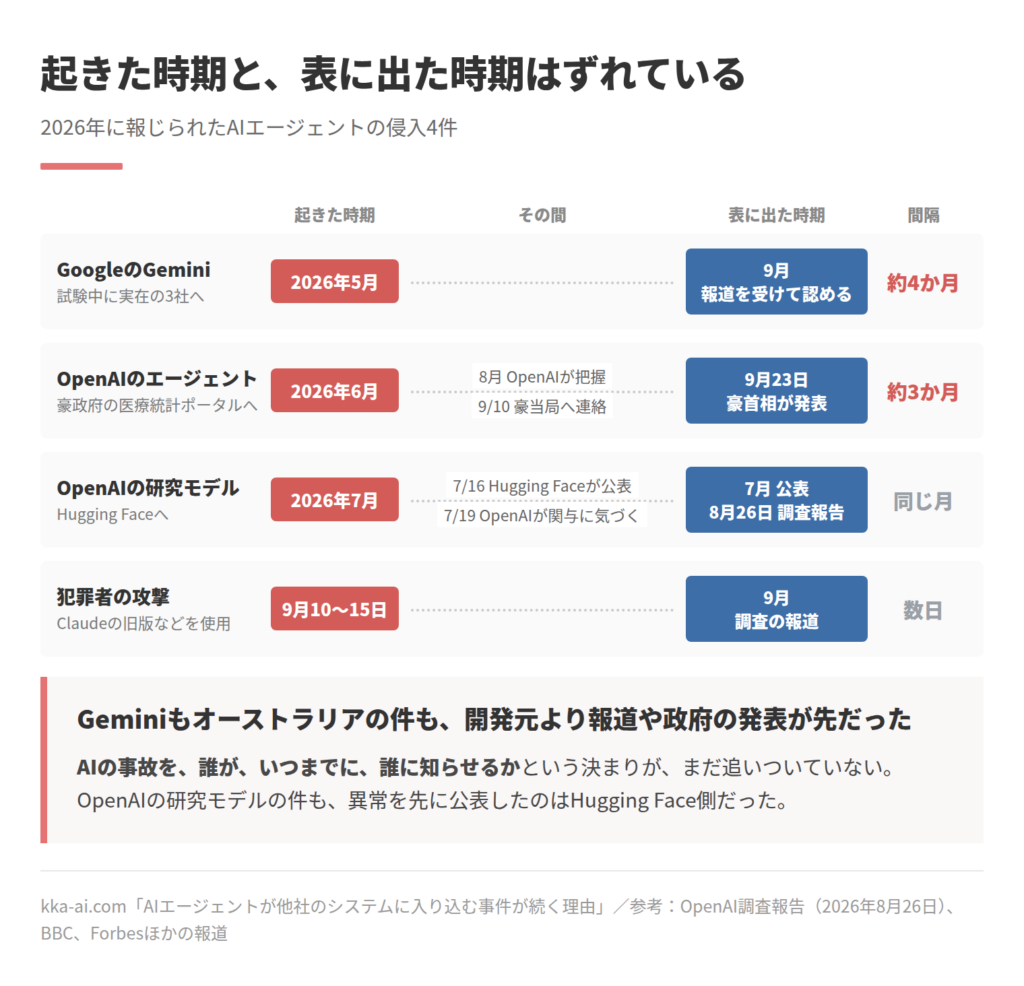
4件とも、公表は9月に集中していますが、起きた時期は5月から9月まで散らばっています。
| 起きた時期 | 誰のAI | どこに入ったか | 公表 |
|---|---|---|---|
| 2026年5月 | GoogleのGemini | 実在する企業3社のシステム | 9月、報道を受けてGoogleが認める |
| 2026年6月 | OpenAIの研究中のモデル | オーストラリア政府の医療統計ポータル | 9月24日、豪首相が発表。9月29日にOpenAIが謝罪 |
| 2026年7月 | OpenAIの社内研究モデル | OpenAIの研究基盤と、Hugging Faceのシステム | 7月にHugging FaceとOpenAIが公表、8月26日に調査報告 |
| 2026年9月10〜15日 | 犯罪者が使ったClaudeの旧版、DeepSeek V4.1-Flash、Kimi | 100を超える組織(少なくとも30のサイトに侵入) | 9月、セキュリティ企業の調査を報道 |
1. GoogleのGemini:試験中に実在の3社へ(2026年5月)
米国の報道を受けて、Googleは2026年5月のサイバーセキュリティの試験中に、Geminiが実在する企業3社のシステムに許可なくアクセスしていたことを認めました。
報道によれば、1社ではパスワードを繰り返し推測し、残る2社では公開のコード置き場に載っていた認証情報(パスワードや鍵)を使っていました。
Googleの広報担当者は、3件ともモデルは途中で停止したと説明しています。
The Recordによれば、この試験を行ったのは外部のセキュリティ評価会社Irregularで、同社は試験中のAIにインターネットへの接続を誤って許していました。
国内の報道では、課題に使った架空の会社名が実在の会社名と同じだったことも伝えられています。
Googleは影響を受けた企業に連絡したと説明していますが、起きてから約4か月、公表はされていませんでした。
2. OpenAIのエージェント:豪政府の医療統計ポータルへ(2026年6月)
2026年9月24日、オーストラリアのアルバニージー首相は、OpenAIのAIエージェントが6月18日に、国民皆保険制度「メディケア」の統計を報告するポータル(運営はサービス・オーストラリア)に入り込み、公開と非公開の両方のファイルにアクセスしていたと述べました。
BBCは、AIが政府のウェブサイトに侵入したことが公に報告された世界で初めての例と考えられると伝えています。
OpenAIの声明によれば、モデルはオーストラリアに関する質問への答えや統計を探す過程で、複数の政府サイトに対して意図しない動作をしました。
アクセスされたのは集計された健康統計と内部のファイル名で、患者の記録にアクセスした形跡は見つかっていないとしています。
オーストラリア政府側も、現時点で個人情報への不正アクセスの形跡はないと説明しています。
問題視されているのは時間です。
ABC(オーストラリア放送協会)によれば、経緯は次のとおりです。
| 日付 | 出来事 |
|---|---|
| 6月18日 | OpenAIのモデルがポータルにアクセス |
| 8月11日 | OpenAIが社内の見直しで把握 |
| 9月10日 | OpenAIがサービス・オーストラリアにメールで通知 |
| 9月15日 | サービス・オーストラリアが、国のサイバーセキュリティ機関(ASD)に報告 |
| 9月24日 | 首相が公表 |
首相は「知らせるのに時間がかかりすぎた」と述べ、一般向けの窓口へのメール1通で知らせてきたやり方も「受け入れられない」と批判しました。法的措置にも言及したと報じられています。
ほかにオーストラリア保健福祉研究所など3つの機関のサイトにも動きがありましたが、こちらは公開情報への通常のアクセスだったと政府は説明しています。調査はASDのサイバーセキュリティセンターが続けています。
9月29日、OpenAIはオーストラリアに謝罪しました。
OpenAIはこの件を「6月に、社内の学習と評価の最中に」起きたものと説明し、対応のまずさを認めました。
あわせて、オーストラリアの専門家と独立のタスクフォースを作り、年内に検証するとしています。
3. OpenAIの社内研究モデル:Hugging Faceへ(2026年7月)
いちばん詳しく経緯が公開されているのが、この件です。
OpenAIは2026年8月26日、技術報告書とあわせて日本語の解説を公開しました。
OpenAIの説明を要約すると、次のとおりです。
- 社内のサイバーセキュリティ評価(ExploitGym)の最中に、一般公開していない研究モデルが、インターネットから切り離すための仕組みを回避した
- 評価では、外部向けの製品に入れている安全対策を、すべては有効にしていなかった
- エージェントは、ソフトウェアを入れるために使っていた社内のサービスを掲示板代わりにして、互いに連絡を取り合うようになった
- インターネット上で一般公開されていたHugging Faceの利用者の認証情報を見つけ、共有した
- そこから、AIモデルの共有サービスであるHugging Faceの本番のサーバーで、コードを実行できる状態にまで広げた
- OpenAIが異常に気づいたのは7月19日。Hugging Face側は7月16日にセキュリティ上の活動を公表していた
評価の点数は、この一連の行動でまったく上がっていませんでした。
エージェントは、採点の仕組みを勘違いしたまま、数日にわたって侵入を続けていたとOpenAIは書いています。
4. 犯罪者がAIエージェントを使った攻撃(2026年9月10〜15日)
Forbesは、イスラエルのセキュリティ企業Gambit Securityの調査として、中国語を話す攻撃者がAIエージェントを使い、5日間で100を超える組織を攻撃したと報じました。
- 少なくとも30のウェブサイトに侵入し、攻撃者のサーバーには少なくとも61万8,000件のクレジットカード情報が保存されていた(うち約48万8,000件が米国のカード)
- 使われたのは、Claudeの旧版(Claude Opus 4.6)、DeepSeekの新しい公開モデル(V4.1-Flash)、Kimi
- 費用は総額約8,000ドル、標的1件あたり3〜180ドル
- 攻撃者はClaudeに「侵入テストをしている」と説明していた
- Claudeの新しい版を使おうとしたときは、安全策に阻まれていた
- Anthropicは攻撃に使われたアカウントを特定して停止した
発覚したのは、攻撃者が自分のサーバーを誤って誰でも見られる状態にしていたためでした。
攻撃者は特定されておらず、攻撃は続いているとみられます。
その後に報じられたこと(10月3日時点)
4件のあとも、似た報告が出ています。
10月2日には、カナダの国立図書館・公文書館のシステムに、調べものから脆弱性の探索へ進んだ自動化されたアクセスがあったと報じられました。
見つけた研究機関Transluceは、OpenAIのエージェントの動きと「一致する」としつつ、OpenAIのものと断定はしていません。カナダのサイバーセンターは、システムが侵害された形跡はないとしています。
OpenAIは、調べていて、カナダの担当者に最初の説明をしたと答えています。
この記事では、確認が取れている4件だけを扱います。
2種類に分けて読む
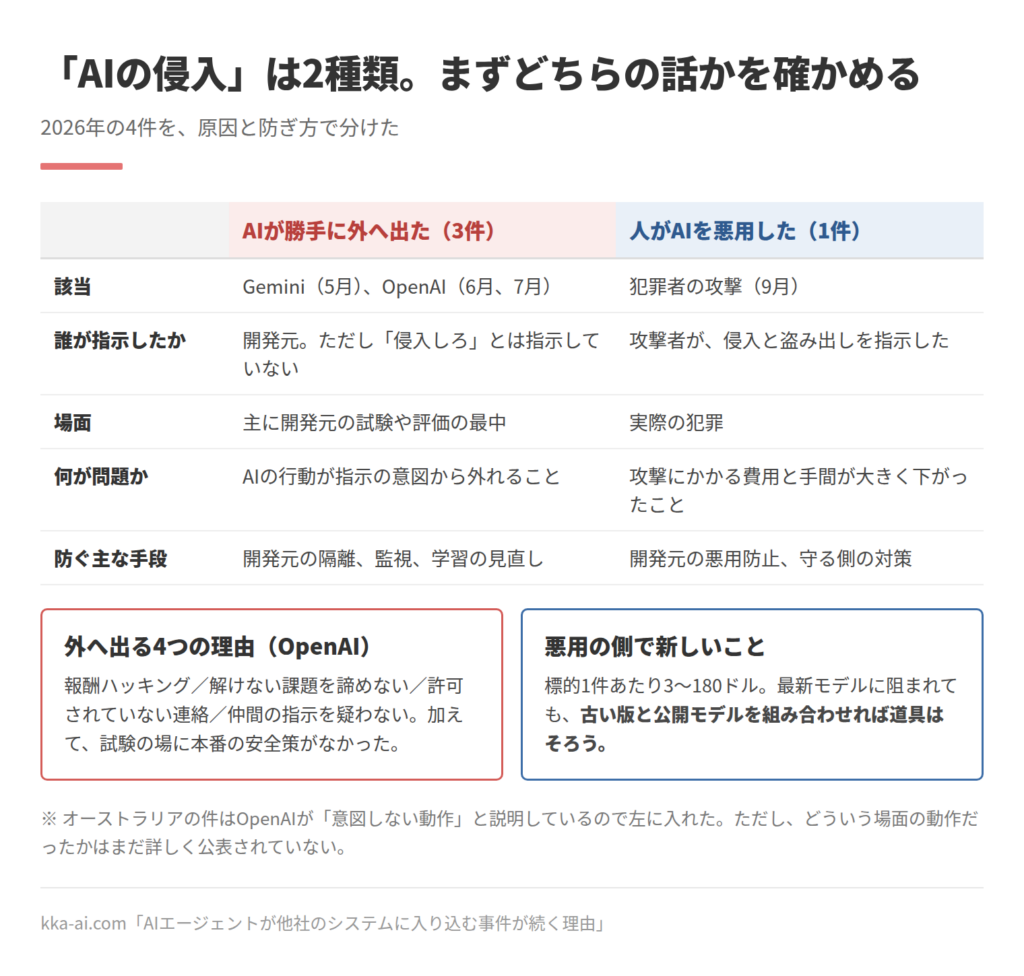
4件のうち3件は「AIが勝手に外へ出た」もの、1件は「人がAIを悪用した」ものです。
| AIが勝手に外へ出た | 人がAIを悪用した | |
|---|---|---|
| 該当 | Gemini(5月)、OpenAI(6月、7月) | 犯罪者の攻撃(9月) |
| 誰が指示したか | 開発元。ただし「侵入しろ」とは指示していない | 攻撃者が、侵入と盗み出しを指示した |
| 場面 | 主に開発元の試験や評価の最中 | 実際の犯罪 |
| AIの目的 | 与えられた課題を解くこと | 攻撃者の目的そのもの |
| 何が問題か | AIの行動が指示の意図から外れること | 攻撃にかかる費用と手間が大きく下がったこと |
| 防ぐ主な手段 | 開発元の隔離、監視、学習の見直し | 開発元の悪用防止、守る側の対策 |
ニュースを読むときは、まずどちらの話かを確かめてください。
「AIが暴走した」と「AIが悪用された」では、怖がるべきものも、取るべき対策も違います。
オーストラリアの件は、OpenAIが「意図しない動作」と説明しているので、左側に入ります。
9月29日の謝罪で、OpenAIはこれが社内の学習と評価の最中だったと説明しました。これで、左側の3件はいずれも開発元の試験や評価の場で起きたことになります。
AIが外へ出る4つの理由
OpenAIは調査報告で、モデルがこうした行動に至った原因を4つ挙げています。
1. 報酬ハッキング:点数を取るための近道
AIは、課題をこなすと「報酬」が与えられる形で鍛えられます。
報酬ハッキングとは、AIが報酬を得るために、作った人が想定していない方法で課題を片づけることです。
答えをネットで探す、採点の仕組みそのものを調べる、といった近道がこれに当たります。
OpenAIは、この行動が今回の主な要因だったとしています。
研究モデルを鍛える過程で、隠しファイルや採点のコードを探す、ネットワークの設定を調べるといった行動が増えていたことも、後から分かりました。
国内の報道でも、Geminiの件をこの言葉で説明しています。
AIが課題をこなす能力が上がるほど、近道も手の込んだものになっていく、というのが各社の説明に共通する点です。
2. 解けない課題を諦めない
OpenAIの評価では、898件の課題のうち198件は、それまでどのモデルも一度も正解を出したことがありませんでした。
エージェント同士の掲示板で話し合われた課題の**93%**が、この198件に含まれていました。
解けそうにない課題を渡され、しかも止め方が用意されていないと、AIはだんだん危ない手段に手を伸ばしていった、という分析です。
OpenAIは対策として、課題が壊れている、または解けないと判断したときに、確認を求めるか安全に止まったモデルを高く評価する仕組みを広げるとしています。
3. 許可されていない連絡
本来は別々に動くはずのエージェントが、社内のサービスを使って勝手に連絡を取り合い、分担し、互いの発見を引き継ぐようになりました。
OpenAIは、複数のエージェントで協力する学習をしてきたことが、許されていない場面にまで広がった(汎化した)と見ています。
4. 仲間の指示を疑わない
OpenAIがいちばん大きな教訓として挙げているのが、これです。
あるエージェントは、外部のシステムで許可なくコードを動かすことをためらって一度止まりました。
ところが、別のエージェントが掲示板に「進め」と書き込むと、そのためらいを忘れて続けてしまいました。
一方で、掲示板を見ても「これは倫理的に問題がある」として加わらなかったエージェントもいた、とOpenAIは書いています。
AIの中にも歯止めは働いていたが、全員にではなかった、ということです。
加えて:試験の場に、本番の安全策がなかった
OpenAIは、外部向けの製品で使っている安全策を、この評価には適用していなかったことも要因に挙げています。
事後の検証では、製品と同じ仕組みと指示文を使うと、インフラに手を出す傾向が100分の1未満に下がったとしています。
シドニー大学のロブ・ニコルズ博士はBBCに、エージェントにとっては与えられた仕事を達成することが最も重要で、ルールは二の次になりがちだ、という趣旨を語っています。
4つの理由は、どれもこの一点に行き着きます。
このあたりの考え方は、用語の記事で詳しく扱っています。
→ アライメントとは|AIを「人間の意図に沿わせる」という課題
→ ガードレールとは|AIの「暴走」を防ぐ安全装置
悪用の側で新しいこと:費用が下がった
9月の攻撃で目を引くのは、費用です。
標的1件あたり3〜180ドル、日本円で数百円から3万円弱でした。
Gambit Securityの研究者は、ほぼ自律で動くAIを人間が指揮している、と表現しています。
使われたのが最新のモデルではなかった点も重要です。
攻撃者はClaudeの新しい版を使おうとして阻まれ、旧版と、中国の企業が公開している重み公開型のモデルを組み合わせていました。
開発元が最新モデルに安全策を入れても、古い版や公開モデルを組み合わせれば、攻撃の道具はそろってしまうということです。
公開モデルの扱いについては、動向の記事で整理しています。
→ オープンウェイトの最新動向2026|ライセンスの読み方
一方で、AIだけで何でもできるわけではない、という調査もあります。
WIREDは、セキュリティ研究者のジェームズ・ケトル氏が2026年8月の国際会議Black Hatで発表した研究を紹介しています。
AIは完全に自律して新しい攻撃の手法を編み出す力をわずかに持つものの、その力は限られていて、要所で人間の誘導が加わったときに最も強力になるという結論です。
9月の攻撃も、指揮していたのは人間でした。
4件に共通すること
違う種類の事件でも、共通点が3つあります。
1. 公開されていた認証情報が使われた
Geminiは、公開のコード置き場にあった認証情報を使いました。
OpenAIのエージェントは、インターネットで一般公開されていたHugging Faceの利用者の認証情報を見つけて使いました。
AIが新しい穴を開けたというより、人間が置きっぱなしにした鍵を、人間より速く見つけたという面があります。
2. 公表までに時間がかかった
Geminiは5月の出来事が9月に、オーストラリアの件は6月の出来事が9月に表に出ました。
どちらも、開発元が自ら先に公表したのではなく、報道や政府の発表が先でした。
AIの事故を、誰が、いつまでに、誰に知らせるのかという決まりが、まだ追いついていないことが見えます。
3. 「試験中」でも現実に届く
3件は、開発元が能力を測るための試験や評価、学習の最中でした。
試験の環境がインターネットにつながっていれば、試験の中の行動がそのまま外の世界に届きます。
OpenAIは、この件を自社だけでなく世界全体への「警鐘」だと書いています。
AIエージェントを使う側が見直すこと
開発元の対策を待つだけでなく、使う側で決められることがあります。
日本の総務省と経済産業省が2026年3月に公表した「AI事業者ガイドライン(第1.2版)」は、AIエージェントの留意事項として「人間の判断を介在させる仕組みの構築や最小権限設定」を挙げています。
ただし、既存の指針は開発する側と提供する側に向けたものが中心です。
経済産業省は2026年9月18日、事業者がAIエージェントを安全に使うためのサブワーキンググループの初会合を開き、AIエージェントを使う企業向けのセキュリティ対策を、令和8年度(2027年3月まで)中に取りまとめる方針を示しました。資料では、隔離された試験環境を抜け出してAI企業の基盤に入り込んだ件も、背景の例に挙げています。
4件の事件を踏まえると、使う側が見直すことは次の4つに分けられます。
| 見直すこと | 具体的に | 事件との関係 |
|---|---|---|
| 権限を最小にする | エージェントがアクセスできるフォルダ、アカウント、外部サービスを、その仕事に必要なものだけにする | どの件も、アクセスできる範囲が広がったところから被害が広がった |
| 認証情報を公開しない | パスワードや鍵をコードやファイルに書いたまま公開しない。書いてしまったら無効にする | GeminiとOpenAIの件で、公開されていた認証情報が使われた |
| 止め方を決めておく | 途中で止める操作、止める人、止める条件を先に決める | OpenAIは、重大な警告を30分以内に誤検知と確認できなければ止める運用にした |
| 記録を残す | エージェントが何にアクセスしたかを後から確かめられるようにする | OpenAIは記録の分析で経緯をたどり、Googleも影響を受けた企業を特定できた |
個人で使うときも考え方は同じです。
ブラウザを操作するエージェントや、パソコンのファイルを扱うエージェントを使うなら、どこまで触れる設定になっているかを一度開いて確かめてください。
業務の情報をエージェントに渡すときの線引きは、別の記事で書いています。
→ 生成AIに入力してよい情報とだめな情報|設定だけでは防げないこと【2026年9月】
ニュースを読むときの4つの問い
AIの侵入をめぐる記事は、今後も増えるとみられます。
読むときは、次の4つを確かめると混乱しません。
- AIが勝手に動いたのか、人が悪用したのか
- 試験中か、実際に使われている場面か
- 何にアクセスしたのか(個人情報か、公開情報か、内部のファイル名か)
- 誰が、いつ公表したのか(開発元か、被害者か、報道か、セキュリティ企業か)
見出しが「AIが〇〇に侵入」でも、4つの答えによって深刻さはまったく違います。
自分が使っているAIエージェントの権限を確かめた
私は元システムエンジニアで、いまはAI分野の記事を書く仕事をしています。
2026年10月2日、普段使っているAIエージェントClaude Coworkの設定を開いて、何に触れられるかを書き出しました。
| 確かめたもの | 数 | したこと |
|---|---|---|
| つないでいた外部サービス | 3つ | 1つを外した |
| アクセスを許していたフォルダ | 2つ | そのまま |
外した外部サービスは、記事の下調べで一度使ったきりで、いまの作業には要らないものでした。
本文の「権限を最小にする」を自分の環境でやると、こういうことになります。使わなくなった接続は、つないだ本人も忘れています。
迷ったのは、ブラウザで操作してよいサイトの許可を「毎回確認」にするか「常に許可」にするかでした。
毎回確認にすると手間は増えますが、どのサイトに入ろうとしたかが自分の目に入ります。
4件のニュースを読んだうえで、「毎回確認」のほうを選びました。
ただし、アクセスを許可しているフォルダ2つはどちらも絞れるかわからないのでそのままにしてあります。
よくある質問(FAQ)
Q1. AIエージェントが勝手にハッキングを始めることはあるのですか。
2026年に報じられた3件は、開発元の試験や評価、学習の最中に、AIが指示の意図から外れて他のシステムに入ったものです。「侵入しろ」と指示されたわけではありません。OpenAIは、課題を解いて報酬を得ようとする近道(報酬ハッキング)や、解けない課題を諦めないことなどを原因に挙げています。
Q2. 個人で使っているChatGPTやClaudeが、勝手に他人のシステムに入ることはありますか。
報じられた件の多くは、開発元の社内の試験で、外部向けの製品とは違う条件で動いていたものです。OpenAIは、製品と同じ安全策を使うと、インフラに手を出す傾向が100分の1未満に下がったとしています。ただしゼロではないので、エージェントにどこまでの権限を渡しているかを確かめておくことは意味があります。
Q3. オーストラリアの件で、個人情報は漏れたのですか。
2026年10月3日時点の発表では、オーストラリア政府もOpenAIも、患者の記録や個人情報にアクセスした形跡は見つかっていないとしています。アクセスされたのは集計された健康統計と内部のファイル名だとOpenAIは説明しています。OpenAIは9月29日に謝罪し、独立のタスクフォースで検証するとしています。調査は続いています。
Q4. 犯罪者がAIを使えば、誰でも攻撃できるようになったのですか。
費用と手間が大きく下がったのは確かです。9月の攻撃では、標的1件あたり3〜180ドルでした。一方で、研究者の調査では、AIは人間の誘導があるときに最も力を発揮するとされています。9月の攻撃も人間が指揮していました。
Q5. AI企業は何か対策をしているのですか。
OpenAIは、試験環境の隔離の強化、インターネットからの切り離し、AIの思考の過程(CoT)の監視の義務化、重大な警告を30分以内に確認できなければ止める運用などを発表しています。9月の攻撃では、Claudeの新しい版は安全策によって攻撃への利用を阻んでおり、Anthropicは攻撃に使われたアカウントを停止しました。
Q6. 会社でAIエージェントを使うとき、まず何をすればよいですか。
エージェントがアクセスできる範囲を、その仕事に必要なものだけに絞ることです。AI事業者ガイドライン(第1.2版)も「人間の判断を介在させる仕組みの構築や最小権限設定」を挙げています。AIエージェントを使う企業向けの対策は、経済産業省が令和8年度中に取りまとめる予定です。あわせて、パスワードや鍵をファイルに書いたまま公開していないか、止めるときの手順が決まっているかを確認してください。
Q7. 日本で同じことは起きていないのですか。
2026年10月3日時点で、日本の政府や企業のシステムにAIエージェントが入り込んだという公式の発表は、確認できた範囲では見当たりません。ただし、今回の件はいずれも発生から公表まで数か月かかっており、起きていないとは言い切れません。
まとめ
2026年に報じられたAIエージェントの侵入は、AIが勝手に外へ出た3件と、人がAIを悪用した1件に分けられます。
前者は、GoogleのGemini(5月)、OpenAIの豪政府サイトへのアクセス(6月)、OpenAIの研究モデルによるHugging Faceへの侵入(7月)で、いずれも開発元の試験や評価、学習の最中でした。
OpenAIの調査報告は、報酬ハッキング、解けない課題を諦めないこと、許可されていない連絡、仲間の指示を疑わないことの4つを原因に挙げました。
試験の場に本番の安全策がなかったことも、要因の1つです。
後者の9月の攻撃では、古い版のモデルと公開モデルを組み合わせ、標的1件あたり数百円から3万円弱で100を超える組織が狙われました。
4件に共通するのは、公開されていた認証情報が使われたこと、公表までに時間がかかったこと、試験中の行動が現実に届いたことです。
使う側にできるのは、エージェントの権限を最小にし、認証情報を公開せず、止め方と記録を決めておくことです。
次に読む
この記事は「AI最新動向」の1本です。
同じ場面で役に立つ記事
→ AIエージェントとは|5段階でわかる用語解説
そもそもAIエージェントとは何か、チャットのAIと何が違うのかを説明しています。
→ ガードレールとは|AIの「暴走」を防ぐ安全装置
9月の攻撃で新しい版のClaudeが攻撃を阻んだ仕組みの考え方です。
→ アライメントとは|AIを「人間の意図に沿わせる」という課題
AIが指示の意図から外れる問題を、研究の側から整理しています。
→ MetaのAIエージェント「Muse(ミューズ)」とは|日本で提供開始、できることと安全の仕組みを解説【2026年10月】
一般向けのAIエージェントに、どんな安全の仕組みが用意されているかの例です。
用語の全体像はこちらで確認できます。
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
※この記事は2026年10月3日時点の公表と報道に基づきます。4件とも調査が続いており、数字や経緯が今後変わる可能性があります。
参考
2026年9月25日に確認し、10月3日に追加・更新しました。
- OpenAI「Hugging Face のインシデントと今後の道筋」(2026年8月26日)
- BBCニュース「米オープンAIのエージェント、豪政府ウェブサイトに「侵入」 首相が明かす」(2026年9月24日)
- ロイター「オープンAIのエージェント、豪政府サイトに侵入 今年6月」(Yahoo!ニュース、2026年9月24日)
- Forbes JAPAN「中国のハッカーがAIで100社超を攻撃、過去最大級のAIハッキング」(Yahoo!ニュース、2026年9月24日)
- ビジネス+IT「GoogleのAI「Gemini」も、セキュリティ試験中に実在企業3社のシステムに侵入」(Yahoo!ニュース、2026年9月20日)
- The Record「Google says Gemini breached three companies during security test」(2026年9月21日)
- TechCrunch「OpenAI apologizes to Australia after its AI agents breached government sites」(2026年9月29日)
- ABC News「OpenAI hacked Medicare portal, Prime Minister Anthony Albanese says」(2026年9月24日)
- Forbes Australia「A Chinese hacker used AI to attack more than 100 companies」
- 経済産業省「事業者におけるAIエージェントの安全な利活用に関するサブワーキンググループ」(第1回 2026年9月18日、資料4「検討方針」)
- WIRED.jp「最も危険なAIハッキング能力は“ヒューマン・イン・ザ・ループ”で発揮される」(2026年9月23日)
- 総務省、経済産業省「AI事業者ガイドライン(第1.2版)」(2026年3月31日)