AI技術は、ほぼすべて機械学習の上に成り立っています。
つまり、機械学習の考え方を一度理解できれば、AI関連の話題もぐっとわかりやすくなります。逆にここがあいまいなままだと、「AIが学習する」「学習データが問題になってくる」といったこともわかりにくいかもしれません。
逆にいえば、機械学習の考え方が一度つかめれば、AIの話題の多くは自力で読めるようになります。
この記事では、機械学習の説明を5つのレベルに分けて並べました。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(8分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(10分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(10分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で通り過ぎます。
1分で腕試し
理解度から決めたい場合は、次の4問を試してください。
Q1〜Q4は、Level 1〜4の内容に1問ずつ対応しています。
最初にまちがえた問題のLevelが、あなたのスタート地点です。
4問とも正解なら、Level 5から読んでください。
各レベルの終わりにも、4択の理解度チェックがあります。
ITパスポート試験などの過去問題も入れています。
AIという言葉そのものが曖昧だと感じる場合は、先にこちらを読むと入りやすくなります。
→ AIとは何か|子供向けから専門的な話まで5段階でわかる用語解説
Q1.【オリジナル】コンピュータに「写真にネコが写っているか」を見分けさせたい。機械学習のやり方で、人間が主に用意するものはどれか。
- ア 答えのついていない写真を1枚だけ
- イ 「耳が三角ならネコ」のような見分け方を、例外まですべて書いた説明書
- ウ ネコを見分けるための専用の機械
- エ 「ネコ」「ネコではない」の答えがついた写真をたくさん
正解:エ
解説:
機械学習では、やり方を書く代わりに、答えつきの例をたくさん見せます。
イは、これまでのプログラムの作り方です。例外がいつまでも出てくるので、書き切れません。
アは、1枚ではコツをつかむ材料になりません。
ウは道具の話で、学び方とは関係がありません。
→ まちがえたら Level 1から
Q2.【オリジナル】これまでのプログラムと機械学習の違いを説明したものとして、最も適切なものはどれか。
- ア 機械学習はルールを使わないので、出てくる答えに規則性はない
- イ これまでのプログラムは答えを覚え、機械学習はルールを人間が書く
- ウ これまでのプログラムはルールが先で答えが後、機械学習は入力と答えの組からルールのほうを見つける
- エ 違いは処理の速さだけで、作り方は同じ
正解:ウ
解説:
機械学習は、ルールと答えの順序を逆にした作り方です。
イは、説明が逆になっています。
アは誤りです。機械学習は、データの中の規則性を見つけています。
エは誤りです。違うのは速さではなく、ルールを誰が見つけるかです。
→ まちがえたら Level 2から
Q3.【オリジナル】あるモデルが、学習に使ったデータでは正解率99%だった。このモデルの実力を確かめる方法として、最も適切なものはどれか。
- ア 学習データを2倍に増やしてから、同じデータで測る
- イ 99%なら十分なので、追加の確認はいらない
- ウ 同じ学習データで、もう一度測る
- エ 学習に使っていない、評価用のデータで測る
正解:エ
解説:
学習に使ったデータの点数は、覚えこんだだけでも高くなります。
実力は、学習中に一度も見せていないデータで測ります。
アとウは、どちらも学習に使ったデータで測っているので、過学習を見つけられません。
イは、まさに過学習を見落とすときの考え方です。
→ まちがえたら Level 3から
Q4.【オリジナル】1000件の取引のうち、10件だけが不正である。全件を「不正なし」と判定するモデルについて、正しいものはどれか。
- ア 正解率は99%で、不正を見つける力も高い
- イ 正解率は1%なので、すぐに失敗だと分かる
- ウ 正解率は99%だが、不正は1件も見つけられていない
- エ 不正が少ないデータでは、正解率だけを見れば十分である
正解:ウ
解説:
990件の正常な取引を当てているので、正解率は99%になります。
しかし、10件の不正は1件も見つけていません。
アは、正解率の高さと不正を見つける力を取り違えています。
イは計算が違います。当たったのは990件です。
エは逆です。答えが片方に偏っているときほど、正解率だけで判断してはいけません。
→ まちがえたら Level 4から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
AIという言葉そのものが曖昧だと感じる場合は、先にこちらを読むと入りやすくなります。
→ AIとは何か|子供向けから専門的な話まで5段階でわかる用語解説
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:機械学習を「まちがえながら上手になっていくやり方」だと自分の言葉で言える
教え方が、これまでと逆になった
自転車の乗り方を、言葉だけで教えられるでしょうか。
「ハンドルを右に3度傾けて、体重を左に5%移して」と書いた紙を渡しても、たぶん乗れるようにはなりません。
実際に何度も転んで、体でつかむしか、自転車には乗れるようにはなれません。
コンピュータにも、同じ種類の問題があります。
「合計が1000円以上なら送料は無料」のように、やることを言葉で書ける仕事なら、人間がその通りに書けば済みます。
ところが「この写真にネコが写っているか」を言葉で書こうとすると、いくら書いても足りません。
後ろ姿のネコ、暗いところのネコ、ネコの着ぐるみを着た人。例外がいつまでも出てきます。
そこで、教え方をひっくり返します。
やり方を教える代わりに、答えつきの例をたくさん見せる。そして、まちがえたら「そこはちがうよ」と教える。
これを何万回も繰り返すと、コンピュータは自分でコツをつかみます。
このやり方を機械学習といいます。
学び方は3種類ある
機械学習の学び方は、大きく3つに分かれます。
自分が何かを覚えるときのことを思い出すと、そのまま当てはまります。
1つ目に、答え合わせをしてもらう学び方があります。
漢字ドリルのように、問題と答えがセットで用意されていて、まちがえたら直してもらう。
これが教師あり学習です。
2つ目には、仲間分けをする学び方もあります。
おもちゃ箱をひっくり返して、なんとなく似ているもの同士を集める。
誰も正解を教えてくれませんが、グループはできます。
これが教師なし学習です。
そして、3つ目には点数をもらいながらうまくなる学び方もあります。
ゲームで、うまくいくと点が入り、失敗すると減る。
何度も遊ぶうちに、点が高くなる遊び方を覚えていく。
これが強化学習です。
たくさん見せれば見せるほど、というわけでもない
ここでひとつ、大事な注意があります。
同じ問題集を100回やった人は、その問題集は満点になります。
でも、テストで少し違う問題が出ると解けないことがあります。
答えを覚えてしまっただけで、考え方をつかんでいなかったからです。
コンピュータにも、まったく同じことが起きます。
見せた例だけは完璧なのに、初めて見るものにはまるで当たらない。
これは機械学習でいちばん有名な失敗で、これを過学習と呼んでいます。
つまずきポイント
「AIと機械学習は同じもの?」
違います。
AIのほうが大きい言葉で、機械学習はその中の一つのやり方です。
AIという箱の中に、機械学習という道具が入っていると考えてください。
ここがあやふやなら、先にAIの記事のLevel 1と2を読むと整理できます。
→ AIとは何か|子供向けから専門的な話まで5段階でわかる用語解説
理解度チェック
Q1.【オリジナル】AIと機械学習の関係を説明したものとして、最も適切なものはどれか。
- ア AIと機械学習は、関係のない別々の技術である
- イ 機械学習のほうが大きい言葉で、AIはその中の一つのやり方である
- ウ AIのほうが大きい言葉で、機械学習はその中の一つのやり方である
- エ AIと機械学習は、同じものを指す別の呼び方である
正解:ウ
解説:
AIは大きな箱の名前で、機械学習はその中に入っている道具の一つです。
エは、いちばんよくあるまちがいです。同じものではありません。
イは、大きさの関係が逆になっています。
アは誤りです。機械学習はAIの中に入っているので、関係がないわけではありません。
→ 「つまずきポイント」に戻る
Q2.【オリジナル】漢字ドリルのように、問題と答えがセットで用意されていて、まちがえたら直してもらう学び方を何というか。
- ア 教師なし学習
- イ 過学習
- ウ 強化学習
- エ 教師あり学習
正解:エ
解説:
答え合わせをしてもらう学び方は、教師あり学習です。
アの教師なし学習は、答えを教えてもらわずに、似たもの同士を仲間分けする学び方です。
ウの強化学習は、点数をもらいながらうまくなる学び方です。
イの過学習は、学び方の名前ではありません。覚えこみすぎて、初めての問題に弱くなる失敗のことです。
→ 「学び方は3種類ある」に戻る
Q3.【オリジナル】おもちゃ箱をひっくり返して、なんとなく似ているもの同士を集める。誰も正解は教えてくれないが、グループはできる。この学び方を何というか。
- ア 教師あり学習
- イ 教師なし学習
- ウ 強化学習
- エ 過学習
正解:イ
解説:
正解を教えてもらわずに、似ているもの同士をまとめる学び方が、教師なし学習です。
アの教師あり学習は、正解を教えてもらう学び方です。
ウの強化学習は、点数を手がかりにうまくなる学び方です。
エの過学習は、学び方ではなく失敗の名前です。
→ 「学び方は3種類ある」に戻る
Q4.【オリジナル】ゲームで、うまくいくと点が入り、失敗すると点が減る。何度も遊ぶうちに、点が高くなる遊び方を覚えていく。この学び方を何というか。
- ア 教師なし学習
- イ 教師あり学習
- ウ 強化学習
- エ 過学習
正解:ウ
解説:
正解のかわりに点数をもらい、点が高くなるやり方を覚えていくのが、強化学習です。
「どう動けば正解か」は教わらず、結果の点数だけを手がかりにします。
イの教師あり学習は、答えそのものを教えてもらう点が違います。
アの教師なし学習は、点数も正解ももらわずに仲間分けをします。
エの過学習は、学び方の名前ではありません。
→ 「学び方は3種類ある」に戻る
Q5.【オリジナル】同じ問題集を100回解いて満点になった人が、テストで少し違う問題を出されると解けなかった。いちばん大きな理由はどれか。
- ア 問題集を解いた回数が、まだ足りなかったから
- イ 答えを覚えただけで、考え方をつかんでいなかったから
- ウ 問題集の問題の数が少なすぎたから
- エ テストの問題が、問題集よりも簡単すぎたから
正解:イ
解説:
答えを覚えてしまうと、見たことのある問題だけは解けますが、初めての問題には弱くなります。
コンピュータで同じことが起きた状態を、過学習と呼びます。
アのように回数を増やしても、覚えこみが進むだけで、初めての問題が解けるようにはなりません。
ウとエは、この話の原因ではありません。
→ 「たくさん見せれば見せるほど、というわけでもない」に戻る
ここまで読めば言えるようになること
- [ ] 機械学習を「例を大量に見せて覚えさせるやり方」と説明できる
- [ ] 3つの学び方の名前を挙げられる
- [ ] 覚えこみすぎると初めての問題に弱くなると説明できる
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(例を見せて覚えさせるやり方、3つの学び方)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:「ルールを書かない」という発想の転換を説明でき、3つの学び方を使い分けの視点で語れる
従来のプログラムと、どこが逆なのか
従来のプログラムは、人間が書いたルールの通りに動きます。
入力とルールを与えると、出力が決まる。
順序としては、ルールが先で、答えが後です。
機械学習は、この順序を逆にします。
入力と答えの組を大量に与えて、その間にあるルールのほうをコンピュータに見つけさせる。
答えが先で、ルールが後です。
この逆転が、機械学習の中身のすべてと言ってよいくらい大事な点です。
「AIが学習する」と言われるときに起きているのは、この規則性の発見です。
AI、機械学習、ディープラーニングの関係
用語の関係を整理しておきます。
AIがいちばん広い総称で、その中の主要な手法が機械学習、さらにその中の一手法がディープラーニングです。
入れ子の関係になっています。
ディープラーニングは、機械学習の中でも、着目すべき特徴の見つけ方まで自動化した手法です。
ChatGPTのような生成AIも、ディープラーニングで作られています。
つまり「生成AIは機械学習なのか」という問いへの答えは、はいです。
3つの学び方は、正解の与え方で分かれる
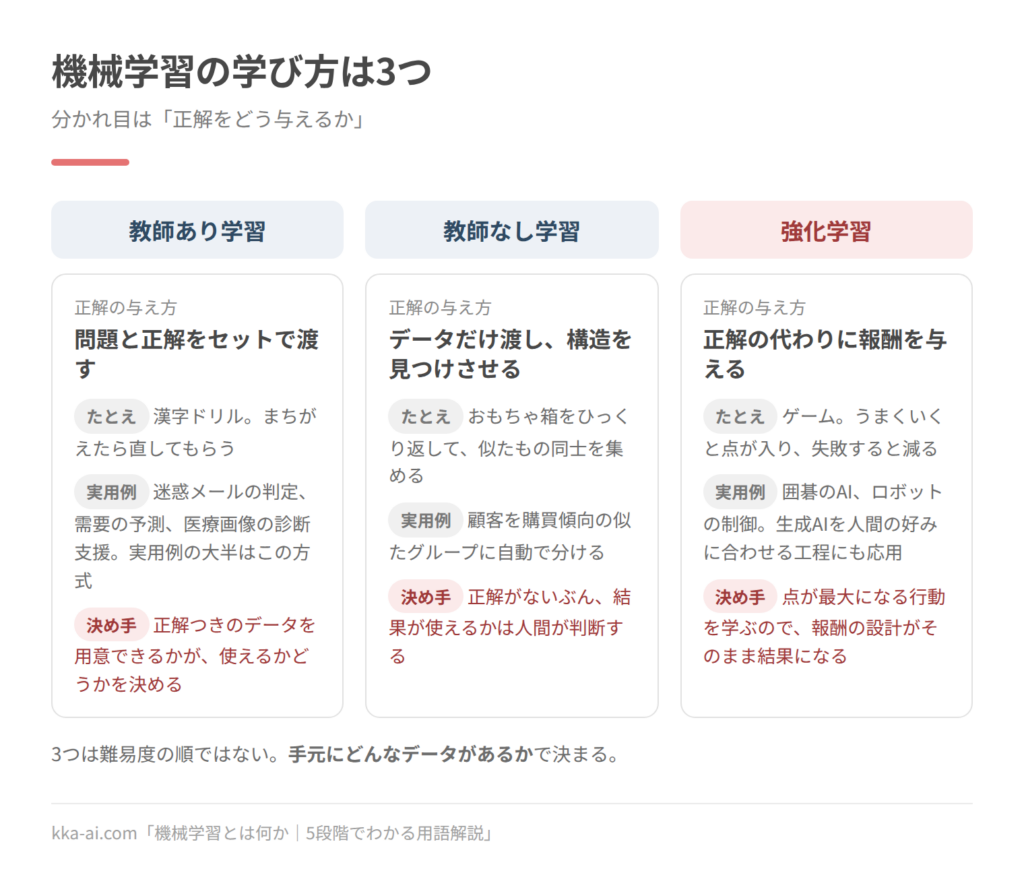
Level 1で挙げた3つの学び方は、正解をどう与えるかで区別できます。
教師あり学習は、問題と正解をセットで渡します。
迷惑メールの判定、需要の予測、医療画像の診断支援など、実用例の大半はこの方式です。
正解つきのデータを用意できるかどうかが、そのまま使えるかどうかを決めます。
教師なし学習は、正解を渡さずにデータだけを渡し、その中の構造を見つけさせます。
顧客を購買傾向の似たグループに自動で分ける、といった使い方をします。
正解がないぶん、出てきた結果が使えるかどうかは人間が判断することになります。
強化学習は、正解の代わりに報酬を与えます。
うまくいったら加点、失敗したら減点を繰り返し、点が最大になる行動を学ばせます。
囲碁のAIやロボットの制御で使われ、生成AIを人間の好みに合わせて調整する工程にも応用されています。
身近なところで、すでに動いている
機械学習は、生成AIのブームよりずっと前から生活に入っています。
最もわかりやすいのが、メールソフトの迷惑メール判定です。
迷惑メールの条件を人間が書こうとすると、すぐに破綻します。
「無料という単語を含む」と書けば正常なメールまで弾かれますし、送る側は表記を変えて回避してきます。
機械学習の方式では、大量の迷惑メールと正常なメールを見せて、両者を分ける特徴を統計的に見つけさせます。
新しい手口が出てきても、新しいデータで学習し直せば追いつけます。
迷惑メールを手で報告するボタンがあるのは、その報告が次の学習データになっているからです。
このほか、通販サイトのおすすめ表示、クレジットカードの不正利用の検知、地図アプリの到着時刻の予測も、すべて機械学習です。
つまずきポイント
「学習と推論は何が違うの?」
学習は、データを読ませてモデルを作る工程です。
推論は、できあがったモデルを使って実際に答えを出す工程です。
学習は時間と費用がかかる一度きりの作業、推論は使うたびに走る作業だと考えると区別しやすくなります。
理解度チェック
Q1.【オリジナル】機械学習で、コンピュータに見つけさせるものはどれか。
- ア 入力と答えの組の間にある、ルール(規則性)
- イ 計算を速くするための、処理の順番
- ウ 人間が書いたルールの中の、まちがい
- エ インターネット上にある、問題の正解
正解:ア
解説:
機械学習では、入力と答えの組を大量に与えて、その間にあるルールのほうを見つけさせます。
「AIが学習する」と言われるときに起きているのは、この規則性の発見です。
ウは、人間がルールを書くこれまでのプログラムを前提にしています。
イとエは、学習の中身とは関係がありません。
→ 「従来のプログラムと、どこが逆なのか」に戻る
Q2.【IPA過去問】教師あり学習において,正解となる情報を付与する作業を表す用語として,最も適切なものはどれか。
- ア アノテーション
- イ エンコード
- ウ データクレンジング
- エ フィルタリング
出典:令和8年度 ITパスポート試験 公開問題 問16
正解:ア
解説:
アノテーションは、データに正解の情報(ラベル)を付ける作業です。
写真に「ネコ」「ネコではない」と付けるのが、これにあたります。
教師あり学習の「問題と正解のセット」のうち、正解のほうを作る作業です。
イのエンコードは、データを決まった形式に変換すること(符号化)です。
ウのデータクレンジングは、誤記や重複、欠けを直して、データを整える作業です。Level 3で出てくる「前処理」にあたります。
エのフィルタリングは、条件に合うものだけを選び出す(または取り除く)処理です。
→ 「3つの学び方は、正解の与え方で分かれる」に戻る
Q3.【オリジナル】AI、機械学習、ディープラーニングの関係として、最も適切なものはどれか。
- ア 3つは別々の技術で、重なる部分はない
- イ 機械学習がいちばん広く、その中にAIとディープラーニングが並んで入っている
- ウ ディープラーニングがいちばん広く、その中に機械学習が入っている
- エ AIがいちばん広く、その中に機械学習、さらにその中にディープラーニングが入っている
正解:エ
解説:
AIが総称で、その中の主要な手法が機械学習、さらにその中の一手法がディープラーニングです。
生成AIはディープラーニングで作られているので、生成AIも機械学習の一種です。
イとウは、入れ子の順番が違います。
アは誤りです。3つは入れ子の関係にあります。
→ 「AI、機械学習、ディープラーニングの関係」に戻る
Q4.【オリジナル】教師なし学習の使い方として、最も適切なものはどれか。
- ア 過去に判定済みのメールから学んで、迷惑メールかどうかを見分ける
- イ 顧客を、購買傾向の似たグループに自動で分ける
- ウ 過去の売上の実績から、来月の売上を予測する
- エ 囲碁で、勝ったときに得点を与えながら打ち方を学ばせる
正解:イ
解説:
教師なし学習は、正解を渡さずにデータだけを渡し、その中の構造を見つけさせます。
顧客のグループ分けは、「この顧客はこのグループ」という正解がない状態で行うので、教師なし学習です。
アとウは、正解つきの過去のデータから学ぶので、教師あり学習です。
エは、得点(報酬)を手がかりにするので、強化学習です。
→ 「3つの学び方は、正解の与え方で分かれる」に戻る
Q5.【オリジナル】機械学習でいう「推論」の説明として、最も適切なものはどれか。
- ア モデルの性能が落ちてきたときに、学習し直す工程
- イ データを読ませて、モデルを作る工程
- ウ できあがったモデルを使って、実際に答えを出す工程
- エ 集めたデータの誤記や重複を直す工程
正解:ウ
解説:
推論は、できあがったモデルを使って答えを出す工程で、使うたびに走ります。
イは「学習」です。時間と費用がかかる、一度きりの作業です。
エは、Level 3で出てくる「前処理」です。
アは、Level 4で出てくる「再学習」です。
→ 「つまずきポイント」に戻る
ここまで読めば言えるようになること
- [ ] ルールと答えの順序が逆になっていると説明できる
- [ ] AI、機械学習、ディープラーニングの入れ子関係を説明できる
- [ ] 3つの学び方を、正解の与え方の違いで区別できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(ルールと答えの順序、3つの学び方)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:機械学習の工程を5つに分けて説明でき、過学習が何を意味するか判断材料として使える
学習は工程の一部でしかない
データを見せれば勝手に賢くなる、という印象を持たれがちですが、実際の機械学習は前後に多くの工程を抱えています。
- データの収集:目的に合うデータを、十分な量だけ集める
- データの前処理:誤記、欠け、重複を直し、学習に使える形に整える
- 学習:整えたデータでモデルを訓練する
- 評価:学習に使っていないデータで実力を測る
- 運用と再学習:実環境で使いながら性能の劣化を監視し、学習し直す
実務で最も時間がかかるのは、3の学習ではなく、1と2のデータ準備です。
「AIを導入したが成果が出ない」という事例の多くは、モデルの性能ではなく、データの量と質の問題に行き着きます。
過学習は、評価の工程で見つかる
4の評価で決定的に重要なのが、学習に使っていないデータで測るという点です。
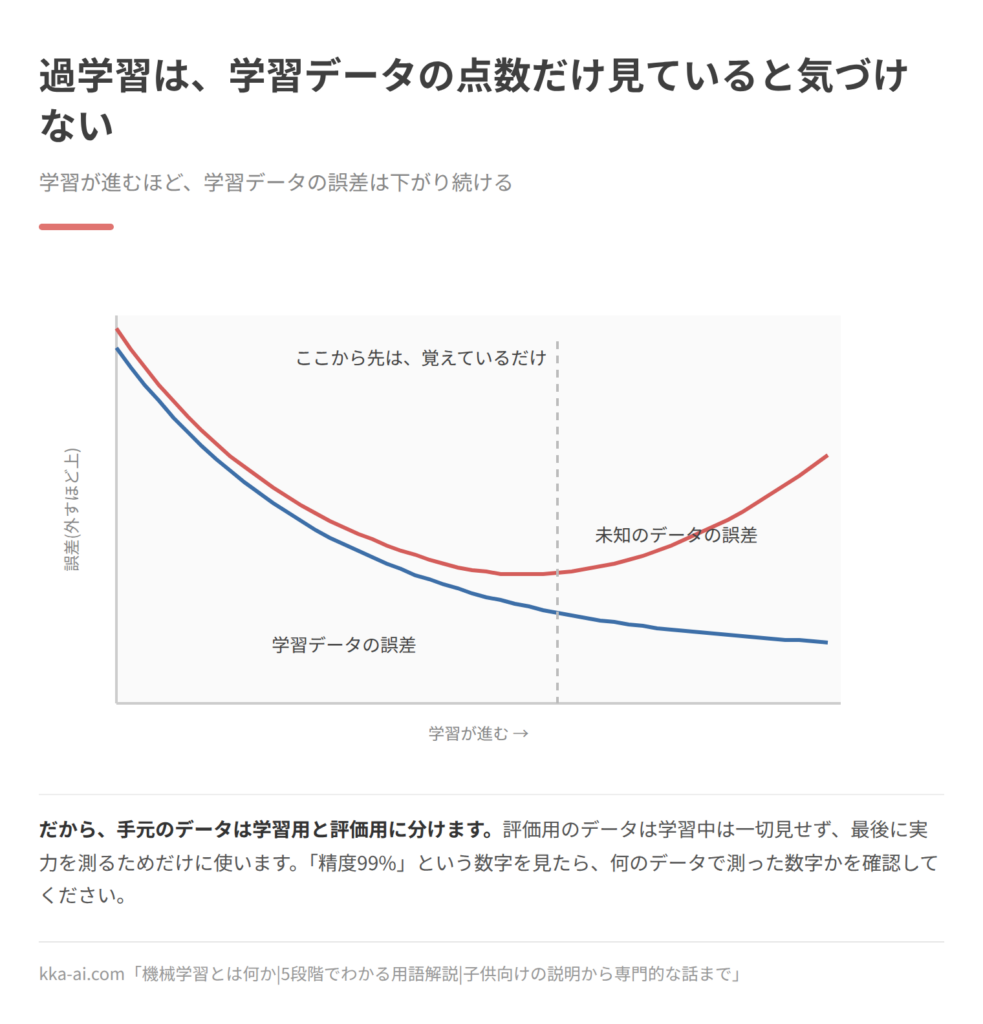
学習データでは満点なのに、新しいデータではまるで当たらない状態を過学習と呼びます。
問題集を暗記して模試は乗り切ったが、本番で解けない受験生と同じ状態です。
だからこそ、手元のデータは学習用と評価用に分けます。
評価用のデータは学習中は一切見せず、最後に実力を測るためだけに使います。
この分け方をしていない評価には意味がありません。
「精度99%」という数字を見たら、何のデータで測った数字かを確認する。
過学習という言葉を知っているだけで、この視点が持てるようになります。
分類と回帰
教師あり学習は、出したい答えの種類によって、さらに2つに分かれます。
分類は、どのグループに属するかを当てる問題です。
このメールは迷惑メールか否か、この画像はネコか犬か、この顧客は解約するか否か。
答えが選択肢の中から選ばれます。
回帰は、数値を当てる問題です。
来月の売上はいくらか、この物件の価格はいくらか、到着まで何分かかるか。
答えが連続した値になります。
自社の課題がどちらなのかを言えるだけで、外部への相談は一気に具体的になります。
特徴量という考え方
機械学習では、データのどの部分に注目させるかを決める必要があります。
この注目する項目を特徴量と呼びます。
中古車の価格を予測するなら、走行距離、年式、車種、事故歴などが特徴量の候補です。
何を特徴量にするかで精度は大きく変わり、ディープラーニング以前の機械学習では、ここが人間の腕の見せどころでした。
ディープラーニングは、この特徴量の設計まで自動化した手法です。
画像や音声のように、人間が特徴を言語化しにくいデータで強いのはこのためです。
逆に、表形式のデータのように特徴が明確な場合は、ディープラーニングでなくても十分に戦えます。
つまずきポイント
「ディープラーニングを使えば、いつでも精度が上がるのでは?」
上がりません。
表形式のデータで件数が数千件程度なら、勾配ブースティングなどの手法のほうが精度も速度も上回ることがよくあります。
ディープラーニングが効くのは、データが大量にあり、かつ特徴を人間が言語化しにくい場合です。
この違いがぴんとこない場合は、特徴量の項に戻ってください。
理解度チェック
Q1.【オリジナル】機械学習の5つの工程のうち、実務で最も時間がかかることが多いのはどれか。
- ア データの収集と前処理
- イ 運用と再学習
- ウ 評価
- エ 学習(モデルの訓練)
正解:ア
解説:
実務で最も時間がかかるのは、学習そのものではなく、データの準備です。
目的に合うデータを集め、誤記や欠け、重複を直して、学習に使える形に整えます。
「AIを導入したが成果が出ない」という事例の多くも、モデルの性能ではなく、データの量と質の問題に行き着きます。
イ、ウ、エも欠かせない工程ですが、かかる時間はデータ準備ほど大きくならないことが多いです。
→ 「学習は工程の一部でしかない」に戻る
Q2.【IPA過去問】AIにおける機械学習の学習方法に関する次の記述中のa~cに入れる字句の適切な組合せはどれか。
教師あり学習は,正解を付けた学習データを入力することによって,〔 a 〕と呼ばれる手法で未知のデータを複数のクラスに分けたり,〔 b 〕と呼ばれる手法でデータの関係性を見つけたりすることができるようになる学習方法である。教師なし学習は,正解を付けない学習データを入力することによって,〔 c 〕と呼ばれる手法などで次第にデータを正しくグループ分けできるようになる学習方法である。
- ア a 回帰 b 分類 c クラスタリング
- イ a クラスタリング b 分類 c 回帰
- ウ a 分類 b 回帰 c クラスタリング
- エ a 分類 b クラスタリング c 回帰
出典:令和6年度 ITパスポート試験 公開問題 問65(選択肢の表を箇条書きに改変)
正解:ウ
解説:
未知のデータをクラス(グループ)に分けるのが分類、数値の関係性を見つけて値を当てるのが回帰です。
どちらも正解つきのデータから学ぶので、教師あり学習に入ります。
正解を付けずに、似たもの同士をグループ分けする手法がクラスタリングで、教師なし学習の代表です。
アは、aとbが入れ替わっています。
イとエは、教師なし学習の手法であるクラスタリングを、教師あり学習の側に入れています。
→ 「分類と回帰」に戻る
Q3.【オリジナル】学習が進むにつれて、学習データの誤差は下がり続けた。一方、学習に使っていないデータの誤差は、途中から上がり始めた。この状態の説明として、最も適切なものはどれか。
- ア 学習データを覚えこみすぎて、初めて見るデータに当たらなくなっている
- イ 学習が足りないので、さらに学習を続ければ、学習に使っていないデータの誤差も下がる
- ウ 学習データの誤差が下がっているので、モデルの実力は上がっている
- エ 学習に使っていないデータのほうがおかしいので、評価から外してよい
正解:ア
解説:
学習データだけに当てはまり、新しいデータに当たらなくなった状態が過学習です。
誤差が上がり始めた地点から先は、データを覚えているだけになっています。
イは逆です。学習を続けるほど、過学習は進みます。
エは、過学習を見つけるための評価用データを捨ててしまう考え方です。
ウは、学習データの点数だけを見て実力を判断する、典型的な見落としです。
→ 「過学習は、評価の工程で見つかる」に戻る
Q4.【オリジナル】中古車の価格を予測するモデルを作る。特徴量として使うのが適切でないものはどれか。
- ア その車が実際に売れた価格
- イ 事故歴
- ウ 年式
- エ 走行距離
正解:ア
解説:
特徴量は、答えを当てるために注目させる項目です。
走行距離、年式、事故歴は、価格の手がかりになる特徴量の候補です。
アは、当てたい答えそのものです。
答えを特徴量に入れると、学習中は満点に近くなりますが、本番では使えません(予測したい時点では、売れた価格はまだ分かっていません)。
この種のまちがいは、Level 4で出てくる「データリーケージ」にあたります。
→ 「特徴量という考え方」に戻る
Q5.【オリジナル】ディープラーニングについて、最も適切なものはどれか。
- ア 特徴量の設計まで自動化した手法で、画像や音声のように、特徴を言葉にしにくいデータに強い
- イ 表形式で数千件程度のデータのときに、最も力を発揮する
- ウ どんなデータでも、ほかの手法より必ず精度が高い
- エ 特徴量を、人間がすべて手で設計する必要がある
正解:ア
解説:
ディープラーニングは、どこに注目するか(特徴量)まで自動で見つける手法です。
人間が特徴を言葉にしにくい画像や音声で、強さを発揮します。
ウは誤りです。データの種類と量によって、ほかの手法が上回ることはよくあります。
エは、ディープラーニング以前の機械学習の説明です。
イは逆です。表形式で数千件程度なら、勾配ブースティングなどの手法のほうが、精度も速度も上回ることがよくあります。
→ 「つまずきポイント」に戻る
ここまで読めば言えるようになること
- [ ] 機械学習の5工程を挙げ、どこに時間がかかるか説明できる
- [ ] 過学習を、評価方法とセットで説明できる
- [ ] 自社の課題が分類か回帰かを言える
- [ ] 特徴量という言葉を使って、ディープラーニングの位置づけを説明できる
仕事で発注や導入判断をする立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(5つの工程、過学習、分類と回帰)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:精度の数字を業務の判断に翻訳でき、失敗しやすい箇所を先回りできる
精度という一語で会話をしない
機械学習の提案で最初に出てくるのが精度の数字ですが、この一語のまま議論すると、たいてい判断を誤ります。
たとえば、1000件のうち10件だけ不正がある取引を判定するモデルを考えます。
全件を「不正なし」と答えるだけのモデルでも、正解率は99%になります。
数字は立派ですが、不正は1件も見つけられていません。
そこで、業務では次の2つに分けて見ます。
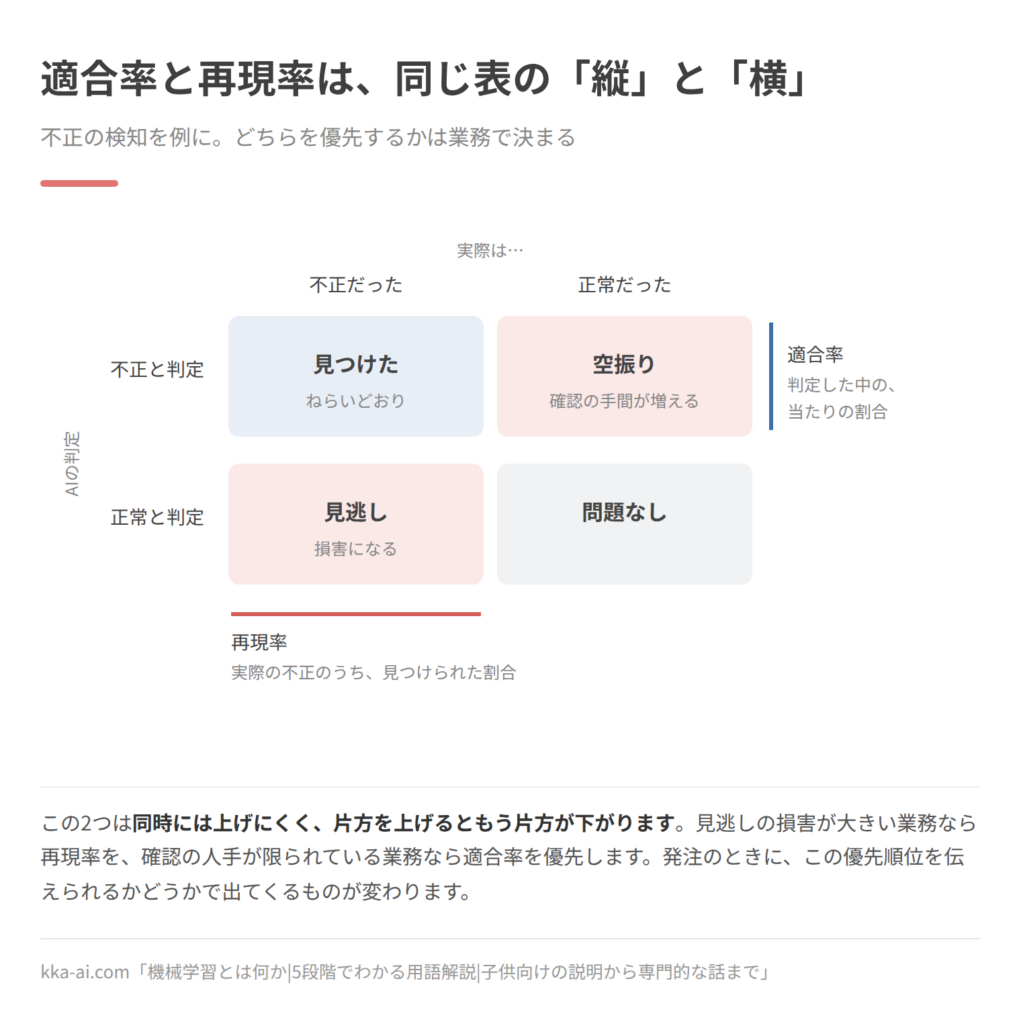
適合率は、不正だと判定したもののうち、実際に不正だった割合です。
これが低いと、現場が空振りの確認作業に追われます。
再現率は、実際の不正のうち、見つけられた割合です。
これが低いと、見逃しが発生します。
この2つは同時には上げにくく、片方を上げるともう片方が下がります。
どちらを優先するかは技術の問題ではなく、業務の問題です。
見逃しの損害が大きい業務なら再現率を、確認作業の人手が限られている業務なら適合率を優先します。
発注時にこの優先順位を伝えられるかどうかで、出てくるものが変わります。
データがないなら、そこから始める
導入検討が止まる最大の理由は、モデルではなくデータです。
教師あり学習を使うには、正解つきのデータが要ります。
過去の判断結果が紙にしか残っていない、担当者の頭の中にしかない、システムに入っているが項目が揃っていない。
このどれかに当たることが少なくありません。
この場合、いきなりモデルを作る話にはなりません。
先に、判断結果を電子的に、揃った項目で記録し続ける運用を作ります。
半年から1年ぶんのデータが貯まってから学習に進む、という順序が現実的です。
逆にいえば、「今はまだAIを使わないが、将来使うかもしれない」という段階でも、記録の仕方を整えておくことには意味があります。
費用の内訳は、モデル以外に偏る
外部に発注する場合、費用は次のように分かれます。
- データの整備と前処理:全体の半分以上を占めることが多い
- モデルの構築と評価:想像されるより小さい
- システムへの組み込み:既存システムの改修規模に依存する
- 運用と再学習:月額で継続的に発生する
見積もりを見るときは、データ整備の工数が現実的に積まれているかを確認してください。
ここが薄い見積もりは、後から追加費用が出るか、精度が出ないまま終わるかのどちらかになりがちです。
作って終わりにならない
機械学習のモデルは、時間とともに当たらなくなります。
顧客の行動が変わり、商品が入れ替わり、不正の手口が変わるからです。
この現象を性能の劣化と呼び、対策は定期的な再学習です。
導入の企画では、次の3点を運用側に渡す形にしておくと止まりません。
- 何を監視すれば劣化に気付けるか(週次の精度、判定件数の急変など)
- どのくらいの周期で再学習するか
- 再学習を誰が実行するか
ここが決まっていないモデルは、半年から1年で誰も見なくなります。
説明できないと通らない場面がある
融資の可否、採用の合否、保険の引受のように、結果の理由を相手に説明する義務がある業務では、精度だけでは採用できません。
理由を示せるモデルを選ぶ、あるいは判定の根拠を後から示す仕組みを併用する必要があります。
日本では、総務省と経済産業省のAI事業者ガイドライン(令和7年3月の第1.1版)が、透明性や説明可能性を含む論点を整理しています。
社内規程を作る際の骨子として使えます。
つまずきポイント
「PoCでは精度が出たのに、本番で落ちた」
よくある原因は3つです。
一つは、評価に使ったデータが本番の分布と違っていたこと。
二つ目は、学習時には知り得ないはずの情報が特徴量に混ざっていたこと(結果を含む項目を使ってしまう、いわゆるデータリーケージです)。
三つ目は、PoCの期間が短く、季節変動を含んでいなかったことです。
心当たりがない場合は、Level 3の評価の項に戻り、評価用データの取り方から見直してください。
理解度チェック
Q1.【オリジナル】不正な取引を見つけるモデルで、「適合率」にあたるものはどれか。
- ア 正常な取引のうち、正常と判定できた割合
- イ 全件のうち、判定が当たった割合
- ウ 実際の不正のうち、見つけられた割合
- エ 不正だと判定したもののうち、実際に不正だった割合
正解:エ
解説:
適合率は「判定した中の当たりの割合」です。
低いと、現場が空振りの確認作業に追われます。
ウは再現率です。低いと、見逃しが発生します。
イは正解率です。答えが片方に偏っていると、役に立たない数字になります。
アは正常な取引の側の当たりの割合で、適合率でも再現率でもありません。
→ 「精度という一語で会話をしない」に戻る
Q2.【IPA過去問】品質管理担当者が行っている検査を自動化することを考えた。10,000枚の製品画像と,それに対する品質管理担当者による不良品かどうかの判定結果を学習データとして与えることによって,製品が不良品かどうかを判定する機械学習モデルを構築した。100枚の製品画像に対してテストを行った結果は表のとおりである。品質管理担当者が不良品と判定した製品画像数に占める,機械学習モデルの判定が不良品と判定した製品画像数の割合を再現率としたとき,このテストにおける再現率は幾らか。
単位 枚
| 品質管理担当者の判定\機械学習モデルの判定 | 不良品 | 良品 |
|---|---|---|
| 不良品 | 5 | 5 |
| 良品 | 15 | 75 |
- ア 0.05
- イ 0.25
- ウ 0.50
- エ 0.80
出典:令和5年度 ITパスポート試験 公開問題 問76(表の見出しを一部改変)
正解:ウ
解説:
再現率は、実際の不良品のうち、モデルが見つけられた割合です。
担当者が不良品とした画像は5+5=10枚で、そのうちモデルも不良品としたのは5枚なので、5÷10=0.50です。
ほかの選択肢は、別の指標を計算したときの値になっています。
アの0.05は、100枚全体に占める「両方が不良品とした5枚」の割合です。
イの0.25は、モデルが不良品とした5+15=20枚のうち、本当に不良品だった5枚の割合で、適合率にあたります。
エの0.80は、判定が一致した5+75=80枚の割合で、正解率にあたります。
この問題では、正解率は0.80と高く見えますが、不良品の半分を見逃しています。
→ 「精度という一語で会話をしない」に戻る
Q3.【オリジナル】工場の検査で、不良品を1つでも出荷すると大きな損害になる。確認作業の人手には余裕がある。このとき優先すべき指標はどれか。
- ア 再現率
- イ 正解率
- ウ 学習データで測った正解率
- エ 適合率
正解:ア
解説:
見逃しの損害が大きい業務では、再現率を優先します。
空振りが増えて確認の手間がかかっても、人手に余裕があれば受け止められます。
エの適合率は、確認作業の人手が限られている業務で優先します。
イの正解率は、不良品が少ないと、見逃していても高く出ます。
ウは、学習に使ったデータで測った数字なので、そもそも実力の評価になりません。
→ 「精度という一語で会話をしない」に戻る
Q4.【オリジナル】過去の判断結果が、紙と担当者の頭の中にしか残っていない。機械学習を使いたいとき、最初にやることとして最も適切なものはどれか。
- ア 手元にある少しのデータで、まず本番に入れてみる
- イ 判断結果を、揃った項目で電子的に記録し続ける運用を作る
- ウ ディープラーニングならデータが少なくても補えるので、手法を先に決める
- エ すぐに外部に発注して、モデルを作ってもらう
正解:イ
解説:
教師あり学習には、正解つきのデータが要ります。
データがないなら、先に記録の運用を作り、半年から1年ぶんが貯まってから学習に進むのが現実的です。
エは、データがないまま発注しても、モデルを作る材料がありません。
アは、少ないデータで作ったモデルを本番に入れることになり、精度が出ないまま終わりがちです。
ウは誤りです。ディープラーニングは、むしろ大量のデータを必要とします。
→ 「データがないなら、そこから始める」に戻る
Q5.【オリジナル】導入したモデルが、半年ほどで当たらなくなってきた。対策の考え方として、最も適切なものはどれか。
- ア 学習に使ったデータで測り直し、精度が高ければそのまま使う
- イ 一度作ったモデルの性能は変わらないので、入力データのミスを探す
- ウ 対象の変化に合わせた再学習を前提に、監視する項目、周期、担当を決めておく
- エ 当たらなくなったらモデルを捨てて、機械学習の利用をやめる
正解:ウ
解説:
顧客の行動や商品、不正の手口が変わるため、モデルは時間とともに当たらなくなります。
対策は定期的な再学習で、何を監視するか、どの周期で学習し直すか、誰が実行するかを、導入の段階で決めておきます。
イは誤りです。モデルが変わらなくても、対象のほうが変わります。
エは、再学習で取り戻せる性能を手放すことになります。
アは、学習に使ったデータでは、性能の劣化を見つけられません。
→ 「作って終わりにならない」に戻る
ここまで読めば言えるようになること
- [ ] 精度を適合率と再現率に分けて説明できる
- [ ] 自社の業務でどちらを優先すべきか言える
- [ ] 見積もりのうちデータ整備の比重を確認できる
- [ ] 再学習の監視項目と周期と担当を決められる
実装や資格に進むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:汎化性能をめぐる理論的な枠組みを持ち、実装上の落とし穴を体系的に点検できる
目的は訓練誤差ではなく汎化誤差
機械学習の目的は、手元のデータへの当てはまりではなく、未知のデータに対する誤差、すなわち汎化誤差を小さくすることです。
訓練誤差はいくらでも下げられるため、それ自体は目的になりません。
汎化誤差は、バイアスとバリアンスに分解して考えられます。
バイアスは、モデルの表現力が足りずに真の関係を捉えきれないことによる誤差です。
バリアンスは、訓練データのばらつきに過敏に反応することによる誤差です。
モデルを複雑にするとバイアスは下がりバリアンスは上がるため、この間で釣り合いを取ることになります。
過学習はバリアンスが支配的な状態、未学習はバイアスが支配的な状態です。
バリアンスを抑える手段が正則化です。
パラメータの大きさに罰則を加えるL1正則化やL2正則化、ニューラルネットワークで一部の素子を確率的に無効化するドロップアウト、学習を途中で打ち切る早期終了などが使われます。
評価設計は、実装より先に決める
汎化誤差を推定する標準的な手続きが交差検証です。
データをk個に分割し、そのうち1つを検証用、残りを学習用として、分割を入れ替えながらk回評価します。
データ量が限られる場面で、単一の分割による偶然の影響を減らせます。
ただし、分割の仕方はデータの性質に従わせる必要があります。
時系列データを無作為に分割すると、未来のデータで学習して過去を予測する形になり、評価が実力を上回ります。
時系列では、時間で切る前進検証を使います。
同一の顧客や患者から複数のレコードが出ている場合は、レコード単位ではなく個体単位で分割しないと、同じ個体が学習側と検証側にまたがります。
データリーケージは、この種の問題の総称です。
結果が確定した後にしか得られない項目を特徴量に含める、前処理の統計量を全データから計算してから分割する、といった形で混入します。
検証スコアが不自然に高いときは、モデルを疑う前にリーケージを疑うのが定石です。
クラス不均衡への対処
正例が極端に少ないデータでは、正解率は指標として機能しません。
適合率と再現率の調和平均であるF値、あるいは閾値によらない評価としてPR曲線下面積を使います。
不均衡が強い場合、ROC曲線下面積は楽観的に見えるため、PR曲線のほうが実態を反映します。
対処としては、少数クラスの重みを損失関数で大きくする方法、少数クラスをオーバーサンプリングする方法、多数クラスをアンダーサンプリングする方法があります。
いずれもモデルの出力する確率の較正を崩すため、確率値そのものを業務で使う場合は較正の手当てが要ります。
表形式データでは、勾配ブースティングが依然として強い
深層学習が有効なのは、画像、音声、テキストのように、生の信号から階層的な表現を学ぶ利点が大きい領域です。
表形式のデータでは、勾配ブースティング決定木がしばしば同等以上の性能を、はるかに少ない計算量で達成します。
実務では、まず勾配ブースティングで基準線を作り、それを上回れるかどうかで深層学習の採否を判断する進め方が堅実です。
公平性と因果
学習データに含まれる偏りは、そのまま出力に表れます。
過去の採用実績で学習すれば、過去の偏りを再生産します。
公平性の指標は複数あり、それらは同時には満たせないことが知られています。
どの指標を採るかは技術的に決まらず、業務と法規の側から決める判断になります。
もう一つ、機械学習が捉えるのは相関であって因果ではありません。
「この施策を打った顧客は継続率が高い」という予測モデルは、施策の効果を意味しません。
介入の効果を推定したい場合は、A/Bテストや因果推論の枠組みを併用することになります。
予測モデルの出力をそのまま施策の根拠に使うのは、この点で誤りです。
進み方
体系的に学ぶなら、日本ではG検定が事業活用の範囲、E資格が実装を含む範囲を扱います。
実装は、表形式ならscikit-learnと勾配ブースティングの実装、深層学習ならPyTorchが標準的な入口です。
生成AIの側に進む場合は、LLMの記事が続きになります。
理解度チェック
Q1.【オリジナル】汎化誤差をバイアスとバリアンスに分けて考えたとき、過学習の状態を説明したものとして、最も適切なものはどれか。
- ア バリアンスが支配的で、訓練データのばらつきに過敏に反応している
- イ 訓練誤差が大きく、汎化誤差が小さくなっている
- ウ バイアスが支配的で、モデルの表現力が足りずに真の関係を捉えきれていない
- エ バイアスとバリアンスが、どちらも0になっている
正解:ア
解説:
過学習は、訓練データのばらつきまで拾ってしまう、バリアンスが支配的な状態です。
ウは未学習(バイアスが支配的な状態)の説明です。
エは、現実のデータでは起こりません。
イは、過学習とは逆の傾向です。過学習では、訓練誤差は小さく、汎化誤差が大きくなります。
バリアンスを抑える手段が、L1正則化、L2正則化、ドロップアウト、早期終了などの正則化です。
→ 「目的は訓練誤差ではなく汎化誤差」に戻る
Q2.【オリジナル】数年分の日ごとの売上データで、需要を予測するモデルを作る。評価のためのデータの分け方として、最も適切なものはどれか。
- ア 曜日ごとに分け、月曜のデータで学習して、火曜のデータで検証する
- イ 全期間のデータを無作為にk個に分けて、交差検証する
- ウ 全データで学習し、同じデータで評価する
- エ 時間で区切り、過去の期間で学習して、その後の期間で検証する
正解:エ
解説:
時系列データは、時間で切って、過去から未来を予測する形で検証します(前進検証)。
イは、未来のデータで学習して過去を予測する形が混ざるため、評価が実力を上回ります。
ウは、汎化誤差を推定できません。
アは、同じ週の情報が学習と検証にまたがるうえ、本番の使い方(過去から未来を予測する)とも合いません。
→ 「評価設計は、実装より先に決める」に戻る
Q3.【オリジナル】データリーケージにあたるものはどれか。
- ア 少数クラスの重みを、損失関数で大きくした
- イ 標準化に使う平均と標準偏差を全データから計算し、そのあとで学習用と検証用に分けた
- ウ 同じ顧客のレコードが学習側と検証側にまたがらないよう、顧客単位で分割した
- エ 検証用のデータは、最後に一度だけ使った
正解:イ
解説:
前処理の統計量を全データから計算すると、検証用データの情報が学習側に漏れます。
分割を先に行い、統計量は学習用データだけから計算します。
ウは、リーケージを防ぐための正しい分け方です。
アは、クラス不均衡への対処で、リーケージではありません(ただし確率の較正が崩れる点には注意が要ります)。
エは、評価用データの正しい使い方です。
→ 「評価設計は、実装より先に決める」に戻る
Q4.【IPA過去問】AIにおける機械学習において,2クラス分類モデルの評価方法の一つであるROC曲線で用いられる偽陽性率の説明として,最も適切なものはどれか。ここで,分類されるデータには正しいものと間違っているものが含まれるものとする。
- ア “間違い”と予測したデータのうち,実際は“正しい”データの割合
- イ 実際に“間違い”であるデータに対し,誤って“正しい”と予測したデータの割合
- ウ 実際に“間違い”であるデータに対し,正しく“間違い”と予測したデータの割合
- エ 全データのうち,実際に正しく予測できなかったデータの割合
出典:令和7年度 秋期 応用情報技術者試験 午前 問3
正解:イ
解説:
この問題では「正しい」が陽性、「間違い」が陰性にあたります。
偽陽性率は、実際は陰性のデータのうち、誤って陽性と予測した割合です。
ROC曲線は、横軸に偽陽性率、縦軸に真陽性率(再現率)をとって描きます。
アは、陰性と予測した中の外れの割合で、偽陽性率ではありません。
ウは、陰性を正しく陰性と予測した割合(特異度)で、1から偽陽性率を引いた値になります。
エは、全体の誤り率(1から正解率を引いた値)です。
陰性が圧倒的に多い不均衡データでは、偽陽性率の分母が大きくなるため、空振りが多くても偽陽性率は小さく出ます。
ROC曲線下面積が楽観的に見え、PR曲線のほうが実態を反映しやすいのは、このためです。
→ 「クラス不均衡への対処」に戻る
Q5.【オリジナル】予測モデルの分析で「クーポンを配った顧客は、継続率が高い」という結果が出た。この結果の扱いとして、最も適切なものはどれか。
- ア モデルの精度が高ければ、相関は因果とみなしてよい
- イ 相関を示しているだけなので、効果を知りたければA/Bテストなどで介入の効果を確かめる
- ウ 継続率の高い顧客を選んで配っていた可能性はないので、そのまま施策の根拠にできる
- エ クーポンが継続率を上げた証拠として、全顧客への配布を決める
正解:イ
解説:
機械学習が捉えるのは相関で、因果ではありません。
もともと継続しそうな顧客にクーポンが配られていただけ、という可能性を消せないからです。
ウとエは、相関を因果と取り違えています。
アは誤りです。予測の精度が高いことと、介入の効果があることは別の問題です。
→ 「公平性と因果」に戻る
ここまで読めば言えるようになること
- [ ] 汎化誤差をバイアスとバリアンスに分解して説明できる
- [ ] データの性質に応じた分割方法を選べる
- [ ] データリーケージの典型的な混入経路を挙げられる
- [ ] 相関と因果の区別を、施策判断の文脈で説明できる
まとめ
機械学習は、ルールを人間が書く代わりに、データから規則性をコンピュータに見つけさせる手法です。
Level 1では、例をたくさん見せて覚えさせるやり方。
Level 2では、ルールと答えの順序を逆にした発想の転換。
Level 3では、データ準備から再学習までの5工程を持つ営み。
Level 4では、適合率と再現率を業務に翻訳して判断する対象。
Level 5では、汎化誤差をめぐる理論と、リーケージや公平性といった実装上の論点を抱えた分野。
どのレベルまで必要かは立場によりますが、Level 3の過学習とLevel 4の適合率と再現率は、AIの話に関わる全員にとって効きます。
この2つを知っているだけで、精度の数字に振り回されなくなります。
次に読む記事
同じ5段階シリーズの他の2本です。
→ AIとは何か|子供向けから専門的な話まで5段階でわかる用語解説
→ LLM(大規模言語モデル)とは
深層学習に進むならこちらです。
→ ディープラーニング(深層学習)とは|5段階でわかる用語解説
用語をまとめて確認したい場合は、こちらが索引になります。
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
よくある質問(FAQ)
Q. 機械学習とは何ですか?
A. ルールを人間が書くのではなく、データから規則性をコンピュータに見つけさせる手法です。入力と答えの組を大量に与えて、その間にあるルールを学ばせます。
Q. 機械学習とAIの違いは何ですか?
A. AIは人間の知的な作業をコンピュータに行わせる技術の総称で、機械学習はその中の主要な手法の一つです。さらに機械学習の中の一手法がディープラーニングにあたります。
Q. 教師あり学習と教師なし学習の違いは何ですか?
A. 正解を与えるかどうかです。教師あり学習は問題と正解をセットで学ばせ、教師なし学習は正解を与えずデータの構造を見つけさせます。実用例の大半は教師あり学習です。
Q. 過学習とは何ですか?
A. 学習に使ったデータには当たるのに、初めて見るデータには当たらなくなる状態です。学習に使っていないデータで評価しないと発見できません。
Q. 機械学習の導入に、どのくらいのデータが必要ですか?
A. 課題によって大きく変わるため、一律の目安はありません。ただし正解つきのデータが揃っていない場合、モデルを作る前に記録の運用を整える段階から始めることになります。
Q. 精度が高ければ導入してよいのですか?
A. 正解が片方に偏っているデータでは、正解率が高くても役に立ちません。適合率と再現率に分けて確認し、業務としてどちらを優先するかを先に決める必要があります。
Q. 機械学習の3つの種類(手法)は何ですか?
A. 教師あり学習、教師なし学習、強化学習の3つです。教師あり学習は、問題と正解をセットで渡して学ばせます(迷惑メールの判定など)。教師なし学習は、正解を渡さずに、似たもの同士をまとめさせます。強化学習は、うまくいくと点がもらえる仕組みを手がかりに、上達させます。 3つは難しさの順ではありません。どれを使うかは、手元にどんなデータがあるかで決まります。
参考
- 総務省「令和7年版 情報通信白書」企業におけるAI利用の現状
https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r07/html/nd112220.html - 総務省・経済産業省「AI事業者ガイドライン」(第1.2版 令和8年3月31日)
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報