「AIが学習する」という言い方は、あまりに広く使われているせいで、かえって中身が伝わりません。
学習データの著作権、社内データでの追加学習、学習に使わせない設定。
どれも学習という一語の中身が分かっていないと、判断ができない話です。
この記事では、学習の説明を5つのレベルに分けて並べました。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(8分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(9分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(9分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で通り過ぎます。
30秒で腕試し
理解度から決めたい場合は、次の3問を試してください。
答えられなくなったところが、あなたのスタート地点です。
Q1. AIに話しかけると、その場で賢くなると思いますか
→ 詰まったら Level 1から
Q2. 事前学習と事後学習で、それぞれ何が決まるか説明できますか
→ 詰まったら Level 3から
Q3. 自社データでの学習が本当に必要かどうか、判断できますか
→ 詰まったら Level 4から
→ 3問とも答えられるなら Level 5から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:学習を「まちがえながら少しずつ直していく作業」だと言える
まちがえて、直して、また試す
AIの学習は、練習によく似ています。
たとえば、バスケットボールのシュートを練習するとします。
投げてみて、外れる。
少し力を強くしてみる。
また外れる。
今度は角度を変えてみる。
これを何百回も繰り返すうちに、入るようになります。
AIも同じです。
答えを出してみて、正解とどれくらいずれていたかを調べる。
そのずれが小さくなる方向に、中身の数値を少しだけ動かす。
これを何百万回も繰り返します。
この繰り返しが学習です。
学習には、材料と時間がかかる
学習には、2つのものが要ります。
一つは、材料です。
たくさんの例がないと、練習になりません。
この材料を学習データと呼びます。
もう一つは、時間と電気です。
大きなAIの学習には、たくさんの計算機を何週間も動かし続けます。
だから、AIを作るのはとてもお金のかかる作業です。
学習が終わったら、それ以上は覚えない
ここが意外なところです。
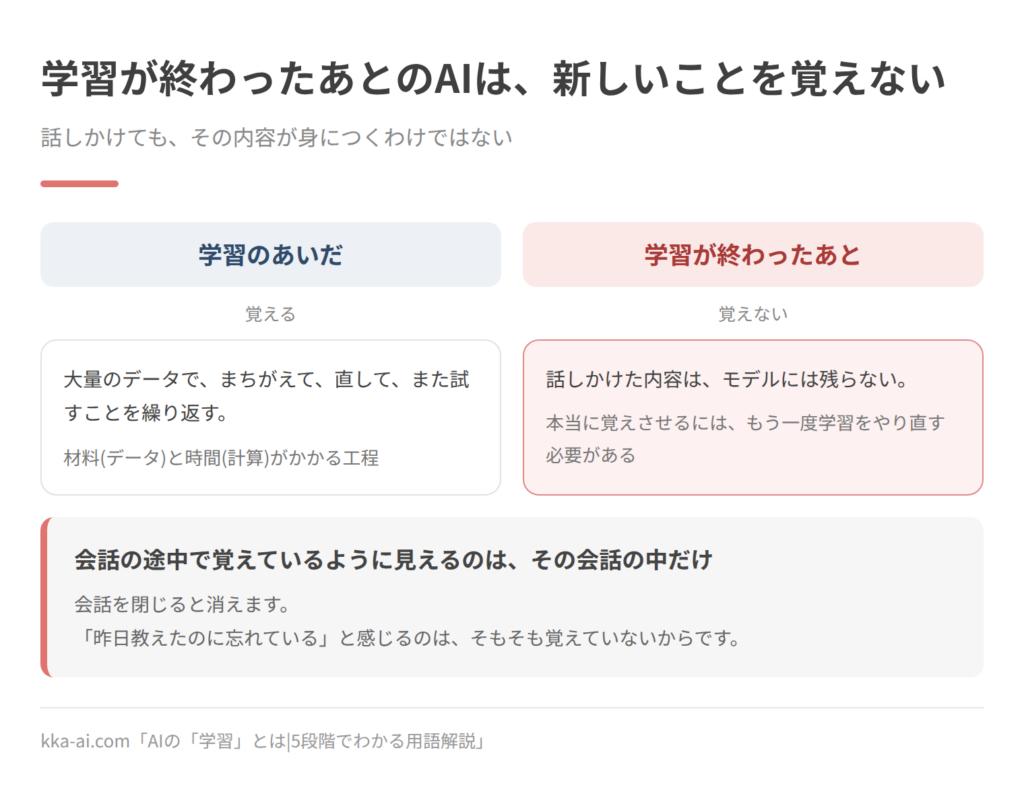
AIは、学習が終わったあとは、新しいことを覚えません。
話しかけても、その内容が身につくわけではないのです。
会話の途中で覚えているように見えるのは、その会話の中だけの話で、会話を閉じると消えます。
本当に覚えさせるには、もう一度学習をやり直す必要があります。
つまずきポイント
「AIに教えたら、賢くなる?」
なりません。
話しかけた内容は、その会話の中でだけ使われます。
サービスによっては、会話の内容を次の学習の材料に使うことがありますが、それはずっと後の話で、その場で賢くなるわけではありません。
理解度チェック
Q1. AIの学習は、何を繰り返していますか?
答えを出して、正解とのずれを調べ、そのずれが小さくなる方向に中身の数値を少し動かすことを繰り返しています。
Q2. 学習に必要なものを2つ挙げてください。
たくさんの例(学習データ)と、時間や電気などの計算資源です。
Q3. AIに話しかけると、その場で賢くなりますか?
なりません。
学習が終わったあとは、新しいことを覚えません。会話の中だけで使われ、閉じると消えます。
ここまで読めば言えるようになること
- [ ] 学習をずれを直す繰り返しとして説明できる
- [ ] 学習データと計算資源が必要だと説明できる
- [ ] 会話が学習ではないと説明できる
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(まちがえて直す繰り返し、学習データ)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:学習と推論を区別でき、学習データが議論になる理由を説明できる
学習と推論は、別の工程
AIには、大きく2つの工程があります。
学習は、データを読ませてモデルを作る工程です。
時間も費用もかかり、大規模なモデルでは数週間から数か月に及ぶこともあります。
推論は、できあがったモデルを使って実際に答えを出す工程です。
私たちがAIを使うとき動いているのは、こちらです。
→ 推論とは
料理にたとえると、学習が料理を覚える修行、推論が実際に一皿を作ることにあたります。
修行は一度で済みますが、料理は注文のたびに必要です。
学習データが議論になるのはなぜか
AIの学習には、膨大な量の文章や画像が使われます。
その多くが、インターネット上にあるものです。
ここで問題になるのが、それらに著作権があるという点です。
学習に使うことが許されるのか、権利者に断りが要るのか、対価は必要か。
これらが、世界中で議論と訴訟の対象になっています。
日本の著作権法には、情報解析のために著作物を利用できる規定がありますが、無条件ではありません。
どこまでが許されるかについては、文化庁が考え方を整理した資料を公表しています。
学習データの質が、そのまま出てくる
学習データの偏りは、そのままAIの出力に表れます。
たとえば、過去の採用実績を学習させれば、過去の採用の偏りをそのまま再現します。
特定の地域の文章ばかりで学習させれば、その地域の見方が標準として出てきます。
「AIは中立だから公平」ではありません。
学習データが何であったかが、そのまま性質になります。
自分のデータを学習に使わせない設定
多くのサービスには、入力した内容を学習に使わせない設定があります。
これをオプトアウトと呼びます。
→ オプトアウトとは
既定の状態はサービスとプランによって異なります。
仕事の情報や他人の個人情報を入れる可能性があるなら、設定を確認してから使ってください。
つまずきポイント
「学習に使われないなら、何を入れても安全?」
学習に使われないことと、サーバーに保存されないことは別です。
多くのサービスは、不正利用の監視などのために一定期間ログを保存しています。
保存期間と扱いは、規約に書かれています。
理解度チェック
Q1. 学習と推論の違いを説明してください。
学習はデータを読ませてモデルを作る工程、推論はできあがったモデルで答えを出す工程です。
Q2. 学習データが議論の対象になっているのはなぜですか?
学習に使われる文章や画像の多くに著作権があり、それらを学習に使ってよいかが争点になっているためです。
Q3. 「AIは中立だから公平」と言えますか?
言えません。
学習データの偏りは、そのまま出力に表れます。
ここまで読めば言えるようになること
- [ ] 学習と推論を工程として区別できる
- [ ] 学習データの著作権が論点になる理由を説明できる
- [ ] オプトアウトの設定を確認できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(学習と推論の違い、学習データをめぐる論点)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:学習の段階を分けて説明でき、それぞれで何が決まるかを言える
学習は段階に分かれる
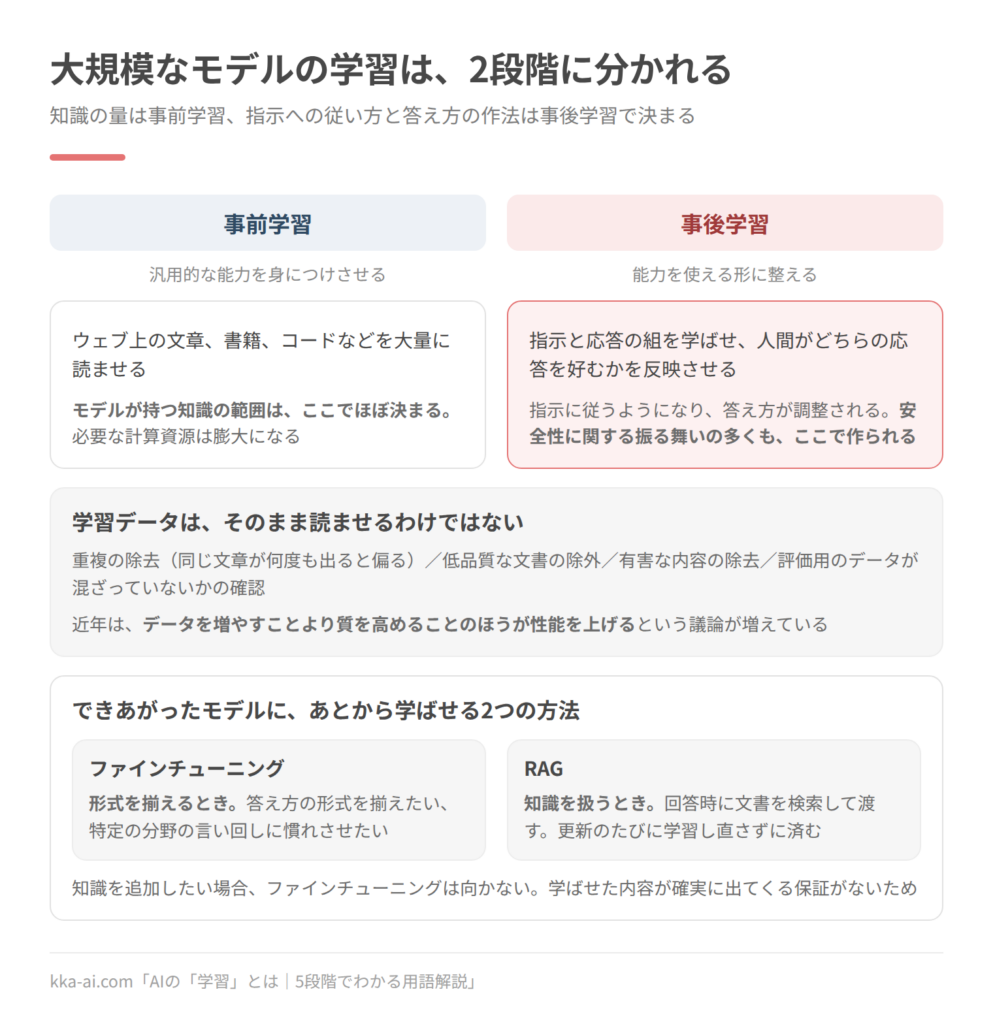
現在の大規模なモデルの学習は、大きく2段階に分かれます。
事前学習は、大量のテキストや画像を読ませ、汎用的な能力を身につけさせる段階です。
ウェブ上の文章、書籍、コードなどが使われ、必要な計算資源は膨大になります。
モデルが持つ知識の範囲は、ここでほぼ決まります。
事後学習は、その能力を使える形に整える段階です。
指示と応答の組を学ばせて指示に従うようにし、人間がどちらの応答を好むかを反映させて答え方を調整します。
安全性に関する振る舞いの多くも、ここで作られます。
賢さと使いやすさは、この2段階に対応しています。
知識の量は事前学習、指示への従い方と答え方の作法は事後学習で決まります。
学習データの作り方が性能を左右する
大量のデータをそのまま読ませればよい、というものではありません。
実際には、次のような処理が入ります。
- 重複の除去(同じ文章が何度も出ると、その内容に偏る)
- 低品質な文書の除外(自動生成された無意味なページなど)
- 有害な内容の除去
- 評価用のデータが混ざっていないかの確認
近年は、データを増やすことより、質を高めることのほうが効果的であるという議論が増えています。
追加で学習させる方法
できあがったモデルに、あとから何かを学ばせる方法もあります。
ファインチューニングは、追加のデータで学習を続ける方法です。
答え方の形式を揃えたい、特定の分野の言い回しに慣れさせたい、といった目的に向きます。
→ ファインチューニングとは
一方、知識を追加したい場合、ファインチューニングは向きません。
更新のたびに学習し直す必要があり、しかも学ばせた内容が確実に出てくる保証がないためです。
知識を扱いたい場合は、RAG、つまり回答時に文書を検索して渡す方法が適しています。
→ RAGとは
「形式を揃えるならファインチューニング、知識を扱うならRAG」が基本の使い分けです。
学習には終わりがある
学習には、いつ止めるかという問題があります。
学習を続けるほど学習データへの当てはまりは良くなりますが、ある時点から未知のデータへの性能が落ち始めます。
これが過学習です。
そのため、学習中は学習に使っていないデータで定期的に性能を測り、悪化し始めた時点で止めます。
→ 機械学習とは何か
つまずきポイント
「学習と、会話中に覚えることは何が違う?」
会話の中で前の発言を踏まえられるのは、それまでのやり取りを毎回まとめて入力に含めているからです。
モデルの中身は変わっていません。
この入力に含められる範囲がコンテキストで、そこから外れた部分は忘れたように見えます。
→ コンテキストとは
理解度チェック
Q1. 事前学習と事後学習で、それぞれ何が決まりますか?
事前学習で知識の範囲が、事後学習で指示への従い方や答え方の作法が決まります。
Q2. 知識を追加したい場合、ファインチューニングとRAGのどちらが適していますか?
RAGです。
ファインチューニングは更新のたびに学習し直す必要があり、学ばせた内容が確実に出る保証もありません。
Q3. 学習をいつ止めるかは、どう判断しますか?
学習に使っていないデータで定期的に性能を測り、悪化し始めた時点で止めます。
Q4. 会話中に前の発言を踏まえられるのはなぜですか?
それまでのやり取りを毎回まとめて入力に含めているからで、モデルの中身は変わっていません。
ここまで読めば言えるようになること
- [ ] 事前学習と事後学習を分けて説明できる
- [ ] 学習データの質が性能を左右すると説明できる
- [ ] ファインチューニングとRAGを使い分けられる
- [ ] 会話の記憶と学習の違いを説明できる
仕事で判断する立場なら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(事前学習と事後学習、ファインチューニングとRAGの使い分け)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:自社データを学習に使うかどうかを、費用と権利の両面から判断できる
まず、学習が要るのかを疑う
「自社のデータでAIを学習させたい」という要望は頻繁に出ますが、多くの場合、学習は要りません。
要らないことが多い理由は2つです。
一つは、知識を扱う目的ならRAGのほうが適していること。
もう一つは、答え方を揃える程度なら、プロンプトの指定で足りることが多いことです。
学習が本当に必要になるのは、次のような場合です。
- 出力の形式や語彙が、プロンプトでは安定しない水準まで厳密に決まっている
- 業界特有の言い回しが多く、汎用モデルの解釈が安定しない
- 処理件数が膨大で、長いプロンプトを毎回送る費用が無視できない
3つ目は見落とされがちですが、実務では効果的です。
毎回2000トークンの指示を送るより、その内容を学習させて短い指示で済ませるほうが、件数によっては安くなります。
学習に使うデータの権利を確認する
自社データで学習させる場合、次を確認してください。
顧客から預かったデータは、契約と利用目的の範囲内かを確認します。
「サービス提供のため」という目的で預かったデータをAIの学習に使うことが、その範囲に入るかは自明ではありません。
個人情報を含むデータは、利用目的の変更にあたらないか、匿名化や仮名化で足りるかを確認します。
他社の著作物を含むデータは、社内文書に外部資料が引用されている場合などに問題になります。
従業員に関するデータは、労務の観点も加わります。
いずれも、法務の確認を経てから着手する順序になります。
費用の構造
学習の費用は、計算資源だけではありません。
- データの整備:収集、クレンジング、形式の統一。最も工数がかかる
- ラベル付け:期待する出力を人が作る作業。品質がそのまま結果に出る
- 計算資源:パラメータ効率的な手法を使えば大幅に下がる
- 評価:学習前後の比較。評価セットの整備を含む
- 再学習:データが増えたとき、モデルが更新されたときに繰り返す
見積もりを見るとき、データ整備とラベル付けの工数が現実的に積まれているかを確認してください。
学習させたモデルの維持
学習させたモデルには、維持の負担があります。
土台にした基盤モデルが更新されると、その恩恵を受けるには学習をやり直すことになります。
つまり、学習させた時点の性能で固定される代わりに、以後の性能向上から取り残される可能性があります。
この点でも、RAGのほうが維持は容易です。
基盤モデルを差し替えても、検索対象の文書はそのまま使えます。
入力を学習に使われない設定を、組織で適用する
社内で生成AIを使う場合、入力が学習に使われるかはプランによって異なります。
法人向けプランでは、入力を学習に使わないことが規約上明示されていることが多く、管理者が組織全体に設定を適用できます。
個人アカウントでの利用が広がると統制されきません。
正規の手段を提供したうえで、個人アカウントでの業務利用を禁じる、という順序が実務的です。
つまずきポイント
「学習させたのに、期待した出力にならない」
原因の多くは、学習データの一貫性です。
同じような入力に対して、担当者ごとに違う形式の出力が学習データに含まれていると、モデルはその揺れごと学習します。
学習データを作る前に、期待する出力の基準を文書にし、複数人で作る場合は一致率を測ってください。
理解度チェック
Q1. 自社データでの学習が本当に必要になるのはどんな場合ですか?
出力の形式がプロンプトでは安定しない水準まで厳密な場合、業界特有の言い回しが多い場合、件数が膨大で長いプロンプトの費用が無視できない場合です。
Q2. 顧客から預かったデータを学習に使う際、確認すべきことは?
契約と、預かった際の利用目的の範囲内かどうかです。
サービス提供目的のデータを学習に使うことが範囲に入るかは自明ではありません。
Q3. 学習させたモデルの維持で問題になる点は何ですか?
土台の基盤モデルが更新されても、その恩恵を受けるには学習をやり直す必要がある点です。
Q4. 学習させても期待した出力にならない、最も多い原因は?
学習データの一貫性のなさです。
担当者ごとに違う形式の出力が混ざっていると、その揺れごと学習します。
ここまで読めば言えるようになること
- [ ] 学習が不要な場合を先に判定できる
- [ ] 学習データの権利確認の観点を4つ挙げられる
- [ ] 費用の内訳を、データ整備を含めて説明できる
- [ ] 学習済みモデルの維持負担を説明できる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:事前学習と事後学習の各手法を、目的と制約から選べる
事前学習の設計
事前学習は、自己教師あり学習として構成されます。
言語では、次のトークンを予測する課題が主流です。
ラベルが不要なため、大量のテキストがそのまま学習データになります。
計算資源の配分は、パラメータ数と学習トークン数の間で決める問題になります。
同じ計算予算に対して損失を最小化する配分の関係が経験的に示されており、モデルを大きくしすぎてデータが不足する構成は非効率だと分かっています。
一方、推論時の費用を重視する場合は、より小さいモデルをより多くのトークンで学習させる構成が選ばれます。
学習は一度、推論は無数に走るためです。
データの前処理では、重複除去がとくに有効です。
近似的な重複を含めて除去することで、同じ内容への過剰な適合を避けられます。
評価用データの混入(汚染)の検査も、この段階で行います。
事後学習の系統
事前学習済みモデルは指示に従いません。
これを整えるのが事後学習です。
教師ありファインチューニングは、指示と応答の組で学習させます。
データの質が支配的で一貫性と多様性があります。
選好に基づく最適化は、応答の優劣に関する判断を反映させます。
報酬モデルを学習して強化学習で最適化する方式と、選好データから直接方策を最適化する方式があります。
後者は実装が簡素で、報酬モデルの誤差に起因する不安定さを避けられます。
選好最適化では、元のモデルから離れすぎないよう制約を置きます。
制約が弱いと、報酬を稼ぐ形に特化して汎用性能や多様性が落ちます。
パラメータ効率的な手法
全パラメータの更新は、計算資源と保存の両面で重くなります。
低ランク適応は、元の重みを固定し、低ランクの差分行列だけを学習します。
学習対象は元の1%未満で済み、成果物も小さく、用途ごとに切り替えられます。
量子化した基盤モデルの上で低ランク適応を行う構成により、限られたGPUメモリでも学習が可能になります。
適応する層の選択とランクの設定が結果を左右します。
注意機構の投影行列に適用するのが一般的で、ランクを上げても単調に良くなるとは限りません。
破滅的忘却と汎化の劣化
追加学習は、元の能力を損なう危険を伴います。
特定の形式に強く適合させると、それ以外の指示への応答が劣化します。
対策としては、学習率を下げる、元のモデルの出力分布から離れすぎないよう正則化する、汎用の指示データを一定割合混ぜる、といった手当てが取られます。
評価は、対象タスクだけでなく汎用の能力についても学習前後で測る必要があります。
合成データの利用と注意
学習データを大規模なモデルに生成させる手法が広く使われています。
費用と速度の面で有利ですが、生成元モデルの偏りと誤りをそのまま引き継ぎます。
また、生成物を繰り返し学習に用いると、分布の裾が失われて多様性が低下する現象が指摘されています。
実データとの混合比率と、生成データの検証工程が要点になります。
記録
学習を業務として繰り返す場合、次を版管理の対象にします。
- 学習データの版とその生成手順
- ハイパーパラメータ
- 基盤モデルの識別子と版
- 評価セットと評価結果
学習は再現できる形にしておかないと、性能が落ちたときに原因を切り分けられません。
理解度チェック
Q1. 推論費用を重視する場合、計算予算の配分はどう変わりますか?
より小さいモデルを、より多くのトークンで学習させる構成が選ばれます。
学習は一度ですが、推論は無数に走るためです。
Q2. 選好最適化で、元のモデルから離れすぎないよう制約を置く理由は?
制約が弱いと、報酬を稼ぐ形に特化して汎用性能や多様性が落ちるためです。
Q3. 追加学習の評価で、対象タスク以外に測るべきものは?
汎用の能力です。
特定の形式に適合させると、それ以外の指示への応答が劣化する危険があります。
Q4. 合成データを繰り返し学習に用いる際の危険は?
生成元の偏りと誤りを引き継ぐことと、分布の裾が失われて多様性が低下することです。
ここまで読めば言えるようになること
- [ ] 計算予算の配分を目的から決められる
- [ ] 事後学習の各手法を目的で選べる
- [ ] 低ランク適応の設定の勘所を説明できる
- [ ] 破滅的忘却と合成データの危険を説明できる
まとめ
学習は、AIがずれを小さくする方向にパラメータを調整していく工程です。
Level 1では、まちがえて直す繰り返し。
Level 2では、推論と対になる、費用のかかる一度きりの工程。
Level 3では、事前学習と事後学習に分かれ、それぞれで別のものが決まる段階。
Level 4では、権利と費用を確認したうえで、本当に必要かを判断する対象。
Level 5では、計算予算の配分と忘却の管理を伴う設計。
実務でいちばん効果的なのは、Level 4の「まず学習が要るのかを疑う」という一点です。
多くの要望は、RAGかプロンプトの調整で足ります。
次に読む記事
→ 推論とは
→ ファインチューニングとは
→ RAGとは
→ データセンターとは|AIで電力消費が倍増する仕組みと、2026年4月からの日本の新ルール【2026年版】
→ 今さら聞けないAI用語30選
よくある質問(FAQ)
Q. AIの学習とは何ですか?
A. 出力と正解のずれを小さくする方向に、モデル内部のパラメータを繰り返し調整する工程です。大量の学習データと計算資源を必要とします。
Q. AIに話しかけると賢くなりますか?
A. なりません。会話の内容はその会話の中でのみ使われ、モデルの中身は変わりません。会話の内容が将来の学習に使われる場合もありますが、その場で反映されるわけではありません。
Q. 学習と推論の違いは何ですか?
A. 学習はデータからモデルを作る工程、推論はできあがったモデルで答えを出す工程です。学習は一度、推論は使うたびに走ります。
Q. 自社のデータでAIを学習させるべきですか?
A. 多くの場合は不要です。知識を扱う目的ならRAG、答え方を揃える程度ならプロンプトの指定で足ります。学習が必要になるのは、形式が厳密な場合や処理件数が膨大な場合です。
Q. 入力した内容が学習に使われるか確認する方法は?
A. サービスの規約と設定画面で確認します。既定の状態はサービスとプランで異なり、法人向けプランでは学習に使わないことが明示されていることが多くなります。
【参考】
文化庁「AIと著作権」
https://www.bunka.go.jp/seisaku/chosakuken/aiandcopyright.html
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報