2022年末以降のAIブームは、ほぼすべて生成AIの話です。
それまでのAIと何が違うのかを一度押さえておくと、次々に出てくる新しいサービスの位置づけが自分で判断できるようになります。
この記事では、生成AIの説明を5つのレベルに分けて並べました。
どこから読むか
この記事は、同じ用語を5つのレベルに分けて解説しています。
当てはまるものを選んで、そこから読み始めてください。
→ この言葉を今日はじめて見た … Level 1から読む(3分)
→ 言葉は知っているが、人には説明できない … Level 2から読む(5分)
→ 説明はできるが、仕組みまでは怪しい … Level 3から読む(8分)
→ 仕事で使うかどうかを判断したい … Level 4から読む(10分)
→ 実装する、または技術記事を原典で読む … Level 5から読む(10分)
迷ったらLevel 1から読んでください。
知っている内容なら、数十秒で通り過ぎます。
1分で腕試し
理解度から決めたい場合は、次の4問を試してください。
Q1〜Q4は、Level 1〜4の内容に1問ずつ対応しています。
最初にまちがえた問題のLevelが、あなたのスタート地点です。
4問とも正解なら、Level 5から読んでください。
各レベルの終わりにも、4択の理解度チェックがあります。
ITパスポート試験の過去問題も入れています。
AIという言葉そのものが曖昧だと感じる場合は、先にこちらを読んでください。
→ AIとは何か|子供向けから専門的な話まで5段階でわかる用語解説
Q1.【オリジナル】生成AIと、それまでのAIの違いとして、最も適切なものはどれか。
- ア 生成AIは答えを当て、それまでのAIは新しいものを作る
- イ 生成AIは計算が速く、それまでのAIは計算が遅い
- ウ 生成AIは新しいものを作り、それまでのAIは答えを当てるのが仕事だった
- エ 生成AIは間違えないが、それまでのAIは間違える
正解:ウ
解説:
「この写真はネコか」のように、答えがどこかにあって当てにいくのが、それまでのAIの仕事でした。
生成AIは、正解が最初からあるわけではない新しいものを作ります。
アは、説明が逆です。
イは、本文の説明とは関係がありません。
エは誤りです。生成AIは、作ったものが正しいかを確かめる仕組みを持っていません。
→ まちがえたら Level 1から
Q2.【オリジナル】生成AIへの指示(プロンプト)の書き方として、結果が安定しやすいものはどれか。
- ア 「いい感じにして」とだけ書く
- イ 「社内の会議用に、箇条書きで、専門用語を使わずに」と、相手・形式・してほしくないことを書く
- ウ できるだけ短く、1語だけで書く
- エ 同じ指示を何度もくり返して書く
正解:イ
解説:
誰に向けたものか、どんな形式か、どんな雰囲気か、してほしくないことを書くと、作るものを絞り込む材料が増えます。
アは、何が「いい感じ」かの材料がないので、結果が安定しません。
ウも、材料が足りません。
エは、材料が増えないので、くり返しても安定しません。
→ まちがえたら Level 2から
Q3.【オリジナル】文章の生成と画像の生成の作られ方の違いとして、最も適切なものはどれか。
- ア 文章は次に来るトークンを予測してつなげ、画像はノイズから少しずつ整えていく
- イ どちらも、ノイズから少しずつ整えていく
- ウ 文章はノイズから整え、画像は左上から1画素ずつ予測する
- エ どちらも、インターネット上にある文章や画像をそのまま貼り合わせている
正解:ア
解説:
文章は「左から順に足していく」作り方、画像は「全体を少しずつ整えていく」作り方です。
画像の主流は拡散モデルです。
イとウは誤りです。文章と画像で、作り方はまったく違います。
エは誤りです。学習した範囲の中で、新しい組み合わせを作っています。
→ まちがえたら Level 3から
Q4.【オリジナル】会社で生成AIを使うためのルールに書くべき4点として、本文で挙げていないものはどれか。
- ア 入力してよい情報の範囲
- イ 使ってよいサービスとプラン
- ウ 出力を外に出す前の確認
- エ 社員一人ひとりの1日の利用回数の上限
正解:エ
解説:
本文の4点は、ア、イ、ウと、生成物の権利の扱いです。
利用回数の上限は、本文で挙げていません。
→ まちがえたら Level 4から
各レベルの終わりにも理解度チェックがあります。
答えられたら次のレベルへ、分からなければ前のレベルに戻ってください。
AIという言葉そのものが曖昧だと感じる場合は、先にこちらを読んでください。
→ AIとは何か|子供向けから専門的な話まで5段階でわかる用語解説
Level 1 子供でもなんとなくわかる
ここはLevel 1です(全5レベル)
前提:なし。ここから読み始められます
想定読者:この言葉を今日はじめて見た人
このレベルのゴール:生成AIを「当てるのではなく、作るAI」だと自分の言葉で言える
当てるAIと、作るAI
これまでのAIは、当てるのが仕事でした。
- この写真はネコか、イヌか
- このメールは迷惑メールか、そうでないか
- 明日の売り上げはいくらか
どれも、答えがどこかにあって、それを当てにいく仕事です。
生成AIは、ここが違います。
答えを当てるのではなく、新しいものを作ります。
- お願いすると、物語を書いてくれる
- 「空を飛ぶ猫の絵」と言うと、その絵を描いてくれる
- 文字を打つと、その声で読み上げてくれる
どれも、正解が最初からあるわけではありません。
だから「生成」、つまり作り出すという名前がついています。
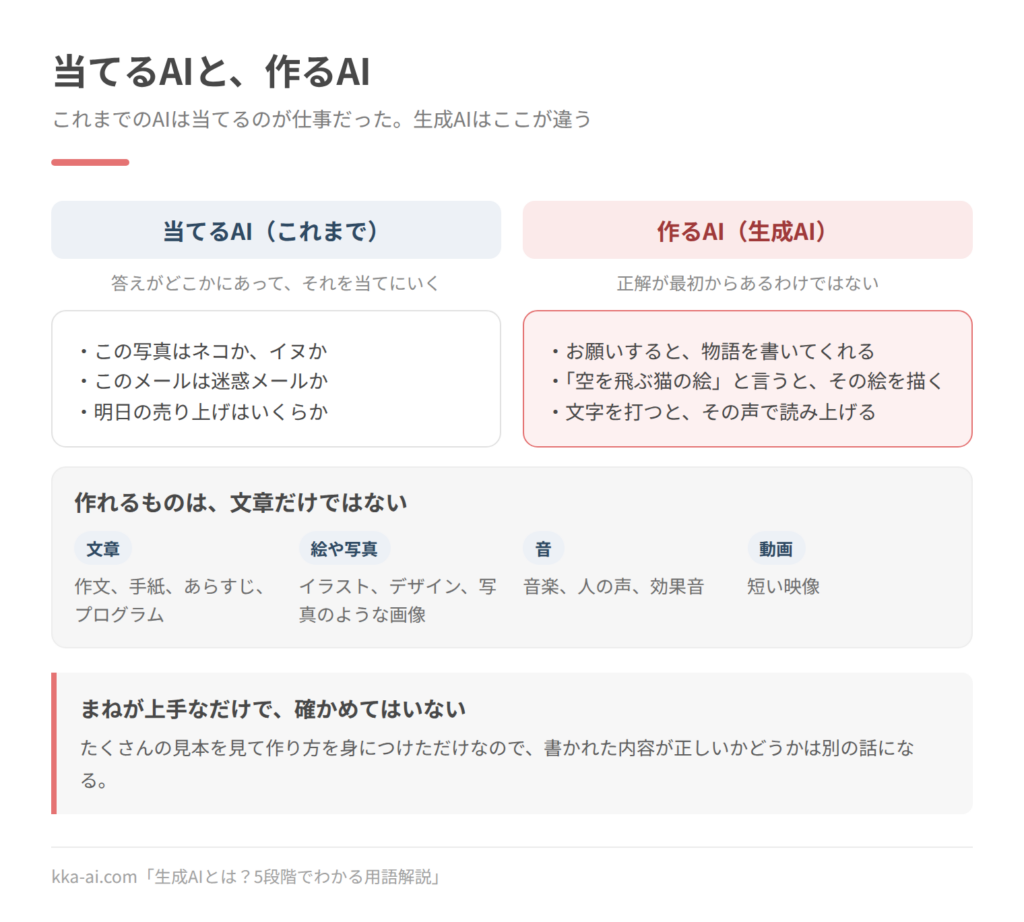
作れるものは、文章だけではない
生成AIが作れるものは、いろいろあります。
- 文章:作文、手紙、あらすじ、プログラム
- 絵や写真:イラスト、デザイン、写真のような画像
- 音:音楽、人の声、効果音
- 動画:短い映像
種類は違っても、やっていることは似ています。
どれも、たくさんの見本を見て、その作り方を身につけたのです。
まねが上手なだけで、確かめていない
ここが大事なところです。
生成AIは、たくさんの見本を見て、それっぽいものを作るのが得意です。
でも、作ったものが正しいかどうかを確かめる仕組みは持っていません。
だから、実在しない本の名前を答えたり、指が6本ある手の絵を描いたりします。
それっぽく見えるけれど、よく見ると違う。
生成AIの答えは、必ず人が確かめる。
これが使うときのいちばんのルールです。
つまずきポイント
「生成AIとAIは同じもの?」
違います。
AIのほうが大きい言葉で、生成AIはその中の新しい仲間です。
当てるAIは今も動いていて、迷惑メールの判定などで毎日活躍しています。
ここがあやふやなら、AIの記事のLevel 2を読んでください。
→ AIとは何か|子供向けから専門的な話まで5段階でわかる用語解説
理解度チェック
Q1.【オリジナル】次のうち、生成AIの仕事にあたるものはどれか。
- ア このメールが迷惑メールかどうかを判定する
- イ この写真がネコかイヌかを当てる
- ウ 「空を飛ぶ猫の絵」と頼まれて、その絵を描く
- エ 明日の売り上げがいくらになるかを予測する
正解:ウ
解説:
正解が最初からあるわけではない、新しいものを作るのが生成AIです。
ア、イ、エは、答えがどこかにあって、それを当てにいく仕事です。
→ Level 1「当てるAIと、作るAI」に戻る
Q2.【オリジナル】本文で、生成AIが作れるものとして挙げていないものはどれか。
- ア 作文や手紙、プログラム
- イ イラストや写真のような画像
- ウ 音楽や人の声
- エ 実際に食べられる料理
正解:エ
解説:
生成AIが作れるのは、文章、絵や写真、音、動画などの、コンピュータの中で扱えるものです。
レシピの文章は作れても、食べられる料理そのものは作れません。
ア、イ、ウは、本文で挙げた例です。
→ Level 1「作れるものは、文章だけではない」に戻る
Q3.【オリジナル】生成AIが作ったものを、必ず人が確かめる理由として、最も適切なものはどれか。
- ア 生成AIは、わざと間違えるように作られているから
- イ それっぽいものを作るのは得意でも、正しいかどうかを確かめる仕組みを持っていないから
- ウ 生成AIは、毎回まったく同じものしか作れないから
- エ 法律で、確かめた人の名前を書くことが決まっているから
正解:イ
解説:
実在しない本の名前を答えたり、指が6本ある手の絵を描いたりすることがあります。
アは誤りです。わざと間違えているのではありません。
ウは誤りです。毎回同じものになるとは限りません。
エは、本文で説明している理由ではありません。
→ Level 1「まねが上手なだけで、確かめていない」に戻る
Q4.【オリジナル】生成AIとAIの関係として、最も適切なものはどれか。
- ア 生成AIとAIは、まったく同じものを指す
- イ 生成AIが登場したので、当てるAIはもう使われていない
- ウ 生成AIのほうが大きい言葉で、AIはその中の一部である
- エ AIのほうが大きい言葉で、生成AIはその中の新しい仲間である
正解:エ
解説:
当てるAIも今も動いていて、迷惑メールの判定などで毎日使われています。
アは誤りです。同じものではありません。
イは誤りです。当てるAIも使われ続けています。
ウは、大きさが逆です。
→ Level 1「つまずきポイント」に戻る
Q5.【オリジナル】生成AIが、作り方を身につけた方法として、本文の説明に最も近いものはどれか。
- ア 人間が、作り方の手順をすべて書いて教えた
- イ たくさんの見本を見て、その作り方を身につけた
- ウ 1つの見本だけを見て、それをくり返しまねしている
- エ 作るたびに、インターネットで作り方を調べている
正解:イ
解説:
文章でも絵でも音でも、種類は違ってもやっていることは似ています。
アは、ルールを書く作り方で、生成AIの学び方ではありません。
ウは誤りです。1つの見本だけでは、新しいものは作れません。
エは誤りです。作るたびに調べているわけではありません。
→ Level 1「作れるものは、文章だけではない」に戻る
ここまで読めば言えるようになること
- 当てるAIと作るAIの違いを説明できる
- 生成AIが作れるものを3種類挙げられる
- 出力を確かめる必要がある理由を言える
言えたら、Level 2へ進む。
Level 2 少し理解できる
ここはLevel 2です(全5レベル)
前提:Level 1の内容(当てるAIと作るAIの違い)
想定読者:言葉は知っているが、人には説明できない人
このレベルのゴール:代表的なサービスの種類を区別でき、使うときの注意点を自分で説明できる
種類ごとに、別のサービスがある
生成AIは、作るものによってサービスが分かれています。
文章を作るものが、最もよく使われています。
ChatGPT、Claude、Geminiなどが代表的で、中で動いているのがLLM(大規模言語モデル)です。
→ LLM(大規模言語モデル)とは|5段階でわかる用語解説
画像を作るものは、文章で指示すると絵が出てくるサービスです。
「夕暮れの海辺、水彩画風」のように書くと、その通りの画像が生成されます。
音声を作るものは、文字を読み上げたり、音楽を作ったりします。
動画を作るものは、文章や画像から短い映像を作ります。
種類の中では最も新しく、変化が速い分野です。
最近は、一つのサービスが複数の種類を扱うことも増えています。
画像を見せて質問できる、文章から画像を作れる、といった形です。
この、複数の種類の情報を扱える性質をマルチモーダルと呼びます。
何と言うかで、出てくるものが変わる
生成AIへの指示文をプロンプトと呼びます。
生成AIは指示された内容に沿ってものを作るので、プロンプトの書き方で結果が大きく変わります。
効くのは、次のような具体化です。
- 誰に向けたものか(小学生向け、社内の会議用)
- どんな形式か(箇条書き、800字、表)
- どんな雰囲気か(丁寧に、くだけた調子で、水彩画風に)
- してほしくないこと(専門用語を使わない、文字を入れない)
「いい感じにして」では、何が「いい感じ」かの材料がないので、結果が安定しません。
→ プロンプトとは?生成AIで必須の用語の意味と、初心者が最初に覚える「1つの型」を解説
3つの注意点
生成AIを使うときは、次の3つを覚えておくと事故を避けられます。
ハルシネーションは、事実でないことをもっともらしく答える現象です。
存在しない本や法律の条文、実在しない人物の経歴が出てくることがあります。
名前、数字、日付、出典は、必ず自分で確かめます。
入力した情報の扱いにも注意が要ります。
サービスとプランによっては、入力した内容が学習に使われる設定になっていることがあります。
他人の個人情報や、会社の未公開情報は入れないのが基本です。
著作権の問題もあります。
生成されたものが既存の作品に似てしまう可能性があり、そのまま公開してよいかは場合によります。
学校の宿題や仕事で使う場合は、使ってよい範囲をあらかじめ確認してください。
つまずきポイント
「生成AIは検索の代わりになる?」
なりません。
検索は、実在するページを探して見せる仕組みです。
生成AIは、覚えた内容から答えを組み立てる仕組みで、出典を持っていません。
最近は検索機能を組み合わせたサービスもありますが、その機能が働いているかは画面で確認する必要があります。
理解度チェック
Q1.【IPA過去問】生成AIに関する記述として,最も適切なものはどれか。
- ア 一切の学習を必要とせずに,新しいコンテンツを生成する。
- イ 過去のデータから項目間の相関などを学習したモデルを用いて,現在のデータから将来の値を予測して出力する。
- ウ 作成したシナリオに基づいて動作するソフトウェアロボットによって,業務を自動化する。
- エ 自然言語で指示された内容に従って,事前に学習したデータを基に,新しいコンテンツを生成する。
出典:令和7年度 ITパスポート試験 公開問題 問28
正解:エ
解説:
「指示に従って」「事前に学習したデータを基に」「新しいコンテンツを生成」の3つがそろっているのがエです。
アは誤りです。生成AIも、たくさんの見本で学習しています。
イは、将来の値を当てる「予測」の説明で、Level 1でいう「当てるAI」の側です。
ウは、RPAの説明です。
→ Level 2「種類ごとに、別のサービスがある」に戻る
Q2.【オリジナル】マルチモーダルの説明として、最も適切なものはどれか。
- ア 1つのサービスが、文章、画像、音声など複数の種類の情報を扱える性質
- イ 1つのサービスを、複数の人で同時に使える性質
- ウ 文章だけを、複数の言語に訳せる性質
- エ 同じ指示から、毎回ちがう答えを出す性質
正解:ア
解説:
画像を見せて質問できる、文章から画像を作れる、といった形が当てはまります。
イは、同時に使える人数の話です。
ウは、翻訳の話で、扱う情報の種類は文章だけです。
エは、出力のゆらぎの話です。
→ Level 2「種類ごとに、別のサービスがある」に戻る
Q3.【オリジナル】生成AIを使うときの3つの注意点として、本文で挙げていないものはどれか。
- ア ハルシネーション(事実でないことをもっともらしく答える)
- イ 入力した情報の扱い
- ウ 著作権
- エ 使える時間帯が決まっていること
正解:エ
解説:
本文の3つは、ア、イ、ウです。
名前、数字、日付、出典は必ず自分で確かめる、他人の個人情報や会社の未公開情報は入れない、使ってよい範囲を先に確かめる、が具体的な行動です。
エは、本文で挙げていません。
→ Level 2「3つの注意点」に戻る
Q4.【オリジナル】「生成AIは検索の代わりになるか」について、本文の説明として最も適切なものはどれか。
- ア なる。生成AIは、実在するページを探して見せる仕組みだから
- イ ならない。生成AIは覚えた内容から答えを組み立てる仕組みで、出典を持っていないから
- ウ なる。生成AIの答えには、必ず出典が付いているから
- エ ならない。生成AIは、文章を扱えないから
正解:イ
解説:
検索は、実在するページを探して見せる仕組みです。
検索機能を組み合わせたサービスもありますが、その機能が働いているかは画面で確かめる必要があります。
アは、検索の説明です。
ウは誤りです。出典が付くとは限りません。
エは誤りです。文章を作るのが、いちばんよく使われている生成AIです。
→ Level 2「つまずきポイント」に戻る
Q5.【オリジナル】会社で生成AIを使うとき、入力しないのが基本とされている情報はどれか。
- ア 一般に公開されている、自社の会社案内の文章
- イ 自分で書いた、社外に出す前の文章の下書きの言い回し
- ウ 他人の個人情報や、会社の未公開情報
- エ 新聞に載っていた、公開済みのニュースの見出し
正解:ウ
解説:
サービスとプランによっては、入力した内容が学習に使われる設定になっていることがあります。
ア、エは、すでに公開されている情報です。
イも、個人情報や未公開情報を含まなければ、本文の「入れない」の対象ではありません。
入れてよい範囲は、会社のルールで確かめます(Level 4)。
→ Level 2「3つの注意点」に戻る
ここまで読めば言えるようになること
- 作るものの種類でサービスが分かれていると説明できる
- マルチモーダルという言葉を使える
- プロンプトで効く要素を4つ挙げられる
- 3つの注意点を説明できる
言えたら、Level 3へ進む。
Level 3 もう少し詳しく
ここはLevel 3です(全5レベル)
前提:Level 2までの内容(サービスの種類、プロンプト、3つの注意点)
想定読者:人に説明はできるが、仕組みまでは怪しい人
このレベルのゴール:文章と画像で作られ方が違うことを説明でき、生成AIが急に伸びた理由を語れる
文章はどう作られるか
文章の生成は、続きの予測の繰り返しです。
LLMは、これまでの文脈から次に来るトークン(単語や単語のかけら)を確率的に予測し、選んでつなげます。
これを繰り返すことで、人間が書いたような文章ができあがります。
重要なのは、意味を人間のように理解して書いているのではなく、統計的にもっともらしい続きを組み立てているという点です。
ハルシネーションが起きるのは、この方式の帰結です。
「知らない」を検出して黙る仕組みが、そもそも含まれていません。
→ LLM(大規模言語モデル)とは|5段階でわかる用語解説
→ ハルシネーションとは|5段階でわかる用語解説
画像はどう作られるか
画像の生成は、文章とはまったく別の作り方をします。
現在の主流が拡散モデルです。
考え方は、ノイズからの復元です。
学習のとき、画像に少しずつノイズを加えていき、最後は完全な砂嵐にします。
そのうえで、砂嵐から一段階ずつノイズを取り除いて元に戻す手順を学ばせます。
生成のときは、砂嵐から始めます。
そこに「夕暮れの海辺」という指示を条件として与えながら、ノイズを取り除いていく。
すると、その指示に沿った画像が浮かび上がってきます。
文章が「左から順に足していく」作り方なのに対し、画像は「全体を少しずつ整えていく」作り方です。
この違いを押さえておくと、画像生成で部分的な修正が効きにくい理由も見当が付きます。
なぜ急に実用の水準に届いたのか
生成AIの研究自体は以前からありましたが、実用の水準に届いたのは2020年代です。
理由は3つに整理できます。
一つは、2017年のトランスフォーマーによって、大量のテキストを並列に学習できるようになったことです。
二つ目は、ラベルのない大量のデータから学習する枠組みが確立したことです。
文章の続きを当てるという課題を立てれば、ウェブ上の文章がそのまま学習データになります。
三つ目は、事後学習によって、指示に従う形に整えられるようになったことです。
三つ目が、一般の利用者にとっては決定的でした。
事前学習を終えただけのモデルは、指示に従わず文章の続きを書き続けるだけです。
これを対話の相手として使える形に整えたことで、専門家以外にも使えるものになりました。
何が得意で、何が苦手か
生成AIの得意と苦手は、仕組みから予測できます。
得意なものは、正解が一つに定まらず、たたき台があると助かる作業です。
文章の下書き、要約、言い換え、翻訳、アイデアの列挙、形式の変換。
どれも、人が最後に選んで直すことを前提にできます。
苦手なものは、正確さが一意に求められる作業です。
計算、最新の事実の確認、法令や規約の正確な引用、固有名詞の詳細。
これらは、外部のツールや検索と組み合わせるか、人が確認する前提で使います。
「AIに何をさせるか」ではなく「AIに下書きを作らせて、人が何を確認するか」と考えると、使いどころが定まります。
つまずきポイント
「生成AIは創造しているのか」
学習したデータの分布から新しい組み合わせを作り出しており、既存の作品をそのまま貼り合わせているわけではありません。
一方で、学習していない発想が出てくるわけでもありません。
創造という言葉をどう定義するかの問題になるため、この記事では「学習した範囲の中で新しい組み合わせを作る」という説明にとどめます。
理解度チェック
Q1.【オリジナル】LLMが文章を作るときに繰り返していることとして、最も適切なものはどれか。
- ア これまでの文脈から次に来るトークンを確率的に予測して、つなげる
- イ インターネットから、近い文章をそのまま持ってくる
- ウ 文章全体のノイズを、少しずつ取り除いていく
- エ 意味を人間のように理解し、言いたいことを決めてから一気に書く
正解:ア
解説:
統計的にもっともらしい続きを組み立てている、という点が大事です。
ハルシネーションは、この方式から来ています。
エは誤りです。人間のように理解して書いているわけではありません。
イは誤りです。そのまま持ってきているわけではありません。
ウは、画像の作り方(拡散モデル)の説明です。
→ Level 3「文章はどう作られるか」に戻る
Q2.【オリジナル】拡散モデルによる画像の生成の説明として、最も適切なものはどれか。
- ア 左上から1画素ずつ、次の色を予測して並べる
- イ 砂嵐のようなノイズから始め、指示を条件として与えながら、ノイズを少しずつ取り除いていく
- ウ 写真のデータベースから、指示に最も近い写真を探して出す
- エ 人間が描いた下絵に、色だけを塗る
正解:イ
解説:
学習のときは、画像に少しずつノイズを加えて砂嵐にし、そこから元に戻す手順を学ばせます。
生成のときは、砂嵐から始めて、指示に沿うようにノイズを取り除きます。
アは、文章の作り方に近い発想で、画像の主流の方式ではありません。
ウは、検索の説明です。
エは、本文の説明とは関係がありません。
→ Level 3「画像はどう作られるか」に戻る
Q3.【オリジナル】生成AIが2020年代に実用の水準に届いた理由として、本文で挙げていないものはどれか。
- ア トランスフォーマーで、大量のテキストを並列に学習できるようになった
- イ ラベルのない大量のデータから学習する枠組みが確立した
- ウ 事後学習によって、指示に従う形に整えられるようになった
- エ 生成AIが、出力の正しさを自分で確かめる仕組みを持った
正解:エ
解説:
エは誤りです。生成AIは今も、正しさを確かめる仕組みを持っていません。
ア、イ、ウが、本文で挙げた3つの理由です。
→ Level 3「なぜ急に実用の水準に届いたのか」に戻る
Q4.【オリジナル】事前学習を終えただけのモデルについて、最も適切なものはどれか。
- ア 指示に従わず、文章の続きを書き続けるだけで、対話の相手としては使いにくい
- イ すでに、どんな指示にも正確に従える
- ウ 画像しか扱えない
- エ 文章を1文字も作れない
正解:ア
解説:
事後学習で、対話の相手として使える形に整えたことが、一般の利用者にとって決定的でした。
イは誤りです。指示に従う形に整えるのが、事後学習の役割です。
ウとエは、本文の説明とは関係がありません。
→ Level 3「なぜ急に実用の水準に届いたのか」に戻る
Q5.【オリジナル】生成AIに向いている作業として、本文の説明に最も合うものはどれか。
- ア 法令の条文を、一字一句正確に引用する
- イ 最新の出来事が事実かどうかを確認する
- ウ 長い文章を要約して、人が最後に選んで直す
- エ 複雑な計算を、確認なしで最終結果にする
正解:ウ
解説:
得意なのは、正解が一つに定まらず、たたき台があると助かる作業です。
ア、イ、エは、正確さが一意に求められる作業で、苦手な側です。
外部のツールや検索と組み合わせるか、人が確かめる前提で使います。
→ Level 3「何が得意で、何が苦手か」に戻る
ここまで読めば言えるようになること
- 文章と画像で生成の仕組みが違うと説明できる
- 拡散モデルの考え方を説明できる
- 生成AIが実用水準に届いた理由を3つ挙げられる
- 得意と苦手を仕組みから説明できる
仕事で導入やルール整備に関わるなら、Level 4へ進む。
Level 4 ビジネスで使う
ここはLevel 4です(全5レベル)
前提:Level 3までの内容(文章と画像の作られ方、得意と苦手)
想定読者:仕事で使うかどうかを判断したい人
このレベルのゴール:導入の順序とルールの骨子を、自社の状況に合わせて設計できる
導入が止まる理由は、たいてい使いどころ
総務省の「令和8年版 情報通信白書」によると、生成AIの活用方針を定めている日本企業は、2025年度の調査で68.9%でした。 前年度の49.7%から増えています。「積極的に活用する」と「活用する領域を限定して利用する」を合わせた割合です。 活用しない理由の上位には「適切な活用方法が分からない」が挙がっています(令和7年版)。
つまり、多くの企業はセキュリティやコストで止まっているのではなく、その手前の使いどころで止まっています。
使いどころは、工程で探す
「生成AIで何ができるか」から入ると、できることの一覧を眺めて終わります。
業務を工程に分解し、次の2種類を探すほうが早く見つかります。
- 毎回ゼロから書き起こしている工程(メールの下書き、報告書の初稿、議事録の整形)
- 形式を変換しているだけの工程(長い資料の要約、箇条書きから文章へ、日本語から英語へ)
どちらも、たたき台を出させて人が直す形に置き換えられます。
逆に、判断そのものを任せる工程には向きません。
導入は4段階で考える
- 個人が有料プランを使う:月額数千円。手軽だが、入力内容の扱いと統制が課題
- 法人プランやチーム向けプランを契約する:一人あたり月額数千円。管理者機能があり、入力を学習に使わない設定を組織単位で適用できる
- APIを自社システムに組み込む:従量課金。既存の業務システムやチャットツールに組み込む
- RAGで社内文書に答えさせる:数十万円から数百万円規模。文書の整備が前提
→ APIとは|5段階でわかる用語解説
→ RAGとは|5段階でわかる用語解説
多くの企業は上の2つで効果を確かめてから下に降りる順序が無難です。
社内ルールに書くべきこと
規程を作るときは、次の4点を書き分けてください。
入力してよい情報の範囲。
顧客の個人情報、未公開の財務情報、秘密保持契約の対象資料をどう扱うか。
判断に迷ったら入れない、という原則を添えます。
使ってよいサービスとプラン。
入力が学習に使われるかは、サービスとプランで異なります。
一覧にして、それ以外は申請制にするのが実務的です。
出力を外に出す前の確認。
誰が、どの段階で、何を確認するかを既存の承認フローに組み込みます。
事実関係、数値、固有名詞、引用元の4点を確認項目にすると漏れが減ります。
生成物の権利の扱い。
外部に出す制作物に生成AIを使う場合の可否と、使った場合の記録の残し方を決めます。
使われない、を避ける
告知だけして使われない、というのが最も多い失敗です。
効いたのは、次の3つです。
一つは、自社の業務に即したプロンプトの例を10個ほど用意して配ること。
「議事録を要約する」ではなく、自社の会議体の名前と出力形式まで書いた具体例です。
二つ目は、部署ごとに使い方を持ち寄る場を作ること。
うまくいった例が横に伝わると、利用が定着します。
三つ目は、禁止事項だけの案内にしないことです。
できないことの一覧から入ると、使わないのが最も安全という結論になります。
効果はどう測るか
導入の効果は、次の形で測ると報告に耐えます。
- 対象工程を決める(週次報告の作成、問い合わせ一次回答の作成など)
- 導入前の所要時間を実測する
- 導入後の所要時間を、同じ人が同じ作業で実測する
- 品質が落ちていないことを、確認者の手戻り件数で見る
時間だけを見ると、品質の低下が見えません。
手戻り件数を併せて見るのが要点です。
つまずきポイント
「情報漏洩が心配で、導入に踏み切れない」
懸念は、2つに分けると整理できます。
一つは、入力した内容が学習に使われることへの懸念で、これは法人向けプランの規約と設定で対処できます。
もう一つは、従業員が個人アカウントで無断利用することへの懸念で、これは正規の手段を提供しないほうが起きやすくなります。
禁止だけでは、見えないところでの利用が増えます。
理解度チェック
Q1.【オリジナル】生成AIの使いどころを探すとき、本文で勧めている探し方はどれか。
- ア 生成AIでできることの一覧を作り、上から順に試す
- イ 業務を工程に分け、毎回ゼロから書き起こしている工程と、形式を変換しているだけの工程を探す
- ウ 判断そのものを任せられる工程を探す
- エ いちばん重要な取引先とのやり取りから始める
正解:イ
解説:
どちらの工程も、たたき台を出させて人が直す形に置き換えられます。
アは、できることの一覧を眺めて終わる、と本文で書いているやり方です。
ウは逆です。判断そのものを任せる工程には向きません。
エは、失敗したときの影響が大きい使い方です。
→ Level 4「使いどころは、工程で探す」に戻る
Q2.【オリジナル】本文の導入の4段階のうち、多くの企業が最初に効果を確かめる段階として勧めているものはどれか。
- ア RAGで社内文書に答えさせる
- イ APIを自社システムに組み込む
- ウ 個人の有料プランや、法人・チーム向けプランで使う
- エ 自社専用のモデルをゼロから作る
正解:ウ
解説:
上の2つ(個人の有料プラン、法人やチーム向けプラン)で効果を確かめてから、下に降りる順序が無難です。
アとイは、その後の段階です。
エは、本文の4段階に入っていません。
→ Level 4「導入は4段階で考える」に戻る
Q3.【オリジナル】出力を外に出す前の確認で、本文が確認項目にすると漏れが減るとした4点の組み合わせはどれか。
- ア 事実関係、数値、固有名詞、引用元
- イ 文字数、フォント、色、行間
- ウ 作った人の名前、作った日時、使った時間、使った端末
- エ 誤字、句読点、敬語、改行
正解:ア
解説:
生成AIが間違えやすいのは、事実、数字、名前、出典です。
イとエは、見た目や表記の確認で、生成AIに特有の誤りを拾う項目ではありません。
ウは、記録として残すことはあっても、出力の中身の確認ではありません。
→ Level 4「社内ルールに書くべきこと」に戻る
Q4.【オリジナル】導入の効果を測るとき、時間の短縮と併せて見るべきものとして、本文で挙げているものはどれか。
- ア 生成AIに入力した文字数
- イ 確認者の手戻り件数
- ウ 社員の満足度アンケートの点数
- エ 生成AIのサービスの利用料金
正解:イ
解説:
時間だけを見ると、品質の低下が見えません。
同じ人が同じ作業で、導入前と導入後の時間を実測し、手戻り件数を併せて見ます。
ア、ウ、エは、本文で挙げた指標ではありません。
→ Level 4「効果はどう測るか」に戻る
Q5.【オリジナル】情報漏洩が心配で、生成AIを全面禁止にした会社で起きやすいこととして、本文の説明に最も近いものはどれか。
- ア 正規の手段がないため、個人アカウントでの無断利用が増え、見えないところでの利用が広がる
- イ 社員が生成AIのことを忘れる
- ウ 業務の効率が自然に上がる
- エ 情報漏洩の心配が、完全になくなる
正解:ア
解説:
入力が学習に使われる懸念は、法人向けプランの規約と設定で対処できます。
個人アカウントでの無断利用は、正規の手段を提供しないほうが起きやすくなります。
エは誤りです。見えないところでの利用が増えれば、むしろ管理できなくなります。
イとウは、本文の説明とは関係がありません。
→ Level 4「つまずきポイント」に戻る
ここまで読めば言えるようになること
- 使いどころを工程から探せる
- 導入の4段階と費用感を説明できる
- 社内ルールの4項目を自社向けに書ける
- 効果測定の設計ができる
実装に踏み込むなら、Level 5へ進む。
Level 5 専門的な話
ここはLevel 5です(全5レベル)
前提:Level 4までの内容
想定読者:実装する人、技術記事を原典で読みたい人
このレベルのゴール:生成モデルの系譜を整理し、モダリティごとの手法の違いを説明できる
生成モデルの系譜
生成モデルは、データの分布を学習し、そこから標本を得る枠組みです。
系譜としては次のものが挙げられます。
変分オートエンコーダ(VAE)は、潜在変数を介した確率的な生成を、変分下界の最大化として定式化します。
学習は安定する一方、生成物がぼやけやすい傾向があります。
敵対的生成ネットワーク(GAN)は、生成器と識別器を競わせる枠組みです。
鮮明な画像を生成できる一方、学習の不安定さとモード崩壊が課題でした。
自己回帰モデルは、系列を条件付き確率の積に分解し、順に生成します。
テキスト生成の主流であり、トランスフォーマーと組み合わせてLLMを構成します。
拡散モデルは、データにノイズを加える前向き過程と、それを逆にたどる逆過程を学習します。
画像生成では、学習の安定性と品質の両面でGANに置き換わりました。
拡散モデルの実装上の要点
拡散モデルは、逆過程の各ステップでノイズを予測するネットワークを学習します。
条件付けは、テキスト埋め込みを交差注意で注入する形が一般的です。
生成の品質と多様性の釣り合いは、条件なしと条件ありの予測を外挿する分類器不要ガイダンスの強度で制御します。
強度を上げると指示への忠実さが増し、多様性は下がります。
計算量の削減には、潜在空間で拡散を行う潜在拡散が使われます。
画素空間ではなく、オートエンコーダで圧縮した潜在表現の上で拡散を行うことで、解像度に対する計算量を大幅に下げられます。
サンプリングのステップ数削減も進み、数ステップでの生成が実用になっています。
テキスト生成の制御
自己回帰生成では、各ステップの確率分布からどう選ぶかが出力の性質を決めます。
温度は分布の鋭さを制御し、上位k個に絞る方式や累積確率で絞る方式は裾の候補を切ります。
決定的な出力が要る用途では温度を下げますが、繰り返しが増える傾向があるため、繰り返しへの罰則と組み合わせます。
構造化された出力が必要な場合は、文法制約付きのデコーディングによって、生成の各ステップで許容されるトークンを制限する方法が有効です。
JSONスキーマに従う出力を確実に得たい場合、後段の検証と再試行より確実性が高くなります。
評価
生成物の評価は、判別タスクに比べて難しい問題です。
画像では、特徴空間での分布間距離を測る指標が使われてきましたが、人間の知覚との相関には限界があります。
テキストでは、参照文との重なりを測る古典的な指標が、生成の多様性を評価できません。
現在は、より高性能なモデルに評価させる方式が広く使われますが、評価側のモデルの偏り(自らの出力形式を好む、長い出力を好む)が知られています。
最終的には、用途に即した人手評価の設計が要ります。
出所の識別
生成物であることを示す技術として、電子透かしと来歴情報の付与が進んでいます。
画像では、生成時に知覚されにくい信号を埋め込む方式と、コンテンツの来歴をメタデータとして署名付きで記録する方式があります。
テキストでは、生成時のトークン選択に統計的な偏りを埋め込む方式が研究されていますが、書き換えに対する頑健性は限定的です。
各国で生成物の表示に関する規制の議論が進んでおり、実装側でも対応が求められつつあります。
→ AI倫理・AIガバナンスとは|AIとどう付き合うかのルール作り
理解度チェック
Q1.【オリジナル】生成モデルの系譜と特徴の組み合わせとして、最も適切なものはどれか。
- ア VAE:鮮明な画像を作れるが、モード崩壊が課題
- イ GAN:学習は安定するが、生成物がぼやけやすい
- ウ 自己回帰モデル:ノイズを加える過程と、それを逆にたどる過程を学習する
- エ 拡散モデル:学習の安定性と品質の両面で、画像生成ではGANに置き換わった
正解:エ
解説:
アとイは、VAEとGANの説明が入れ替わっています。VAEは学習が安定する一方ぼやけやすく、GANは鮮明だが学習が不安定でモード崩壊が課題でした。
ウは、拡散モデルの説明です。自己回帰モデルは、系列を条件付き確率の積に分解して、順に生成します。
→ Level 5「生成モデルの系譜」に戻る
Q2.【オリジナル】分類器不要ガイダンスの強度を上げたときに起きることとして、最も適切なものはどれか。
- ア 指示への忠実さが増し、多様性は下がる
- イ 指示への忠実さも、多様性も上がる
- ウ 指示への忠実さが下がり、多様性が上がる
- エ 生成にかかるステップ数が、必ず半分になる
正解:ア
解説:
条件なしと条件ありの予測を外挿する強度で、品質と多様性の釣り合いを制御します。
イとウは、釣り合いの向きを取り違えています。
エは、ステップ数の削減とは別の話です。
→ Level 5「拡散モデルの実装上の要点」に戻る
Q3.【オリジナル】潜在拡散が計算量を大きく下げられる理由として、最も適切なものはどれか。
- ア 画像の解像度を、最初から半分にしているから
- イ 学習に使う画像の枚数を減らしているから
- ウ 画素空間ではなく、オートエンコーダで圧縮した潜在表現の上で拡散を行うから
- エ ノイズを加える過程を省略しているから
正解:ウ
解説:
圧縮した表現の上で拡散を行うので、解像度に対する計算量を大幅に下げられます。
アは、画質を落とす話で、潜在拡散の仕組みではありません。
イは、学習の量の話で、生成の計算量とは別です。
エは誤りです。前向き過程と逆過程を学習するのが、拡散モデルの基本です。
→ Level 5「拡散モデルの実装上の要点」に戻る
Q4.【オリジナル】JSONスキーマに従う出力を確実に得たいとき、本文で後段の検証と再試行より確実性が高いとした方法はどれか。
- ア 温度を上げて、いろいろな出力を試す
- イ 文法制約付きのデコーディングで、生成の各ステップで許容されるトークンを制限する
- ウ 上位k個に絞る方式で、裾の候補を切る
- エ 出力を長くするよう指示する
正解:イ
解説:
各ステップで、形式に合わないトークンを最初から選べないようにする方法です。
アは逆です。温度を上げると、出力のばらつきが大きくなります。
ウは、裾の候補を切る方法で、形式を守らせる仕組みではありません。
エは、形式とは関係がありません。
→ Level 5「テキスト生成の制御」に戻る
Q5.【オリジナル】高性能なモデルに生成物を評価させる方式で、知られている偏りとして本文で挙げているものはどれか。
- ア 短い出力を好む
- イ 他社のモデルの出力形式を好む
- ウ 自らの出力形式を好み、長い出力を好む
- エ 日本語の出力だけを高く評価する
正解:ウ
解説:
評価側のモデルにも偏りがあるので、最終的には用途に即した人手評価の設計が要ります。
アは、向きが逆です。
イは誤りです。好むのは、自らの出力形式です。
エは、本文で挙げた偏りではありません。
→ Level 5「評価」に戻る
ここまで読めば言えるようになること
- 生成モデルの4系譜を挙げ、特徴を説明できる
- 拡散モデルのガイダンスと潜在拡散を説明できる
- デコーディングの制御方法を用途に応じて選べる
- 生成物の評価と出所識別の限界を説明できる
まとめ
生成AIは、判別ではなく生成を行うAIの総称です。
Level 1では、当てるのではなく作るAI。
Level 2では、作るものごとにサービスが分かれ、プロンプトで結果が変わる道具。
Level 3では、文章は続きの予測、画像はノイズからの復元という別の仕組みで動くもの。
Level 4では、工程に当てて効果を測り、ルールを整えて使う対象。
Level 5では、複数の系譜を持ち、評価と出所識別に課題を残す技術。
どのレベルでも共通するのは、生成AIが正しさではなくもっともらしさを出しているという点です。
確認する工程を業務に組み込めるかどうかが、実務での成否を分けます。
次に読む記事
→ AIとは何か|子供向けから専門的な話まで5段階でわかる用語解説
→ LLM(大規模言語モデル)とは|5段階でわかる用語解説
→ ハルシネーションとは|5段階でわかる用語解説
→ マルチモーダルAIとは|5段階でわかる用語解説
→ ディープフェイクの見分け方|本物か確かめる5つの手順を、5段階でわかる用語解説
→ 今さら聞けないAI用語30選|初心者でもニュースが読めるようになる意味と読み方
この記事を書いた人:kkazuki|AI/DX分野ブログ運営者 → 運営者情報
よくある質問(FAQ)
Q. 生成AIとは何ですか?
A. 文章、画像、音声、動画などを新しく作り出すAIの総称です。答えを当てる従来のAIに対し、正解が一つに定まらないものを生成する点が異なります。
Q. 生成AIとAIの違いは何ですか?
A. AIは技術の総称で、生成AIはその中の一分野です。迷惑メール判定のような判別を行うAIも、今も広く使われています。
Q. 生成AIとLLMの違いは何ですか?
A. 生成AIは作り出すAIの総称で、LLMはそのうちテキストを担う中核の技術です。画像生成には拡散モデルという別の仕組みが使われます。
Q. 生成AIが事実でないことを答えるのはなぜですか?
A. 統計的にもっともらしい続きを組み立てる方式であり、知らないことを検出して黙る仕組みを持たないためです。この現象をハルシネーションと呼びます。
Q. 生成AIで作ったものを仕事に使ってよいですか?
A. サービスごとに規約が異なり、無料であることと商用利用の可否は別です。生成物が既存の作品に類似する可能性もあるため、外部に出す制作物では確認の工程が要ります。
参考
- 総務省「令和8年版 情報通信白書 企業におけるAI利用」(2026年7月公表、2025年度調査)
- 総務省・経済産業省「AI事業者ガイドライン(第1.2版)」(令和8年3月31日)